powered by 
Ein Programm kann entscheiden, ohne eine Regel zu kennen: Es sieht nach, wie bei den Beispielen entschieden wurde, die dem neuen Fall am ähnlichsten sind. Du schreibst so ein Programm, erst für Pinguine, dann für einen Fahrradverleih, der wissen will, wer eine Kaution zahlen soll. Dabei siehst du, was das Programm aus alten Entscheidungen übernimmt, auch das, was daran falsch war.
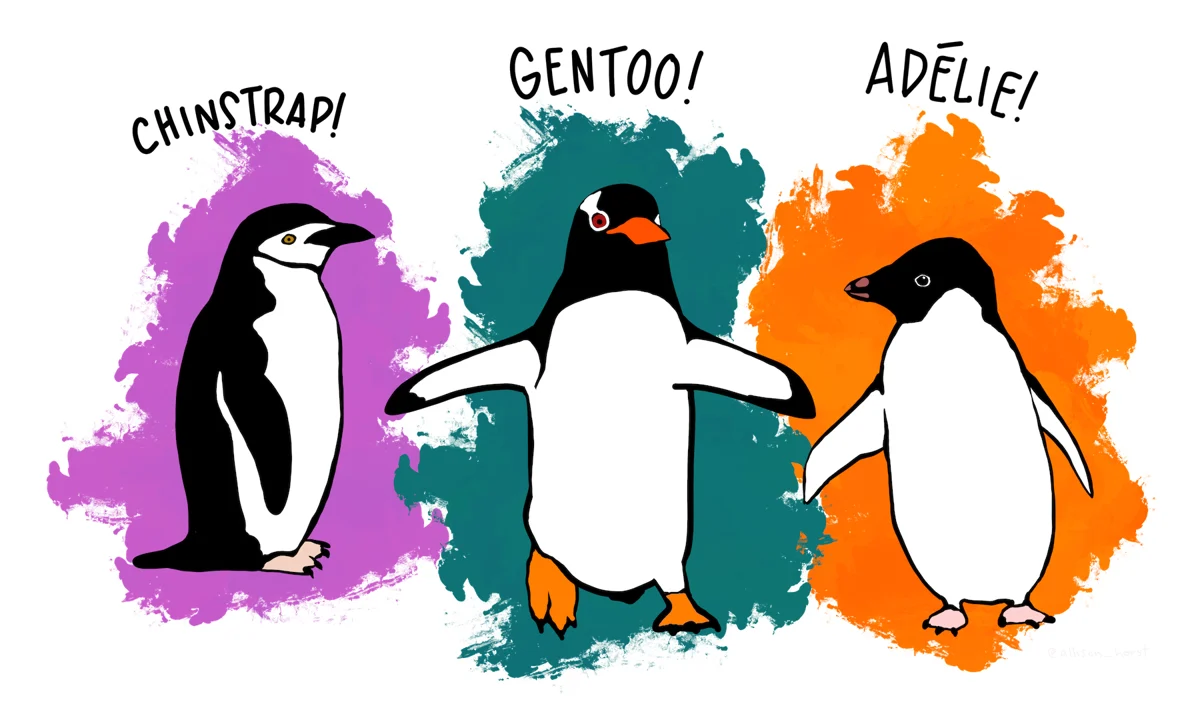
Auf den Inseln vor der Antarktischen Halbinsel leben drei Arten von Pinguinen: der Adéliepinguin, der Zügelpinguin (englisch Chinstrap) und der Eselspinguin (Gentoo). Die Biologin Kristen Gorman hat an 342 von ihnen die Länge und die Höhe des Schnabels gemessen, in Millimetern.
Jemand misst einen weiteren Pinguin, aber schreibt die Art nicht dazu. Welcher Art er ist, lässt sich raten, ohne eine Regel zu kennen: Man sucht unter den 342 bekannten Pinguinen die, deren Schnabel seinem am ähnlichsten ist, und nimmt die Art, die unter ihnen am häufigsten ist. Das sind seine nächsten Nachbarn, und das Verfahren heißt danach: k nächste Nachbarn, wobei k sagt, wie viele Nachbarn gefragt werden.
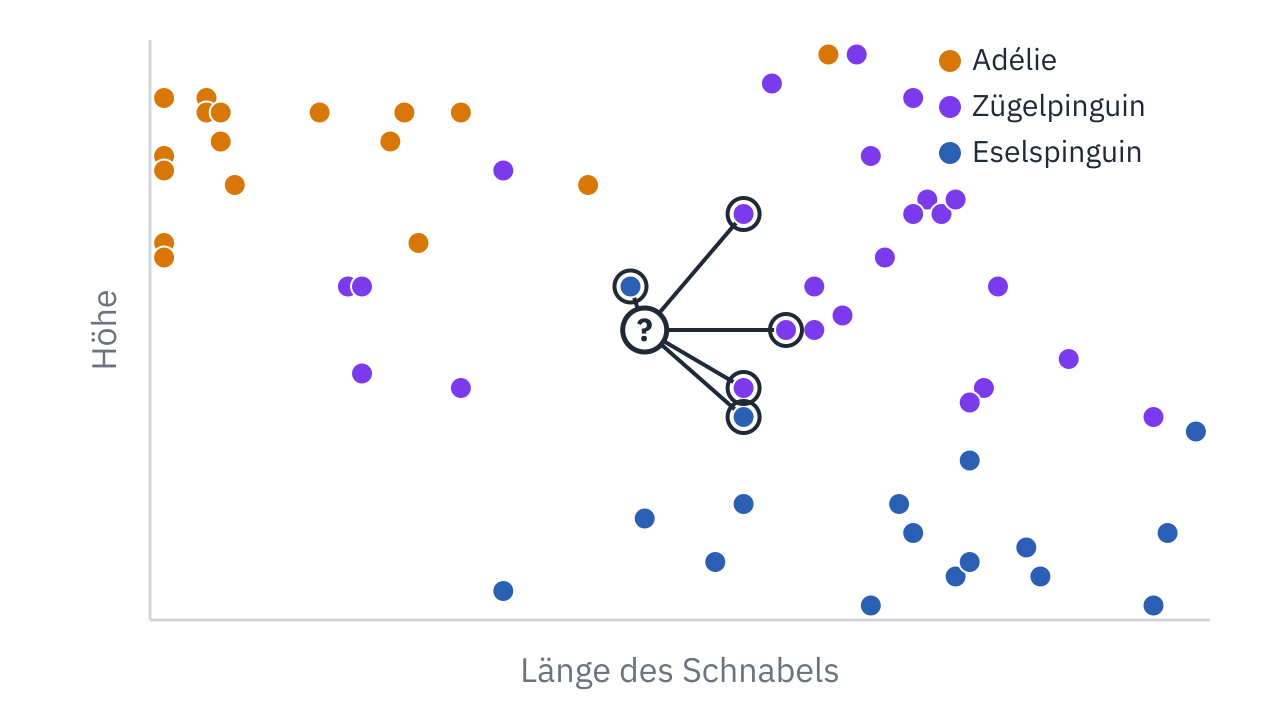
Mit k = 1 wäre der unbekannte Pinguin ein Eselspinguin, mit k = 5 ein Zügelpinguin. Ein einzelner Nachbar kann ein Ausreißer sein; mehrere Nachbarn stimmen ab.
Beschrieben haben das Verfahren die Statistikerin Evelyn Fix und der Statistiker Joseph Hodges 1951, in einem Bericht für die Luftwaffe der USA. Es ist bis heute eines der einfachsten Verfahren, mit denen ein Programm aus Beispielen lernt, und eines der durchsichtigsten: Zu jeder Entscheidung kann es sagen, welche Beispiele dahinterstehen.
Discriminatory Analysis. Nonparametric Discrimination: Consistency Properties, Evelyn Fix und Joseph L. Hodges, USAF School of Aviation Medicine, 1951. Der Bericht, in dem ein neuer Fall die Antwort seiner nächsten Nachbarn bekommt: als PDF beim Defense Technical Information Center, 1989 neu gedruckt in der International Statistical Review.
Lege einen Ordner an und lade die Daten herunter:
mkdir -p ~/nachbarn
cd ~/nachbarn
wget https://workspace.hackschule.de/naechste-nachbarn/penguins.csv https://workspace.hackschule.de/naechste-nachbarn/customers.csv
touch knn.rb penguins.rb
In knn.rb kommen die Funktionen, in penguins.rb das Programm, das sie für
die Pinguine benutzt. Ausprobieren kannst du die Funktionen in irb, das
knn.rb vorher lädt:
irb -r ./knn.rb
Lege einen Ordner an und lade die Daten herunter:
mkdir -p ~/nachbarn
cd ~/nachbarn
wget https://workspace.hackschule.de/naechste-nachbarn/penguins.csv https://workspace.hackschule.de/naechste-nachbarn/customers.csv
touch knn.py penguins.py
In knn.py kommen die Funktionen, in penguins.py das Programm, das sie für
die Pinguine benutzt. Ausprobieren kannst du die Funktionen in Python, das
knn.py vorher ausführt:
python3 -i knn.py
penguins.csv hat eine Zeile je Pinguin: die Art, die Insel, die Länge und die
Höhe des Schnabels, die Länge der Flosse und das Gewicht.
species,island,bill_length_mm,bill_depth_mm,flipper_length_mm,body_mass_g
Adelie,Torgersen,39.1,18.7,181,3750
Trägst du die zwei Maße eines Schnabels als Punkt in ein Diagramm ein, die Länge nach rechts und die Höhe nach oben, dann ist »ähnlich« dasselbe wie »nah«. Wie weit zwei Punkte auseinanderliegen, rechnest du mit dem Satz des Pythagoras aus: Die Unterschiede in jeder Richtung sind die Katheten, der Abstand ist die Hypotenuse.
$$d = \sqrt{(a_1 - b_1)^2 + (a_2 - b_2)^2}$$
Bei mehr als zwei Merkmalen kommt für jedes ein Quadrat unter die Wurzel dazu. Die Formel bleibt dieselbe, nur zeichnen kann man den Raum dann nicht mehr.
Ein Pinguin hat einen Schnabel, der 39 mm lang und 18 mm hoch ist, ein anderer einen, der 42 mm lang und 14 mm hoch ist. Wie weit liegen die beiden Punkte auseinander?
Die Unterschiede sind 3 und 4. Quadriere sie, addiere, zieh die Wurzel.
knn die Funktion distance(a, b):
a und b sind zwei gleich lange Listen von Zahlen, und
die Funktion gibt zurück, wie weit die beiden Punkte auseinanderliegen. Später
haben die Punkte vier Merkmale; schreib sie so, dass sie mit jeder Anzahl geht.
Geh die Listen mit einem Index durch: a.each_index do |i| … end. Für jeden
Index kommt das Quadrat des Unterschieds zu einer Summe dazu.
Das Quadrat ist ** 2, die Wurzel Math.sqrt(sum). Beginn die Summe mit
0.0, dann bleibt alles eine Kommazahl.
# Wie weit zwei Punkte auseinanderliegen, mit beliebig vielen Merkmalen
def distance(a, b)
  sum = 0.0
  a.each_index do |i|
    sum += (a[i] - b[i])**2
  end
  Math.sqrt(sum)
end
Geh die Listen mit einem Index durch: for i in range(len(a)):. Für jeden
Index kommt das Quadrat des Unterschieds zu einer Summe dazu.
Das Quadrat ist ** 2, die Wurzel math.sqrt(total); dafür steht oben in der
Datei import math.
import math


# Wie weit zwei Punkte auseinanderliegen, mit beliebig vielen Merkmalen
def distance(a, b):
    total = 0.0
    for i in range(len(a)):
        total += (a[i] - b[i]) ** 2
    return math.sqrt(total)
Schreib in nachbarn/knn.rb die Funktion distance(a, b). Die Prüfung
ruft sie mit zwei und mit drei Merkmalen auf.
Schreib in nachbarn/knn.py die Funktion distance(a, b). Die Prüfung
ruft sie mit zwei und mit drei Merkmalen auf.
Ein Beispiel ist ein Paar: die Merkmale und die Antwort, die dazugehört. Bei
einem Pinguin sind das die zwei Maße des Schnabels und seine Art:
[[39.1, 18.7], "Adelie"]. Die nächsten Nachbarn eines Punktes findest du,
indem du alle Beispiele nach ihrem Abstand zu ihm sortierst und die ersten
nimmst.
nearest(examples, features, k):
Sie gibt die k Beispiele zurück, deren Merkmale am nächsten an
features liegen, das nächste zuerst.
sort_by sortiert eine Liste nach dem Wert, den der Block für jedes Element
ausrechnet. Ein Beispiel kannst du im Block gleich in seine zwei Teile
zerlegen: |other, label|.
Die ersten k Elemente einer Liste gibt first(k).
# Die k Beispiele, deren Merkmale features am nächsten liegen, das nächste zuerst
def nearest(examples, features, k)
  examples.sort_by { |other, _label| distance(other, features) }.first(k)
end
sorted(examples, key=…) sortiert eine Liste nach dem Wert, den die Funktion
bei key für jedes Element ausrechnet. Eine kurze Funktion schreibst du gleich
dorthin: lambda example: …. Die Merkmale eines Beispiels sind example[0].
Die ersten k Elemente einer Liste gibt [:k].
# Die k Beispiele, deren Merkmale features am nächsten liegen, das nächste zuerst
def nearest(examples, features, k):
    return sorted(examples, key=lambda example: distance(example[0], features))[:k]
Schreib in nachbarn/knn.rb die Funktion nearest(examples, features, k).
Die Prüfung gibt ihr vier Beispiele und fragt nach den zwei, drei und
einem nächsten.
Schreib in nachbarn/knn.py die Funktion nearest(examples, features, k).
Die Prüfung gibt ihr vier Beispiele und fragt nach den zwei, drei und
einem nächsten.
Jetzt fehlt die Abstimmung: Welche Antwort kommt unter den k nächsten
Nachbarn am häufigsten vor? Kommen zwei gleich oft vor, gewinnt die, die unter
den Nachbarn zuerst kommt, also zum näheren gehört.
classify(examples, features, k):
Sie gibt die Antwort zurück, die unter den k nächsten Nachbarn
von features am häufigsten ist; bei Gleichstand die des näheren
Nachbarn.
Mach aus den Nachbarn erst eine Liste ihrer Antworten, mit map, in derselben
Reihenfolge, das nächste zuerst.
labels.count(label) zählt, wie oft eine Antwort in der Liste steht.
max_by gibt das Element, für das der Block am größten ist, und bei
Gleichstand das, das in der Liste zuerst kommt.
# Was die meisten der k nächsten Nachbarn sind; bei Gleichstand das, was zuerst kommt
def classify(examples, features, k)
  labels = nearest(examples, features, k).map { |_features, label| label }
  labels.max_by { |label| labels.count(label) }
end
Mach aus den Nachbarn erst eine Liste ihrer Antworten, in derselben
Reihenfolge, das nächste zuerst: [label for _features, label in …].
labels.count(label) zählt, wie oft eine Antwort in der Liste steht.
max(labels, key=labels.count) gibt die Antwort, die am häufigsten ist, und
bei Gleichstand die, die in der Liste zuerst kommt.
# Was die meisten der k nächsten Nachbarn sind; bei Gleichstand das, was zuerst kommt
def classify(examples, features, k):
    labels = [label for _features, label in nearest(examples, features, k)]
    return max(labels, key=labels.count)
Schreib in nachbarn/knn.rb die Funktion classify(examples, features, k).
Die Prüfung gibt ihr fünf Beispiele, zwei »A« nahe bei (0, 0) und drei
»B«, und fragt mit verschiedenen k, auch mit einem Gleichstand.
Schreib in nachbarn/knn.py die Funktion classify(examples, features, k).
Die Prüfung gibt ihr fünf Beispiele, zwei »A« nahe bei (0, 0) und drei
»B«, und fragt mit verschiedenen k, auch mit einem Gleichstand.
Damit das Programm die Pinguine kennt, liest diese Funktion die Datei. Sie gibt für jeden Pinguin ein Beispiel zurück: die zwei Maße des Schnabels und die Art. Schreib sie unter die anderen in dieselbe Datei:
# Die Pinguine als [[Länge, Höhe], Art]
def penguins(path)
  File.readlines(path).drop(1).map do |line|
    species, _island, length, depth = line.split(",")
    [[length.to_f, depth.to_f], species]
  end
end
Und in penguins.rb das Programm:
require_relative "knn"

examples = penguins("penguins.csv")
puts classify(examples, [46.0, 18.0], 5)
ruby penguins.rb
# Die Pinguine als [[Länge, Höhe], Art]
def penguins(path):
    examples = []
    for line in open(path).readlines()[1:]:
        species, _island, length, depth = line.split(",")[:4]
        examples.append([[float(length), float(depth)], species])
    return examples
Und in penguins.py das Programm:
from knn import *

examples = penguins("penguins.csv")
print(classify(examples, [46.0, 18.0], 5))
python3 penguins.py
Welche Art sagt dein Programm für den Pinguin mit einem Schnabel, der 46 mm lang und 18 mm hoch ist, mit den fünf nächsten Nachbarn?
Führe penguins.rb aus (in Python penguins.py) und lies, was es ausgibt.
Gelernt hat das Programm eigentlich nichts. Es hebt alle Beispiele auf und sieht bei jeder Frage nach. Ob das reicht, zeigt sich an Pinguinen, deren Art es nicht kennt: Es bekommt nur jeden zweiten Pinguin als Beispiel und muss die anderen einordnen, deren Art man kennt und vergleichen kann.
accuracy(training, test, k):
Sie ordnet jedes Beispiel aus test mit classify nach
den Beispielen in training ein und gibt den Anteil zurück, bei dem
die Antwort stimmt, als Zahl von 0 bis 1.
Zähl die Testbeispiele, bei denen classify die Antwort des Beispiels gibt:
test.count { |features, label| … }.
Teile durch die Zahl aller Testbeispiele, mit to_f vorher, denn in Ruby
ergibt 3 / 4 die ganze Zahl 0.
# Der Anteil der Testbeispiele, die classify richtig einordnet
def accuracy(training, test, k)
  right = test.count { |features, label| classify(training, features, k) == label }
  right.to_f / test.size
end
Zähl die Testbeispiele, bei denen classify die Antwort des Beispiels gibt, in
einer Schleife über for features, label in test:.
Teile die Zahl durch len(test).
# Der Anteil der Testbeispiele, die classify richtig einordnet
def accuracy(training, test, k):
    right = sum(1 for features, label in test if classify(training, features, k) == label)
    return right / len(test)
Schreib in nachbarn/knn.rb die Funktion accuracy(training, test, k).
Die Prüfung gibt ihr vier Beispiele zum Vergleichen und vier
Testbeispiele, von denen zwei richtig eingeordnet werden.
Schreib in nachbarn/knn.py die Funktion accuracy(training, test, k).
Die Prüfung gibt ihr vier Beispiele zum Vergleichen und vier
Testbeispiele, von denen zwei richtig eingeordnet werden.
In penguins.rb, statt den einen Pinguin einzuordnen:
examples = penguins("penguins.csv")training = examples.select.with_index { |_, i| i.even? }test = examples.select.with_index { |_, i| i.odd? }puts "Richtig: #{(accuracy(training, test, 3) * 100).round(1)} %"
In penguins.py, statt den einen Pinguin einzuordnen:
examples = penguins("penguins.csv")training = examples[0::2]test = examples[1::2]print(f"Richtig: {round(accuracy(training, test, 3) * 100, 1)} %")
Wie viel Prozent der Testpinguine ordnet dein Programm mit k = 3 richtig ein? Runde auf eine Stelle nach dem Komma.
Führe penguins.rb (in Python penguins.py) mit dem geänderten
Programm aus. Ist es eine andere Zahl, prüf, ob training die Pinguine mit
geradem Index bekommt und test die mit ungeradem.
In training sind 171 Pinguine. Was passiert, wenn das Programm mit
k = 171 abstimmt? Vermute erst, dann probier es aus.
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
Mit k = 171 fragt das Programm jedes Mal alle Pinguine, die es kennt, und die häufigste Art unter ihnen ist immer dieselbe: der Adéliepinguin. Dann sagt es zu jedem Pinguin »Adelie« und liegt bei 43,9 Prozent richtig, so oft, wie unter den Testpinguinen Adéliepinguine sind. Ein kleines k hört auf einzelne Nachbarn, auch auf Ausreißer; ein großes k sieht nicht mehr hin, wo der Punkt liegt. Dazwischen liegt das k, mit dem das Programm am besten ist, und das muss man ausprobieren.
Ab hier ist alles ausgedacht. In einer Stadt, durch die ein Fluss fließt, verleiht ein Laden Fahrräder. Wer ein Rad leiht, zahlt manchmal 50 Euro Kaution, die er zurückbekommt, wenn das Rad pünktlich und heil wiederkommt. Ob jemand eine Kaution zahlen muss, haben bisher die Leute im Laden entschieden, und sie haben zu jeder Kundin und jedem Kunden aufgeschrieben:
| Spalte | Was darin steht |
|---|---|
district |
der Stadtteil, in dem die Person wohnt |
x, y
|
wo sie wohnt, in Kilometern östlich und nördlich der Südwestecke der Stadt |
distance |
wie weit sie vom Laden entfernt wohnt, in Kilometern |
years |
seit wie vielen Jahren sie Kundin oder Kunde ist |
late |
wie oft sie im letzten Jahr ein Rad zu spät zurückgebracht hat |
deposit |
die Entscheidung des Ladens: 1 heißt Kaution, 0 keine |
on_time |
ob sie das nächste Rad pünktlich zurückgebracht hat: 1 heißt ja |
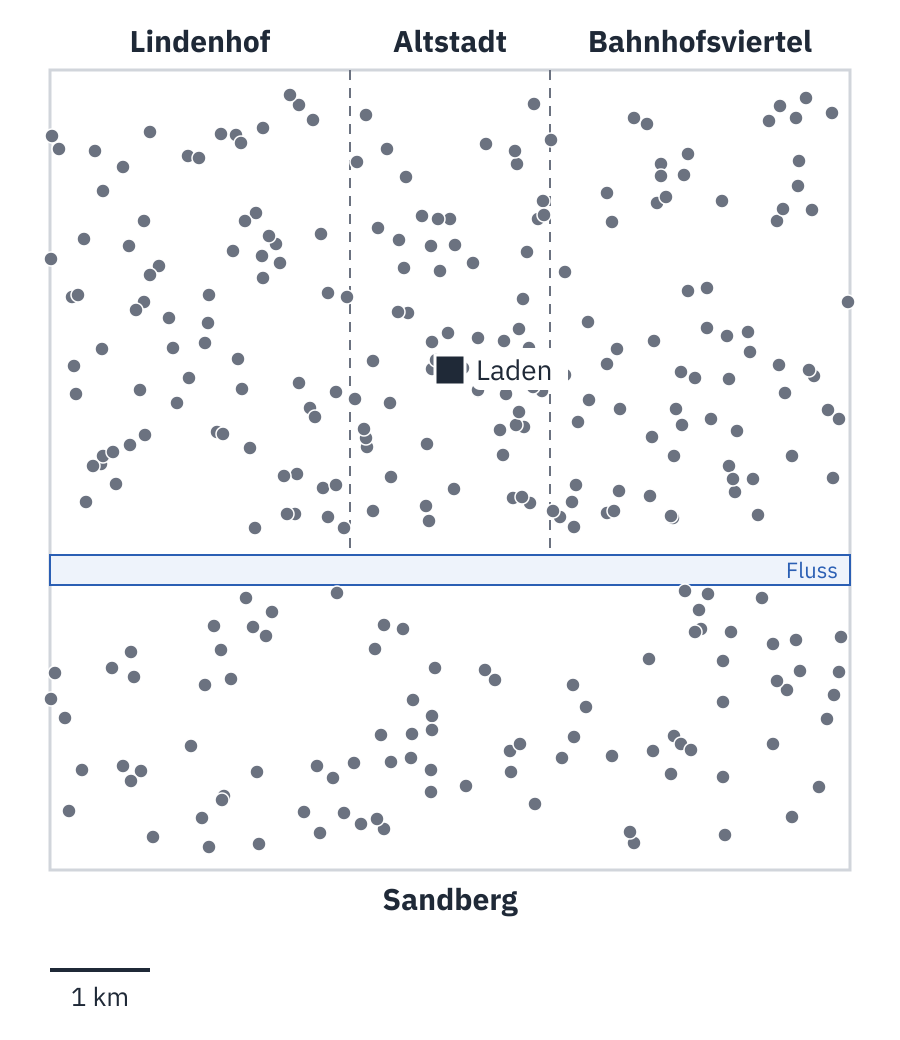
Jetzt soll ein Programm entscheiden, damit es schneller geht und, wie der Laden sagt, gerechter. Es lernt aus den 300 Entscheidungen der letzten Jahre und entscheidet über die nächsten 300 Kundinnen und Kunden. Die Funktionen hast du schon; dazu kommen zwei, die die Datei lesen. Schreib sie unter die anderen in deine Datei mit den Funktionen:
# Jede Kundin und jeder Kunde als Hash: Spalte => Wert, Zahlen als Zahlen
def customers(path)
  lines = File.readlines(path, chomp: true)
  keys = lines[0].split(",")
  lines.drop(1).map do |line|
    keys.zip(line.split(",")).to_h { |key, value| [key, key == "district" ? value : value.to_f] }
  end
end

# Beispiele aus Kunden: die Spalten in columns als Merkmale, die Kaution als Antwort
def examples(people, columns)
  people.map { |person| [columns.map { |column| person[column] }, person["deposit"].to_i] }
end
Und das Programm in einer neuen Datei deposit.rb:
require_relative "knn"

people = customers("customers.csv")
past = people.select.with_index { |_, i| i.even? }
latest = people.select.with_index { |_, i| i.odd? }
columns = ["years", "late", "x", "y"]
training = examples(past, columns)
test = examples(latest, columns)
puts "Gleich entschieden wie der Laden: #{(accuracy(training, test, 5) * 100).round(1)} %"
ruby deposit.rb
# Jede Kundin und jeder Kunde als Dictionary: Spalte -> Wert, Zahlen als Zahlen
def customers(path):
    lines = open(path).read().splitlines()
    keys = lines[0].split(",")
    people = []
    for line in lines[1:]:
        person = {}
        for key, value in zip(keys, line.split(",")):
            person[key] = value if key == "district" else float(value)
        people.append(person)
    return people


# Beispiele aus Kunden: die Spalten in columns als Merkmale, die Kaution als Antwort
def examples(people, columns):
    return [[[person[column] for column in columns], int(person["deposit"])] for person in people]
Und das Programm in einer neuen Datei deposit.py:
from knn import *

people = customers("customers.csv")
past = people[0::2]
latest = people[1::2]
columns = ["years", "late", "x", "y"]
training = examples(past, columns)
test = examples(latest, columns)
print(f"Gleich entschieden wie der Laden: {round(accuracy(training, test, 5) * 100, 1)} %")
python3 deposit.py
Für die neuen Kundinnen und Kunden weiß man, wie der Laden entschieden hätte;
accuracy vergleicht damit, was das Programm sagt. Die Merkmale sind die Jahre,
die Verspätungen und der Wohnort, so wie die Leute im Laden ihre Kundschaft
kannten.
Wie viel Prozent der neuen Kundinnen und Kunden ordnet dein Programm genauso ein, wie der Laden es getan hätte? Runde auf eine Stelle nach dem Komma.
Führe deposit.rb (in Python deposit.py) aus. Ist es eine andere Zahl,
prüf, ob die Spalten years, late, x und y sind und k 5 ist.
Eine Kaution von jemandem zu verlangen, der jedes Rad pünktlich zurückbringt, ist ein Fehler zu seinen Lasten: Er muss 50 Euro haben, die er für nichts hinterlegt. Ob ein Programm gerecht entscheidet, zeigt sich daran, wen solche Fehler treffen.
Das Programm weiß nicht, in welchem Stadtteil jemand wohnt; es kennt nur die Jahre, die Verspätungen und den Wohnort als zwei Zahlen. Von wem verlangt es eine Kaution, obwohl er sein Rad pünktlich zurückbringt?
deposit_share(training, test, k):
Sie gibt den Anteil der Beispiele in test zurück, für die
classify nach training eine Kaution verlangt, also 1
sagt, als Zahl von 0 bis 1. Die Antworten in test zählen dabei
nicht.
Sie sieht aus wie accuracy. Nur zählt sie nicht, wo classify die Antwort des
Beispiels gibt, sondern wo es 1 gibt.
def deposit_share(training, test, k)
  deposits = test.count { |features, _label| … }
  # hier: durch die Zahl der Testbeispiele teilen, als Kommazahl
end
# Der Anteil der Testbeispiele, für die classify eine Kaution verlangt (1)
def deposit_share(training, test, k)
  deposits = test.count { |features, _label| classify(training, features, k) == 1 }
  deposits.to_f / test.size
end
Sie sieht aus wie accuracy. Nur zählt sie nicht, wo classify die Antwort des
Beispiels gibt, sondern wo es 1 gibt.
def deposit_share(training, test, k):
    deposits = sum(1 for features, _label in test if ...)
    # hier: durch die Zahl der Testbeispiele teilen
# Der Anteil der Testbeispiele, für die classify eine Kaution verlangt (1)
def deposit_share(training, test, k):
    deposits = sum(1 for features, _label in test if classify(training, features, k) == 1)
    return deposits / len(test)
Schreib in nachbarn/knn.rb die Funktion
deposit_share(training, test, k). Die Prüfung gibt ihr vier
Beispiele zum Vergleichen und Testbeispiele, deren Antworten nicht
zählen.
Schreib in nachbarn/knn.py die Funktion
deposit_share(training, test, k). Die Prüfung gibt ihr vier
Beispiele zum Vergleichen und Testbeispiele, deren Antworten nicht
zählen.
Am Ende von deposit.rb: für jeden Stadtteil die neuen Kundinnen und Kunden,
die ihr Rad pünktlich zurückgebracht haben, und wie viele davon nach dem
Programm eine Kaution zahlen sollen:
["Altstadt", "Lindenhof", "Bahnhofsviertel", "Sandberg"].each do |district|
  punctual = latest.select { |person| person["district"] == district && person["on_time"] == 1 }
  share = deposit_share(training, examples(punctual, columns), 5)
  puts "#{district}: #{(share * 100).round(1)} % der Pünktlichen sollen Kaution zahlen"
end
Am Ende von deposit.py: für jeden Stadtteil die neuen Kundinnen und Kunden,
die ihr Rad pünktlich zurückgebracht haben, und wie viele davon nach dem
Programm eine Kaution zahlen sollen:
for district in ["Altstadt", "Lindenhof", "Bahnhofsviertel", "Sandberg"]:
    punctual = [person for person in latest if person["district"] == district and person["on_time"] == 1]
    share = deposit_share(training, examples(punctual, columns), 5)
    print(f"{district}: {round(share * 100, 1)} % der Pünktlichen sollen Kaution zahlen")
Wie viel Prozent der Pünktlichen am Sandberg sollen nach deinem Programm eine Kaution zahlen? Runde auf eine Stelle nach dem Komma.
Führe deposit.rb (in Python deposit.py) mit der Schleife über die
Stadtteile aus und lies die Zeile »Sandberg«.
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
| Stadtteil | Pünktliche | Kaution nach dem Laden | Kaution nach dem Programm |
|---|---|---|---|
| Altstadt | 43 | 18,6 % | 14,0 % |
| Lindenhof | 63 | 28,6 % | 15,9 % |
| Bahnhofsviertel | 69 | 24,6 % | 18,8 % |
| Sandberg | 85 | 70,6 % | 84,7 % |
Wer am Sandberg wohnt und sein Rad pünktlich zurückbringt, soll in mehr als acht von zehn Fällen eine Kaution zahlen; in den anderen Stadtteilen in ein bis zwei von zehn. Das Programm kennt keine Stadtteile, nur Zahlen. Aber zwei der Zahlen sind der Wohnort, und die nächsten Nachbarn eines Menschen am Sandberg wohnen am Sandberg, im wörtlichen Sinn. Der Laden hat dort öfter eine Kaution verlangt, also verlangt sie das Programm dort auch.
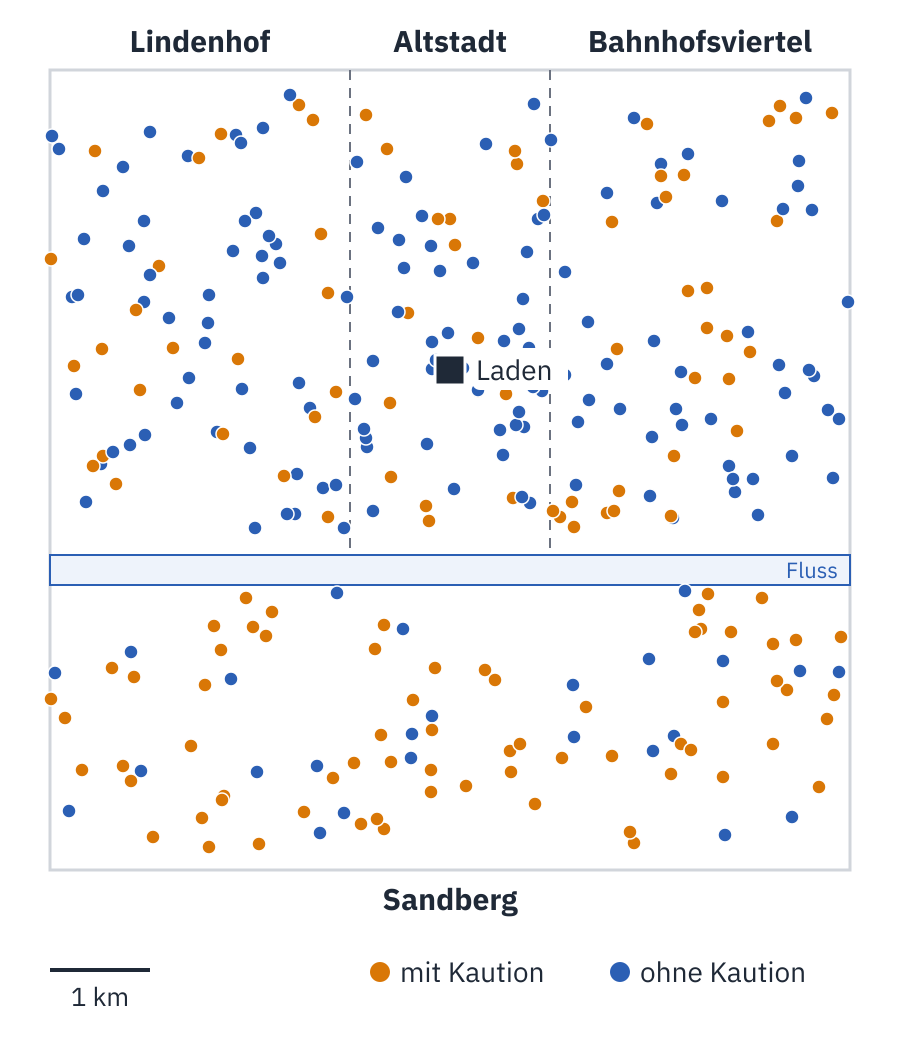
Warum der Laden so entschieden hat, steht in keiner Spalte. Die Daten sind ausgedacht, und das Programm, das sie erzeugt hat, sagt es: Wer am Sandberg wohnt, ist genauso zuverlässig wie alle anderen, aber der Laden hat dort von sechs in zehn Leuten, die er sonst ohne Kaution gelassen hätte, trotzdem eine verlangt. Und das Programm ist sogar strenger als der Laden: Haben drei von fünf Nachbarn eine Kaution gezahlt, verlangt es sie immer. Aus »meistens« wird bei einer Abstimmung »immer«.
Nimm in deposit.rb (in Python deposit.py) die Spalten x und y
aus columns, so dass nur years und late bleiben. Was passiert mit
den Pünktlichen am Sandberg? Vermute erst, dann probier es aus.
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
Ohne x und y sollen von den Pünktlichen am Sandberg 28,2 Prozent Kaution
zahlen, in der Altstadt 18,6, in Lindenhof 27,0 und im Bahnhofsviertel 27,5.
Die Stadtteile werden fast gleich behandelt. Aber nicht, weil das Programm jetzt
gerechte Beispiele hätte: Es lernt immer noch aus den alten Entscheidungen, nur
kann es den Wohnort nicht mehr sehen. Die Kautionen, die der Laden am Sandberg
zu Unrecht verlangt hat, verteilen sich jetzt auf alle: In Lindenhof und im
Bahnhofsviertel trifft es mehr Pünktliche als vorher.
Den Wohnort wegzulassen, scheint zu reichen. Aber in der Datei steht noch eine Spalte, die mit dem Wohnort zu tun hat: wie weit jemand vom Laden entfernt wohnt. Der Laden liegt in der Altstadt, nördlich des Flusses.
Nimm statt x und y die Spalte distance dazu, so dass columns
years, late und distance sind. Wie viel Prozent der Pünktlichen am
Sandberg sollen jetzt eine Kaution zahlen? Runde auf eine Stelle nach dem
Komma.
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
Mit der Entfernung statt des Wohnorts sollen 56,5 Prozent der Pünktlichen am Sandberg eine Kaution zahlen. Die Entfernung verrät ungefähr den Stadtteil: Wer weit weg wohnt, wohnt oft am Sandberg. Ein Merkmal, das für ein anderes steht, heißt Stellvertreter (englisch proxy). Ein Programm kann so eine Gruppe benachteiligen, ohne dass in seinen Daten steht, wer zu ihr gehört.
Das Programm macht genau das, was es soll: entscheiden wie der Laden. Der Fehler steckt in den Beispielen, aus denen es lernt. Daraus folgt einiges, was der Laden tun könnte:
on_time steht, ob jemand das nächste Rad
wirklich pünktlich zurückgebracht hat. Lernt das Programm daraus statt aus
den alten Entscheidungen, lernt es, was tatsächlich passiert ist, nicht, was
jemand im Laden vermutet hat.Die Datenschutz-Grundverordnung hat dazu eine Regel: Nach Artikel 22 hat jeder Mensch das Recht, keiner Entscheidung unterworfen zu werden, die nur ein Programm getroffen hat und die ihn erheblich beeinträchtigt. Es gibt Ausnahmen, etwa wenn die Entscheidung für einen Vertrag nötig ist; dann muss ein Mensch sie auf Wunsch überprüfen, und die betroffene Person darf ihren Standpunkt darlegen und die Entscheidung anfechten. Ein Mensch bleibt verantwortlich, auch wenn ein Programm entscheidet.
Was dein Programm mit ausgedachten Kunden macht, passiert mit echten Menschen. Die Informatikerin Joy Buolamwini hat es an Programmen gezeigt, die Gesichter erkennen.
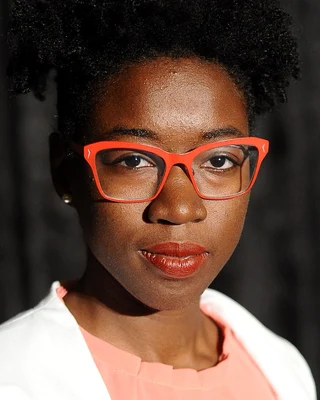
Joy Buolamwini, kanadisch-US-amerikanische Informatikerin. Am MIT Media Lab baute sie einen Spiegel, der Gesichter erkennen sollte; ihr Gesicht erkannte die Software erst, als sie eine weiße Maske aufsetzte. Sie gründete die Algorithmic Justice League, die Verzerrungen in Programmen aufdeckt, und schrieb darüber 2023 das Buch »Unmasking AI«.
Wie du am Sandberg hat sie die Fehler eines Programms nach Gruppen getrennt gezählt.
Foto: Niccolò Caranti, 2018, CC BY-SA 4.0, zugeschnitten (Wikimedia Commons)
2018 prüften sie und die Informatikerin Timnit Gebru drei Programme großer Firmen, die auf einem Foto erkennen sollten, ob es eine Frau oder einen Mann zeigt. Bei Männern mit heller Haut lagen sie fast nie falsch, höchstens in 0,8 Prozent der Fälle. Bei Frauen mit dunkler Haut lag eines in 34,7 Prozent der Fälle falsch. Die Sammlungen von Fotos, an denen man solche Programme bis dahin gemessen hatte, zeigten vor allem Menschen mit heller Haut; dass die Programme bei anderen schlechter sind, fiel so nicht auf. Nach der Studie haben IBM und Microsoft ihre Programme überarbeitet.
Gender Shades: Intersectional Accuracy Disparities in Commercial Gender Classification, Joy Buolamwini und Timnit Gebru, Conference on Fairness, Accountability and Transparency, 2018. Die Studie, die die Fehler dreier Programme nach Hautfarbe und Geschlecht getrennt zählt: PDF, auch bei den Proceedings of Machine Learning Research.
Der Laden will das Programm einsetzen. Was rätst du ihm? Geh dabei auf deine Zahlen ein und darauf, wer verantwortlich ist, wenn das Programm jemanden zu Unrecht eine Kaution zahlen lässt.