powered by 
Wie ein Programm lernt: Es misst, wie weit es vom Ziel weg ist, und dreht jeden seiner Regler ein Stück in die Richtung, in der der Fehler kleiner wird. So lernen die Splats in Gaussian Splatting ihre Lage, Form und Farbe, und so lernen neuronale Netze. Hier stehen die Idee, der Pseudocode, wie groß die Schritte sein dürfen, und das Verfahren Adam, das fast alle Programme nehmen.
Ein Programm hat Zahlen, die es einstellen kann, die Regler, und eine Zahl, die sagt, wie schlecht das Ergebnis ist, den Fehler (englisch loss). Gesucht sind die Regler, bei denen der Fehler am kleinsten ist. Mit nur einem Regler \(c\) und dem Fehler
$$E(c) = (c - 0{,}7)^2$$
sieht man es sofort: bei \(c = 0{,}7\). Bei Millionen Reglern sieht man nichts mehr. Man kann aber an jeder Stelle fühlen, wie steil es bergab geht und in welche Richtung, wie jemand im Nebel am Berg.
Die Ableitung \(E'(c)\) ist die Steigung an der Stelle \(c\), hier \(E'(c) = 2\,(c - 0{,}7)\). Ist sie positiv, wird der Fehler größer, wenn \(c\) wächst; also macht man \(c\) kleiner, und umgekehrt. Ein Schritt geht ein Stück gegen die Steigung:
$$c \leftarrow c - \eta \cdot E'(c)$$
Die Zahl \(\eta\) (Eta) ist die Lernrate: Sie sagt, wie groß die Schritte sind. Wo es steil ist, wird der Schritt groß, wo es flach wird, klein; nahe am Tiefpunkt geht es deshalb von selbst immer langsamer.
gradient_descent(params, rate, steps):
    for k from 1 to steps:
        slope ← derivative(params)
        params ← params − rate · slope
    return params
Für \(E(c) = (c - 0{,}7)^2\), begonnen bei \(c = 1{,}4\) mit der Lernrate 0,2:
| Schritt | \(c\) | Steigung \(2\,(c - 0{,}7)\) | Fehler \(E(c)\) |
|---|---|---|---|
| 0 | 1,4 | 1,4 | 0,49 |
| 1 | 1,12 | 0,84 | 0,176 |
| 2 | 0,952 | 0,504 | 0,064 |
| 3 | 0,8512 | 0,302 | 0,023 |
| 4 | 0,7907 | 0,181 | 0,008 |
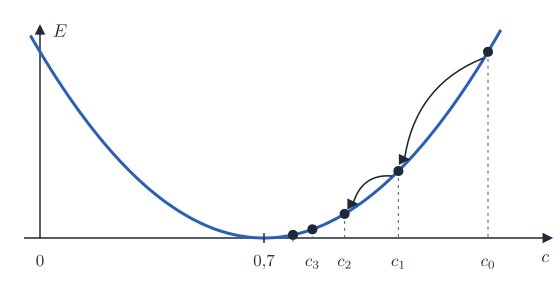
Jeder Schritt ist kleiner als der vorige, weil die Steigung kleiner wird. Den Tiefpunkt erreicht das Verfahren nie genau, aber so nah, wie man will; man hört auf, wenn sich der Fehler kaum noch ändert.
Die Lernrate entscheidet, ob es klappt. Dasselbe Beispiel, begonnen bei 1,4, mit verschiedenen Lernraten:
| Lernrate | \(c\) nach 0, 1, 2, 3, 4 Schritten | was passiert |
|---|---|---|
| 0,05 | 1,4; 1,33; 1,27; 1,21; 1,16 | kommt an, aber langsam |
| 0,2 | 1,4; 1,12; 0,95; 0,85; 0,79 | kommt zügig an |
| 0,5 | 1,4; 0,7; 0,7; 0,7; 0,7 | in einem Schritt am Tiefpunkt (nur bei dieser Parabel) |
| 1,0 | 1,4; 0; 1,4; 0; 1,4 | springt hin und her, ohne anzukommen |
| 1,1 | 1,4; −0,14; 1,71; −0,51; 2,15 | schießt über den Tiefpunkt hinaus, immer weiter weg |
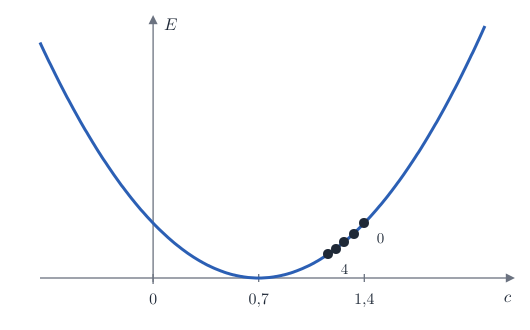
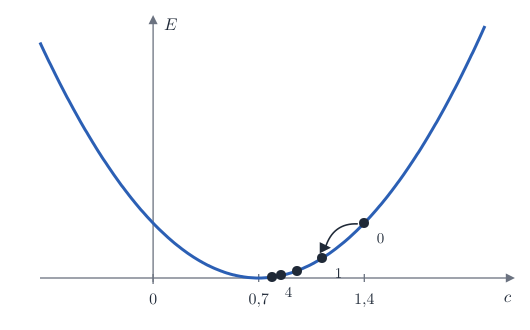
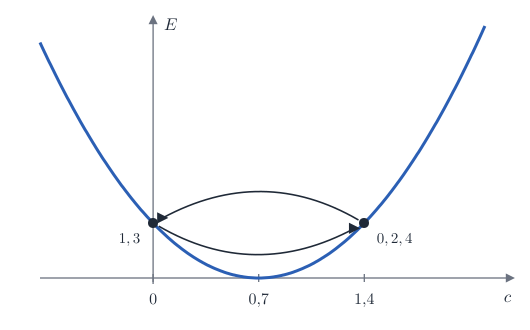
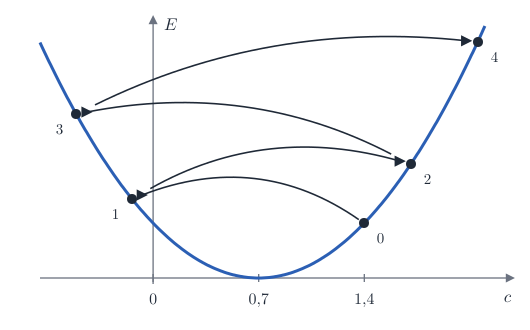
Eine zu große Lernrate erkennt man daran, dass der Fehler von Schritt zu Schritt wächst oder auf und ab springt. Dann halbiert man sie. Eine zu kleine erkennt man daran, dass er sehr langsam, aber stetig fällt.
Hängt der Fehler von vielen Reglern ab, hat jeder seine eigene Steigung: wie sich der Fehler ändert, wenn man nur diesen Regler ein wenig dreht und alle anderen lässt (die partielle Ableitung). Alle Steigungen zusammen sind der Gradient \(\nabla E\), ein Vektor mit so vielen Zahlen, wie es Regler gibt. Er zeigt in die Richtung, in der der Fehler am schnellsten wächst; ein Schritt geht also für alle Regler gleichzeitig dagegen:
$$\vec{r} \leftarrow \vec{r} - \eta \cdot \nabla E(\vec{r})$$
Ist die Formel für die Ableitung zu schwierig, schätzt man sie: den Regler ein winziges Stück \(h\) verschieben und schauen, wie sich der Fehler ändert,
$$E'(c) \approx \frac{E(c + h) - E(c - h)}{2h}$$
mit einem kleinen \(h\), etwa 0,0001. Das ist einfach, kostet aber für jeden Regler zwei Rechnungen des ganzen Fehlers; bei Millionen Reglern rechnet man die Ableitungen deshalb aus der Formel, rückwärts durch die Rechnung (Backpropagation). Zum Prüfen, ob die eigene Ableitung stimmt, ist die Schätzung trotzdem gut.
Haben die Regler verschiedene Größenordnungen, Lagen in Pixeln, Winkel im Bogenmaß, Farben von 0 bis 1, passt eine Lernrate für alle nicht mehr. Das Verfahren Adam gibt jedem Regler ein eigenes Tempo. Es merkt sich für jeden, in welche Richtung er zuletzt gegangen ist (der Schwung \(m\)) und wie groß seine Steigungen typisch sind (\(v\)), und teilt das eine durch das andere:
adam_step(param, slope, rate, t):
    m ← 0.9 · m + 0.1 · slope
    v ← 0.999 · v + 0.001 · slope²
    m_corr ← m / (1 − 0.9^t)      (am Anfang sind m und v noch zu klein)
    v_corr ← v / (1 − 0.999^t)
    param ← param − rate · m_corr / (√v_corr + 0.00000001)
So macht jeder Regler Schritte von etwa der Größe der Lernrate, egal wie groß seine Steigung gerade ist. Der Schwung glättet das Hin und Her, wenn die Steigung von Schritt zu Schritt das Vorzeichen wechselt. Diederik Kingma und Jimmy Ba haben Adam 2014 beschrieben; fast alle Programme, die heute etwas lernen, nehmen Adam oder ein Verfahren wie Adam.
Hängt der Fehler von sehr vielen Beispielen ab, Millionen Bilder oder Fotos, rechnet man ihn für jeden Schritt nur mit einigen davon aus, einem Batch (englisch für Stapel), jedes Mal mit anderen. Die Steigung wird ungenauer, aber jeder Schritt viel schneller (stochastischer Gradientenabstieg). Gaussian Splatting nimmt für jeden Schritt ein einziges Foto.
Gradientenabstieg geht immer nur bergab, dorthin, wo es von hier aus abwärts geht. Hat der Fehler mehrere Täler, landet er im nächsten, nicht unbedingt im tiefsten (ein lokales Minimum). Auf einer flachen Hochebene oder einem Sattel ist die Steigung fast 0, und es geht kaum voran. Was dagegen hilft: gute Startwerte, ein Schwung wie bei Adam, der über kleine Mulden hinwegträgt, und bei sehr vielen Reglern die Erfahrung, dass es dort selten echte Sackgassen gibt.