powered by 
Du entwirfst eine Datenbank für Filme, ihre Genres und die Menschen, die an ihnen mitgearbeitet haben. Das Modell schreibst du als Text, die ER-Werkstatt in VS Code zeichnet daraus Diagramme und erzeugt das SQL für die Tabellen. Danach lädst du echte Filmdaten hinein und setzt mit JOIN wieder zusammen, was das Modell auf mehrere Tabellen verteilt hat.
In der »Einführung in SQL« hast du eine fertige Datenbank abgefragt. Jetzt baust du selbst eine: vom Modell über das Diagramm zu den Tabellen und dann zu den Abfragen. Alles, was du dabei schreibst, sind Dateien in deinem Workspace, die du behältst.
So könnte ein Film aussehen, wenn ein Programm ihn als JSON verschickt:
{
  "id": 233,
  "title": "Back to the Future",
  "german_title": "Zurück in die Zukunft",
  "year": 1985,
  "runtime": 115,
  "genres": ["Adventure", "Comedy", "Sci-Fi"],
  "crew": {
    "director": ["Robert Zemeckis"],
    "actor": ["Michael J. Fox", "Christopher Lloyd", "Lea Thompson"],
    "composer": ["Alan Silvestri"]
  }
}
Für den Austausch ist das bequem: Alles über einen Film steht an einer Stelle. Für eine Datenbank, die viele Fragen beantworten soll, ist es ungünstig. »Welche Filme sind Sci-Fi?« hieße, in jedem Film die Liste genres zu durchsuchen. Und wer bei fünf Filmen Regie geführt hat, stünde fünfmal mit seinem Namen da, vielleicht einmal anders geschrieben.
In dem Datensatz stecken verschiedene Arten von Dingen: Filme, Genres, Personen und das, was eine Person bei einem Film gemacht hat, die Tätigkeit. In einer relationalen Datenbank bekommt jede Art ihre eigene Tabelle, und die Beziehungen zwischen ihnen werden eigens gespeichert.
Warum ist eine Spalte genres in der Tabelle der Filme, in der zum
Beispiel Action, Sci-Fi steht, ungünstig?
Schließe zuerst einen geöffneten Ordner: StrgK, dann F. Öffne dann mit StrgK und StrgO den Ordner filmdatenbank. Weil es ihn noch nicht gibt, fragt VS Code, ob er angelegt werden soll; bestätige mit Enter.
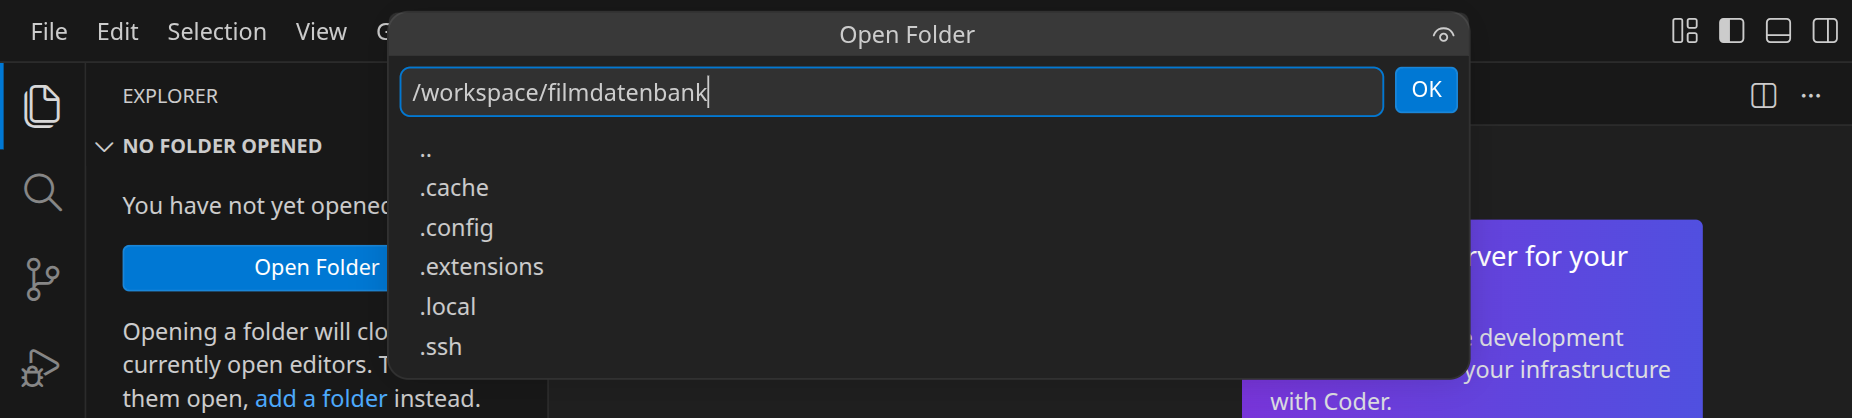
Lege im Ordner eine neue Datei film.er an: Klicke im Explorer auf das Symbol »Neue Datei« und tippe den Namen. Die Endung .er ist wichtig, an ihr erkennt VS Code ein ER-Modell.
Ein ER-Modell (Entity-Relationship-Modell) beschreibt, welche Dinge es gibt (Entitäten), welche Eigenschaften sie haben (Attribute) und wie sie zusammenhängen (Beziehungen). Du schreibst es als Text. Fang mit Filmen und Genres an:
# Filme und ihre Genres

entity movie
  id: int, primary key
  title: text
  original_title: text, optional
  german_title: text, optional
  year: int
  runtime: int

entity genre
  id: int, primary key
  name: text, unique

relationship has_genre: movie n:m genre
So liest du das:
entity movie legt die Entität movie an. Die eingerückten Zeilen darunter sind ihre Attribute: Name, Doppelpunkt, Typ.int für ganze Zahlen, text für Text bis 255 Zeichen. Es gibt auch varchar(n), decimal(p,s), float, date, datetime und bool.primary key markiert den Primärschlüssel: das Attribut, das jeden Film eindeutig bestimmt. Titel taugen dafür nicht, es gibt mehrere Filme mit demselben Titel. In SQL heißt er genauso, PRIMARY KEY.optional heißt: darf leer bleiben. Nicht jeder Film hat einen eigenen deutschen Titel.unique heißt: kein Wert darf doppelt vorkommen. Jedes Genre gibt es nur einmal.relationship has_genre: movie n:m genre verbindet Filme und Genres. n:m ist die Kardinalität: Ein Film hat mehrere Genres, und zu einem Genre gehören viele Filme. Weitere Möglichkeiten sind 1:1, 1:n und n:1.Bezeichner schreibst du klein und englisch, ohne Leerzeichen und Umlaute; für mehrere Wörter nimmst du _. Die Namen sind nicht beliebig: Die Filmdaten, die du später lädst, erwarten genau diese Tabellen und Spalten.
Während du tippst, unterstreicht VS Code Fehler rot und erklärt sie, wenn du mit der Maus darüberfährst. Alle Fehler stehen auch im Bereich »Probleme« (StrgShiftM).
Schreib das Modell mit movie, genre und der Beziehung has_genre in
filmdatenbank/film.er.
Klicke oben rechts im Editor auf »ER-Diagramm anzeigen« (oder StrgK, dann V). Neben deinem Text erscheint das Modell als Diagramm, und es ändert sich mit, während du schreibst.
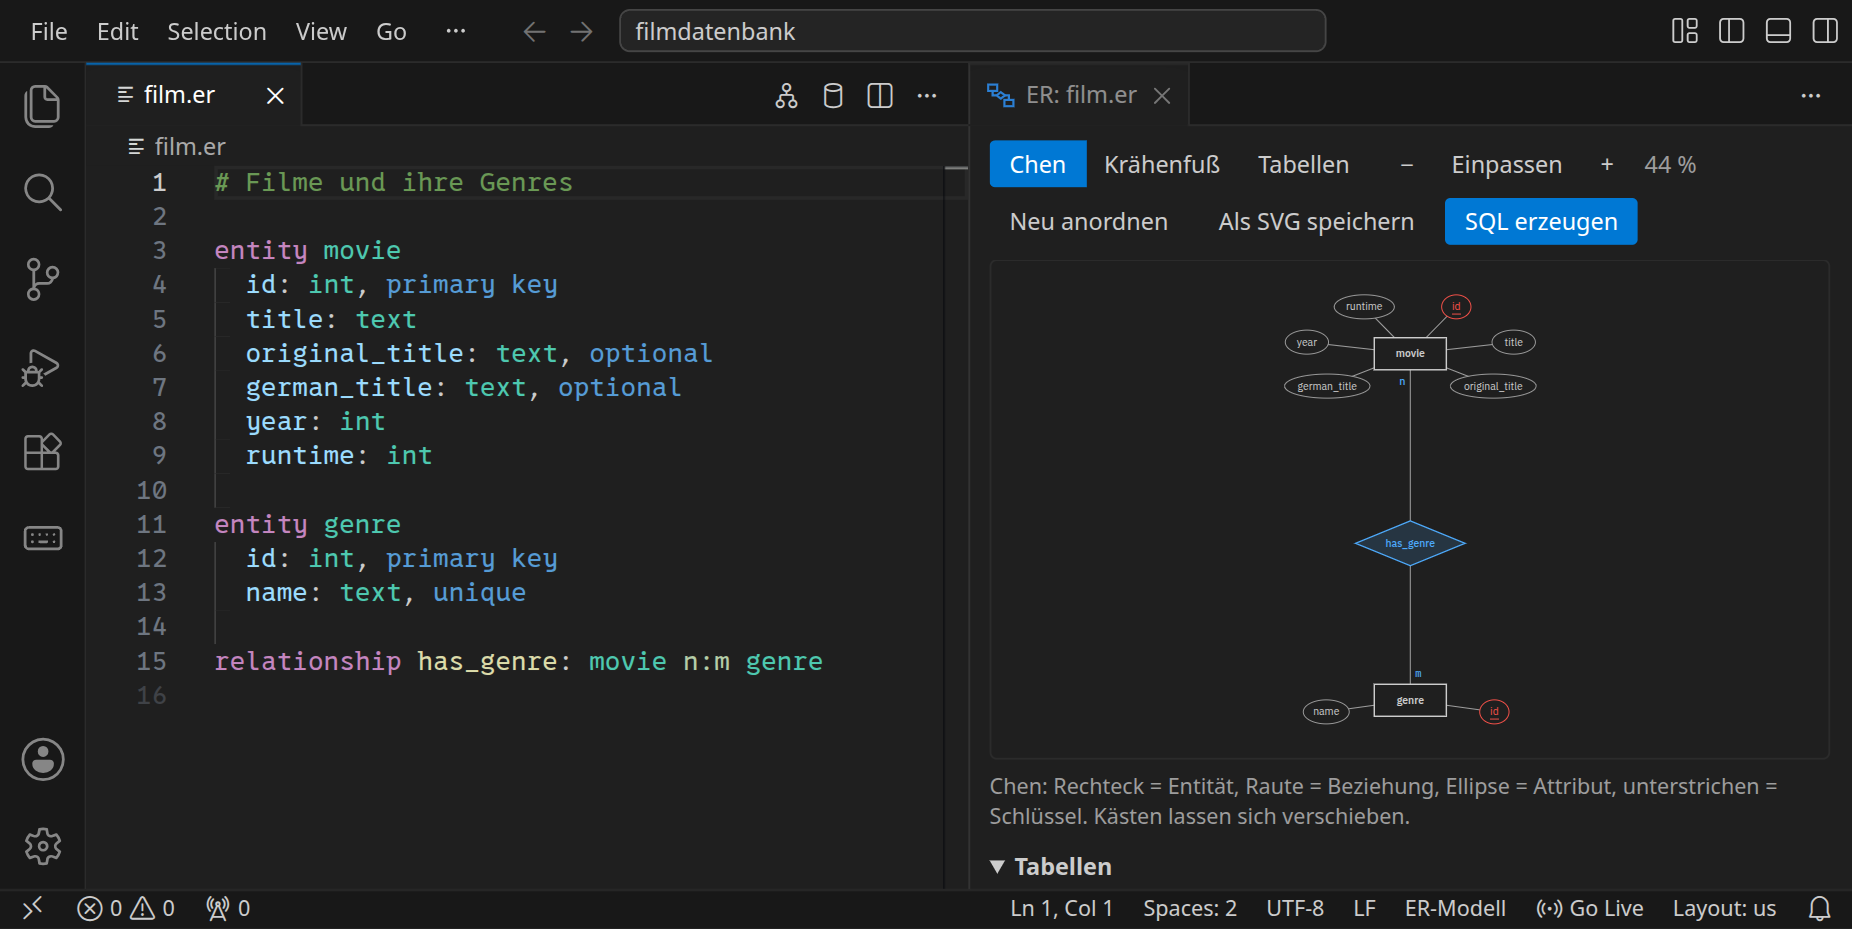
Oben in der Vorschau wählst du zwischen drei Darstellungen desselben Modells.
Chen. Rechtecke sind Entitäten, Rauten Beziehungen, Ellipsen Attribute. Primärschlüssel sind unterstrichen. An den Linien steht die Kardinalität. Diese Darstellung findest du in vielen Schulbüchern.

Krähenfuß. Jede Entität ist ein Kasten mit ihren Attributen. Das Linienende zeigt die Kardinalität: Der gespreizte Krähenfuß heißt »viele«, ein Querstrich heißt »eins«. Weil has_genre eine n:m-Beziehung ist, siehst du hier an beiden Enden einen Krähenfuß und keinen Strich.

Tabellen. So wird das Modell in der Datenbank gespeichert. Aus jeder Entität wird eine Tabelle. Die n:m-Beziehung wird zu einer eigenen Tabelle movie_genre: In ihr steht pro Zeile ein Paar aus Film und Genre, nur mit den beiden IDs.

Jetzt siehst du auch den Strich für »eins«: Die Linien führen von movie_genre zu movie und zu genre, mit dem Krähenfuß bei movie_genre und dem Strich am anderen Ende. Zu einem Film gehören viele Zeilen in movie_genre, aber jede Zeile gehört zu genau einem Film.
In movie_genre steht PK·FK vor beiden Spalten:
movie_id verweist auf eine id in movie, genre_id auf eine id in genre. Die Datenbank lässt nur IDs zu, die es dort gibt.movie_id allein reicht nicht, ein Film hat mehrere Genres. Das nennt man einen zusammengesetzten Primärschlüssel.Unter dem Diagramm stehen die Tabellen noch einmal als Liste und, aufgeklappt, »So wurde übersetzt«: Schritt für Schritt, was aus welchem Teil des Modells geworden ist.
Die Kästen kannst du mit der Maus verschieben. Die Positionen merkt sich die ER-Werkstatt in der versteckten Datei .film.er.layout.json neben deinem Modell; »Neu anordnen« ordnet alles wieder automatisch an.
Angenommen, jeder Film hätte nur ein einziges Genre, und du schreibst
relationship has_genre: movie n:1 genre. Was passiert in der
Tabellenansicht? Überleg zuerst, dann probier es aus und stell n:m
wieder her.
Klicke in der Vorschau auf »SQL erzeugen«. Neben film.er entsteht die Datei film.sql:
-- Erzeugt aus film.er mit der ER-Werkstatt 0.1.0.
-- Nicht von Hand ändern: Beim nächsten Erzeugen wird diese Datei überschrieben.
-- Vorhandene Tabellen mit diesen Namen werden gelöscht, samt Inhalt.

SET FOREIGN_KEY_CHECKS = 0;
DROP TABLE IF EXISTS movie, genre, movie_genre;
SET FOREIGN_KEY_CHECKS = 1;

CREATE TABLE movie (
  id              INT NOT NULL,
  title           VARCHAR(255) NOT NULL,
  original_title  VARCHAR(255) NULL,
  german_title    VARCHAR(255) NULL,
  year            INT NOT NULL,
  runtime         INT NOT NULL,
  PRIMARY KEY (id)
);

CREATE TABLE genre (
  id    INT NOT NULL,
  name  VARCHAR(255) NOT NULL,
  PRIMARY KEY (id),
  UNIQUE (name)
);

CREATE TABLE movie_genre (
  movie_id  INT NOT NULL,
  genre_id  INT NOT NULL,
  PRIMARY KEY (movie_id, genre_id)
);

ALTER TABLE movie_genre
  ADD FOREIGN KEY (movie_id)
  REFERENCES movie (id);

ALTER TABLE movie_genre
  ADD FOREIGN KEY (genre_id)
  REFERENCES genre (id);
DROP TABLE IF EXISTS löscht die Tabellen, falls es sie schon gibt. So kannst du ein geändertes Modell jederzeit mit demselben Befehl neu anlegen. Dabei geht ihr Inhalt verloren.CREATE TABLE legt eine Tabelle an. NOT NULL steht bei allem, was nicht optional ist.PRIMARY KEY legt den Primärschlüssel fest, UNIQUE verbietet doppelte Werte.FOREIGN KEY … REFERENCES movie (id) macht aus movie_id einen Fremdschlüssel auf movie.Öffne ein Terminal (StrgJ) und gib die Datei an MySQL:
mysql < film.sql
Wenn alles klappt, gibt mysql nichts aus. Ob die Tabellen da sind, siehst du in mycli. Starte es und gib SHOW TABLES; ein:
mycli
SHOW TABLES;
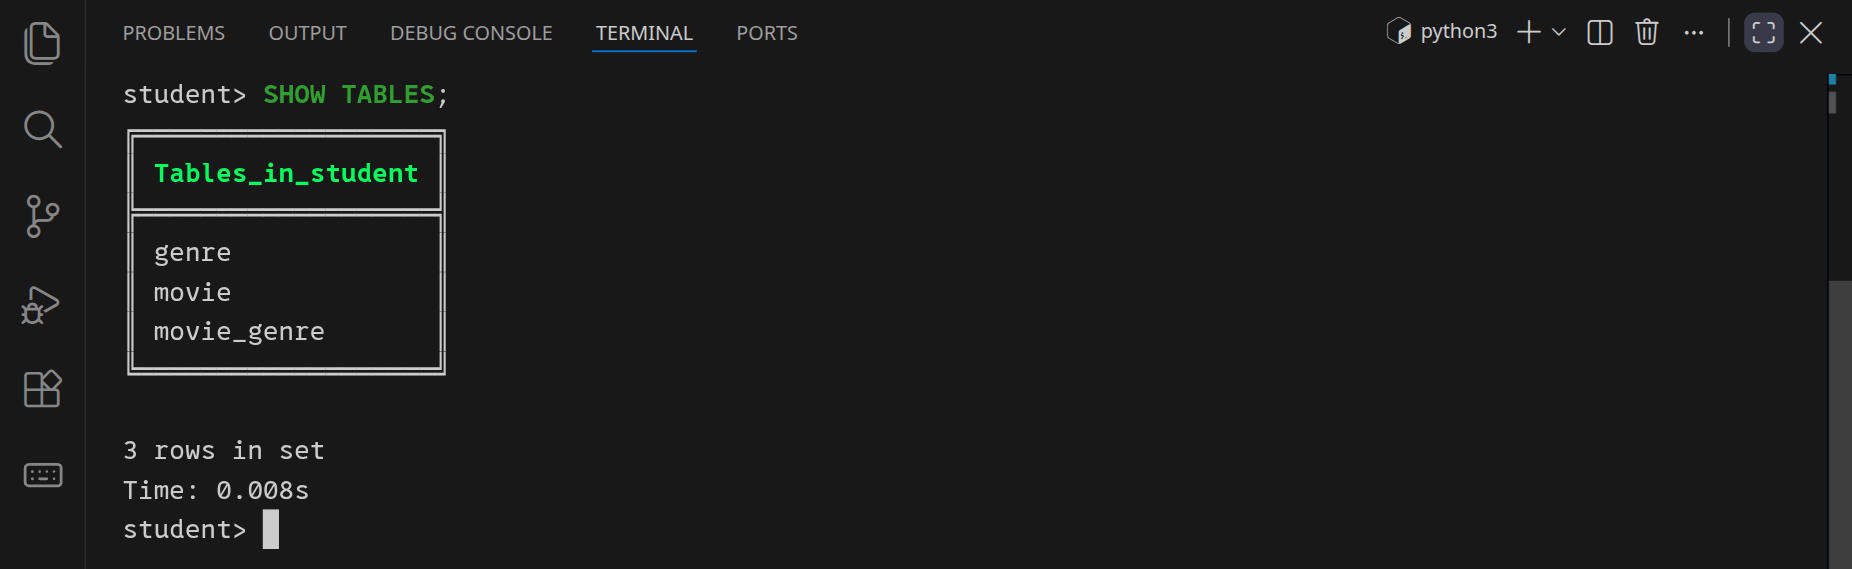
Erzeuge film.sql und führe es mit mysql < film.sql aus.
Die Tabellen sind angelegt, aber leer. Beende mycli mit exit oder StrgD. Lade dann die Filme, Genres und ihre Zuordnungen herunter:
wget https://github.com/specht/workspace-files/raw/main/movie-archive/mysql-data-movies.sql
…und gib sie an MySQL:
mysql < mysql-data-movies.sql
Am Ende meldet MySQL für jede der drei Tabellen OK: Es hat sich angesehen, was jetzt darin steht, damit spätere Abfragen schnell sind.
Schau dir mysql-data-movies.sql ruhig an. Es sind lauter INSERT-Befehle, und jeder nennt die Spalten, in die er schreibt, zum Beispiel INSERT INTO movie (id, title, original_title, …). Deshalb müssen die Namen in deinem Modell genau stimmen. Meldet MySQL Unknown column oder Table … doesn't exist, vergleiche die Namen in film.er mit der Meldung, erzeuge das SQL neu und fang mit mysql < film.sql wieder an.
README.md neben den Dateien.
Lade mysql-data-movies.sql in deine Datenbank.
Starte wieder mycli und sieh dich um, wie in der »Einführung in SQL«:
SELECT * FROM movie LIMIT 5;
SELECT * FROM movie_genre LIMIT 5;
Schreib eine Abfrage, die zählt, wie viele Filme in der Tabelle movie stehen.
In der »Einführung in SQL« kamen die Antworten aus einer Tabelle. Jetzt hast du die Daten mit Absicht verteilt. Welche Genres hat »Back to the Future«? movie kennt den Film, aber nicht seine Genres:
SELECT id, title, year
FROM movie
WHERE title = 'Back to the Future';
Die Zuordnung steht in movie_genre. Also verbindest du movie mit movie_genre:
SELECT movie.title, movie_genre.genre_id
FROM movie
JOIN movie_genre ON movie.id = movie_genre.movie_id
WHERE movie.title = 'Back to the Future';
JOIN verbindet Zeilen aus zwei Tabellen. ON sagt, welche Zeilen zusammengehören: die, bei denen movie.id und movie_genre.movie_id gleich sind. Weil es zwei Tabellen mit einer Spalte id geben kann, schreibst du den Tabellennamen davor, movie.id.
Jetzt hast du die IDs der Genres. Für ihre Namen folgst du der nächsten Linie im Tabellendiagramm, von movie_genre zu genre:
SELECT movie.title, genre.name
FROM movie
JOIN movie_genre ON movie.id = movie_genre.movie_id
JOIN genre ON movie_genre.genre_id = genre.id
WHERE movie.title = 'Back to the Future';
JOIN … ON … folgt einer Linie im Tabellendiagramm. Wenn du dort den Weg von einer Tabelle zur anderen findest, hast du die Abfrage schon fast. Vergisst du ON, verbindet MySQL jede Zeile mit jeder: Aus einigen tausend Filmen und Zuordnungen werden Millionen Zeilen.
Welche Genres hat »Back to the Future« aus dem Jahr 1985? Gefragt sind nur die Namen der Genres.
Zeig alle Animationsfilme (Genre Animation) mit Titel und Erscheinungsjahr, die ältesten zuerst.
Mit COUNT(*) zählst du Zeilen. Mit GROUP BY teilst du das Ergebnis vorher in Gruppen und zählst jede Gruppe für sich:
SELECT genre.name, COUNT(*)
FROM genre
JOIN movie_genre ON genre.id = movie_genre.genre_id
GROUP BY genre.id, genre.name;
Alle Zeilen mit demselben Genre werden zu einer zusammengefasst, und COUNT(*) zählt, wie viele es waren.
Wie viele Filme gibt es in jedem Genre? Zeig den Namen des Genres und die Anzahl, die größten Genres zuerst.
Bisher fehlt die crew aus dem Datensatz vom Anfang. Wer hat bei »Back to the Future« Regie geführt? In welchen Filmen hat eine Person mitgespielt? Dafür braucht das Modell Personen und ihre Tätigkeiten.
Überlege, bevor du weiterliest: Eine Person arbeitet an vielen Filmen, an einem Film arbeiten viele Personen. Und eine Person kann bei einem Film mehrere Tätigkeiten haben, etwa Regie führen und das Drehbuch schreiben. Zwischen welchen Entitäten besteht die Beziehung?
Sie verbindet drei Entitäten auf einmal: Film, Person und Tätigkeit. Ergänze film.er um zwei Entitäten und eine dreistellige Beziehung:
# Personen und was sie bei einem Film gemacht haben

entity crew
  id: int, primary key
  name: text
  birth_year: int, optional
  death_year: int, optional

entity job
  id: int, primary key
  title: text, unique

relationship credit: movie, crew, job as movie_crew
as hieße diese Tabelle movie_crew_job. Die Filmdaten erwarten movie_crew, deshalb gibst du den Namen mit as movie_crew vor.job enthält Tätigkeiten wie actor, director oder composer.
In der Tabellenansicht siehst du movie_crew mit drei Fremdschlüsseln, die zusammen den Primärschlüssel bilden. So kann dieselbe Person bei einem Film mehrere Tätigkeiten haben, aber dieselbe Kombination aus Film, Person und Tätigkeit nicht zweimal vorkommen.

Ergänze film.er um crew, job und die dreistellige Beziehung credit.
Erzeuge das SQL neu, beende mycli und lege die Tabellen an. Weil film.sql mit DROP TABLE beginnt, sind danach auch movie und genre wieder leer. Lade deshalb danach beide Datendateien. Die neue musst du erst herunterladen:
wget https://github.com/specht/workspace-files/raw/main/movie-archive/mysql-data-crew.sql
mysql < film.sql
mysql < mysql-data-movies.sql
mysql < mysql-data-crew.sql
CREATE TABLE für die neuen Tabellen, ALTER TABLE für neue Spalten. Hier liegen die Daten in Dateien, deshalb ist Neuanlegen der einfachere und sichere Weg.
Erzeuge das SQL neu und führe film.sql, mysql-data-movies.sql und
mysql-data-crew.sql nacheinander aus.
Starte wieder mycli. Wer hat bei »Back to the Future« Regie geführt? Im Tabellendiagramm führt der Weg von movie über movie_crew zu crew, und die Tätigkeit steht in job. Jeder Schritt wird ein JOIN:
SELECT crew.name
FROM movie
JOIN movie_crew ON movie.id = movie_crew.movie_id
JOIN crew ON movie_crew.crew_id = crew.id
JOIN job ON movie_crew.job_id = job.id
WHERE movie.title = 'Back to the Future' AND job.title = 'director';
Wer hat in »Back to the Future« (1985) mitgespielt? Gefragt sind nur die Namen, Tätigkeit actor.
Bei welchen Filmen hat Christopher Nolan Regie geführt (director)? Zeig Titel und Jahr, nach dem Jahr sortiert.
Mit GROUP BY zählst du auch hier. Und wenn du nur Gruppen sehen willst, die eine Bedingung erfüllen, schreibst du sie hinter HAVING. WHERE filtert Zeilen, bevor gruppiert wird, HAVING filtert die fertigen Gruppen:
SELECT genre.name, COUNT(*)
FROM genre
JOIN movie_genre ON genre.id = movie_genre.genre_id
GROUP BY genre.id, genre.name
HAVING COUNT(*) >= 100;
Wer hat bei mindestens fünf Filmen der Datenbank Regie geführt? Zeig den Namen und die Anzahl der Filme, die meisten zuerst.
Eine einfache Frage: Welche zwei Schauspielerinnen oder Schauspieler standen besonders oft gemeinsam vor der Kamera? Die Datenbank kann sie beantworten, aber die Abfrage braucht jede Tabelle zweimal, einmal für jede der beiden Personen:
SELECT a.name, b.name, COUNT(*) AS together
FROM movie_crew AS ma
JOIN movie_crew AS mb ON ma.movie_id = mb.movie_id
JOIN job AS ja ON ma.job_id = ja.id
JOIN job AS jb ON mb.job_id = jb.id
JOIN crew AS a ON ma.crew_id = a.id
JOIN crew AS b ON mb.crew_id = b.id
WHERE ja.title = 'actor' AND jb.title = 'actor' AND a.id < b.id
GROUP BY a.id, a.name, b.id, b.name
ORDER BY together DESC
LIMIT 10;
AS ma gibt einer Tabelle einen zweiten Namen, damit sie zweimal vorkommen kann. a.id < b.id sorgt dafür, dass jedes Paar nur einmal gezählt wird und niemand mit sich selbst. Du musst die Abfrage nicht Zeile für Zeile nachbauen; probier sie aus.
Fragen, die von Person zu Film zu Person und weiter wandern, werden in SQL schnell lang. Graphdatenbanken wie Neo4j speichern genau diese Wege und machen solche Fragen kurz.
Denk dir eine Frage an die Filmdatenbank aus, die dieses Modell nicht beantworten kann, zum Beispiel für eine Videothek oder ein Kino. Was müsste das Modell zusätzlich enthalten: welche Entitäten, welche Beziehungen mit welcher Kardinalität?
.er-Datei und siehst es als Chen-, Krähenfuß- oder Tabellendiagramm.CREATE TABLE, PRIMARY KEY, FOREIGN KEY), das du mit mysql < film.sql ausführst.JOIN … ON … setzt du verteilte Daten wieder zusammen, einen Schritt pro Linie im Tabellendiagramm. GROUP BY bildet Gruppen, HAVING filtert sie.Dein Modell film.er, das erzeugte film.sql und die Diagramme, die du mit »Als SVG speichern« sicherst, liegen in /workspace/filmdatenbank. Sie gehören dir; du kannst sie herunterladen oder in ein eigenes Repository legen.