powered by 
In der »Filmdatenbank mit MySQL« hast du Filme, Genres und Personen auf Tabellen verteilt und mit JOIN wieder zusammengesetzt. Jetzt speicherst du dieselben Daten als Graph in Neo4j: Filme, Personen und Genres werden zu Knoten, ihre Beziehungen zu direkten Verbindungen. Du lernst die Abfragesprache Cypher kennen und siehst, warum Fragen wie »Wer arbeitet oft mit wem?« in einem Graphen kurz werden.
Am Ende der Filmdatenbank hattest du sechs Tabellen: movie, genre, movie_genre, crew, job und movie_crew. Für die Genres eines Films führte der Weg durch eine Zwischentabelle, für die Menschen sogar durch zwei:
movie → movie_genre → genre

movie → movie_crew → crew
             ↓
            job
Das funktioniert. Aber die letzte Frage dort, wer besonders oft mit wem gespielt hat, brauchte jede Tabelle zweimal. Es ging nicht mehr um einen Film oder eine Person, sondern um die Verbindungen zwischen ihnen. Eine Graphdatenbank speichert genau diese Verbindungen.
Im Graphen gibt es drei Arten von Knoten: Movie, Person und Genre. Zwischen ihnen liegen Beziehungen, und jede Beziehung hat einen Typ:
(:Movie)-[:IN_GENRE]->(:Genre)

(:Person)-[:ACTOR]->(:Movie)
(:Person)-[:DIRECTOR]->(:Movie)
(:Person)-[:WRITER]->(:Movie)
(:Person)-[:PRODUCER]->(:Movie)
(:Person)-[:COMPOSER]->(:Movie)
(:Person)-[:CINEMATOGRAPHER]->(:Movie)
(:Person)-[:EDITOR]->(:Movie)
Die Typen sind die Tätigkeiten aus der Tabelle job, nur in Großbuchstaben, so wie man sie in Cypher üblicherweise schreibt.
In MySQL ordnete die Tabelle movie_genre Filme ihren Genres zu. Was
wird im Graphen aus ihr?
Wo steht im Graphen, dass Robert Zemeckis bei »Back to the Future« Regie geführt hat, und nicht etwa mitgespielt?
Ein Knoten hat ein Label, das sagt, was für ein Ding er ist, und Eigenschaften mit Werten. »Back to the Future« sieht im Graphen ungefähr so aus:
(:Movie {
  id: 233,
  title: "Back to the Future",
  german_title: "Zurück in die Zukunft",
  year: 1985,
  runtime: 115
})
Movie ist das Label, id, title, german_title, year und runtime sind Eigenschaften. Ein Genre und eine Person sehen so aus:
(:Genre { id: 5, name: "Comedy" })

(:Person { id: 2493, name: "Michael J. Fox", birth_year: 1961 })
Eine Beziehung verbindet zwei Knoten und zeigt in eine Richtung:
(:Person { name: "Robert Zemeckis" })-[:DIRECTOR]->(:Movie { title: "Back to the Future" })
Runde Klammern stehen für Knoten, eckige für Beziehungen. Der Name hinter dem Doppelpunkt ist bei einem Knoten sein Label, bei einer Beziehung ihr Typ. Das ist schon Cypher: Genau so schreibst du gleich deine Abfragen.
Schalte zuerst in deinem Profil unter »Datenbanken« Neo4j ein. Du hast dann eine eigene, leere Neo4j-Datenbank, und oben im Menü erscheint der Knopf »Neo4j«. Im Workspace stehen deine Zugangsdaten in den Umgebungsvariablen NEO4J_URI, NEO4J_USERNAME, NEO4J_PASSWORD und NEO4J_DATABASE; die Werkzeuge unten lesen sie von selbst.
Öffne ein Terminal und wechsle in den Ordner aus der Filmdatenbank (mkdir -p legt ihn an, falls es ihn noch nicht gibt):
mkdir -p ~/filmdatenbank
cd ~/filmdatenbank
Lade dort die Filmdaten herunter…
wget https://github.com/specht/workspace-files/raw/main/movie-archive/neo4j.dump
…und lade sie in deine Datenbank:
neo4j_bolt load neo4j.dump
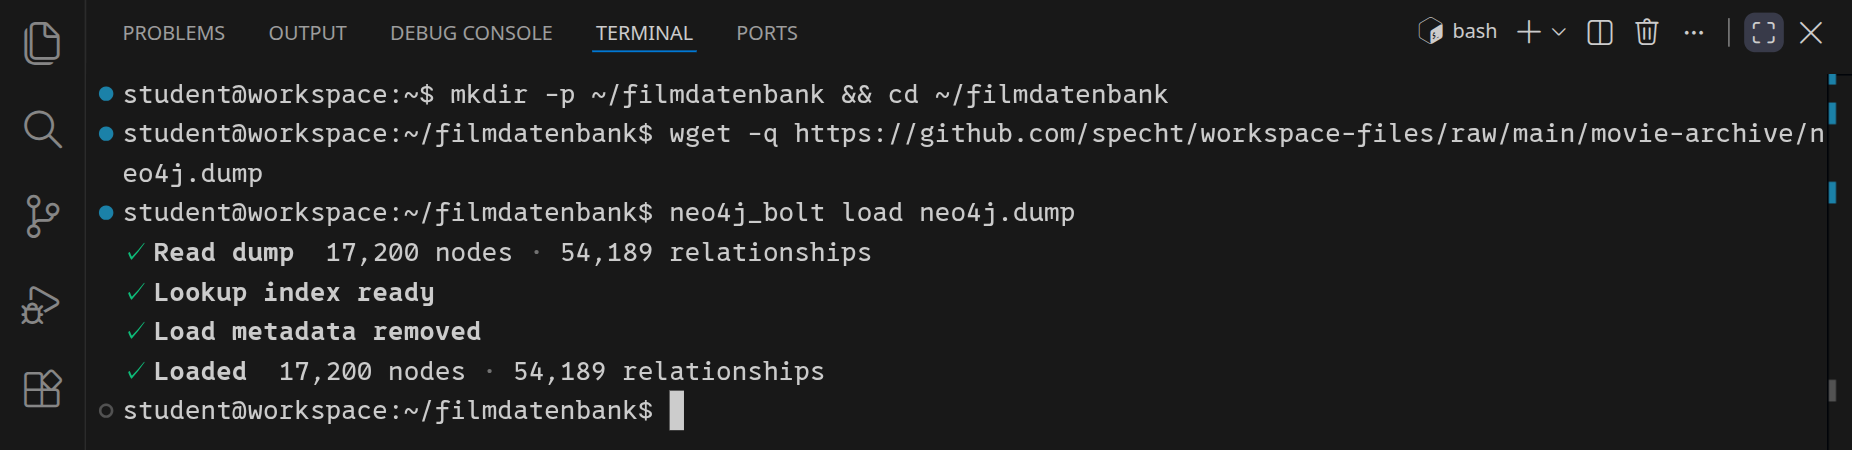
neo4j.dump ist eine Textdatei: Jede Zeile beginnt mit n für einen Knoten oder mit r für eine Beziehung. neo4j_bolt legt erst alle Knoten an und verbindet sie dann. Die Daten stammen, wie die für MySQL, aus Wikidata.
neo4j_bolt load erwartet eine leere Datenbank. Hast du schon etwas ausprobiert, setze deine Neo4j-Datenbank im Profil zurück und lade dann noch einmal.
Abfragen schreibst du in Cypher. Dafür gibt es zwei Werkzeuge:
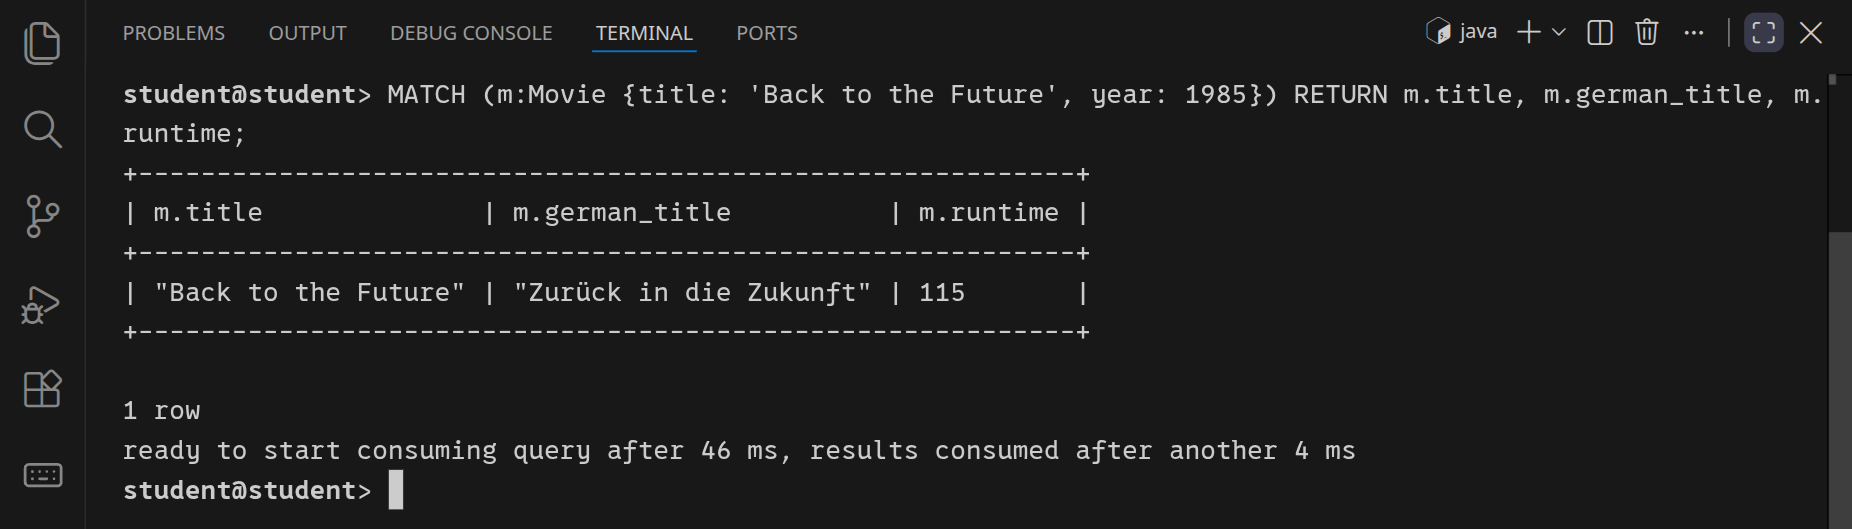
cypher-shell läuft im Terminal des Workspace und meldet sich mit deinen Umgebungsvariablen von selbst an. Er zeigt Ergebnisse als Tabelle, wie mycli für MySQL. Mit :exit beendest du ihn.Fang im Neo4j Browser an:
MATCH (n)
RETURN n
LIMIT 25;
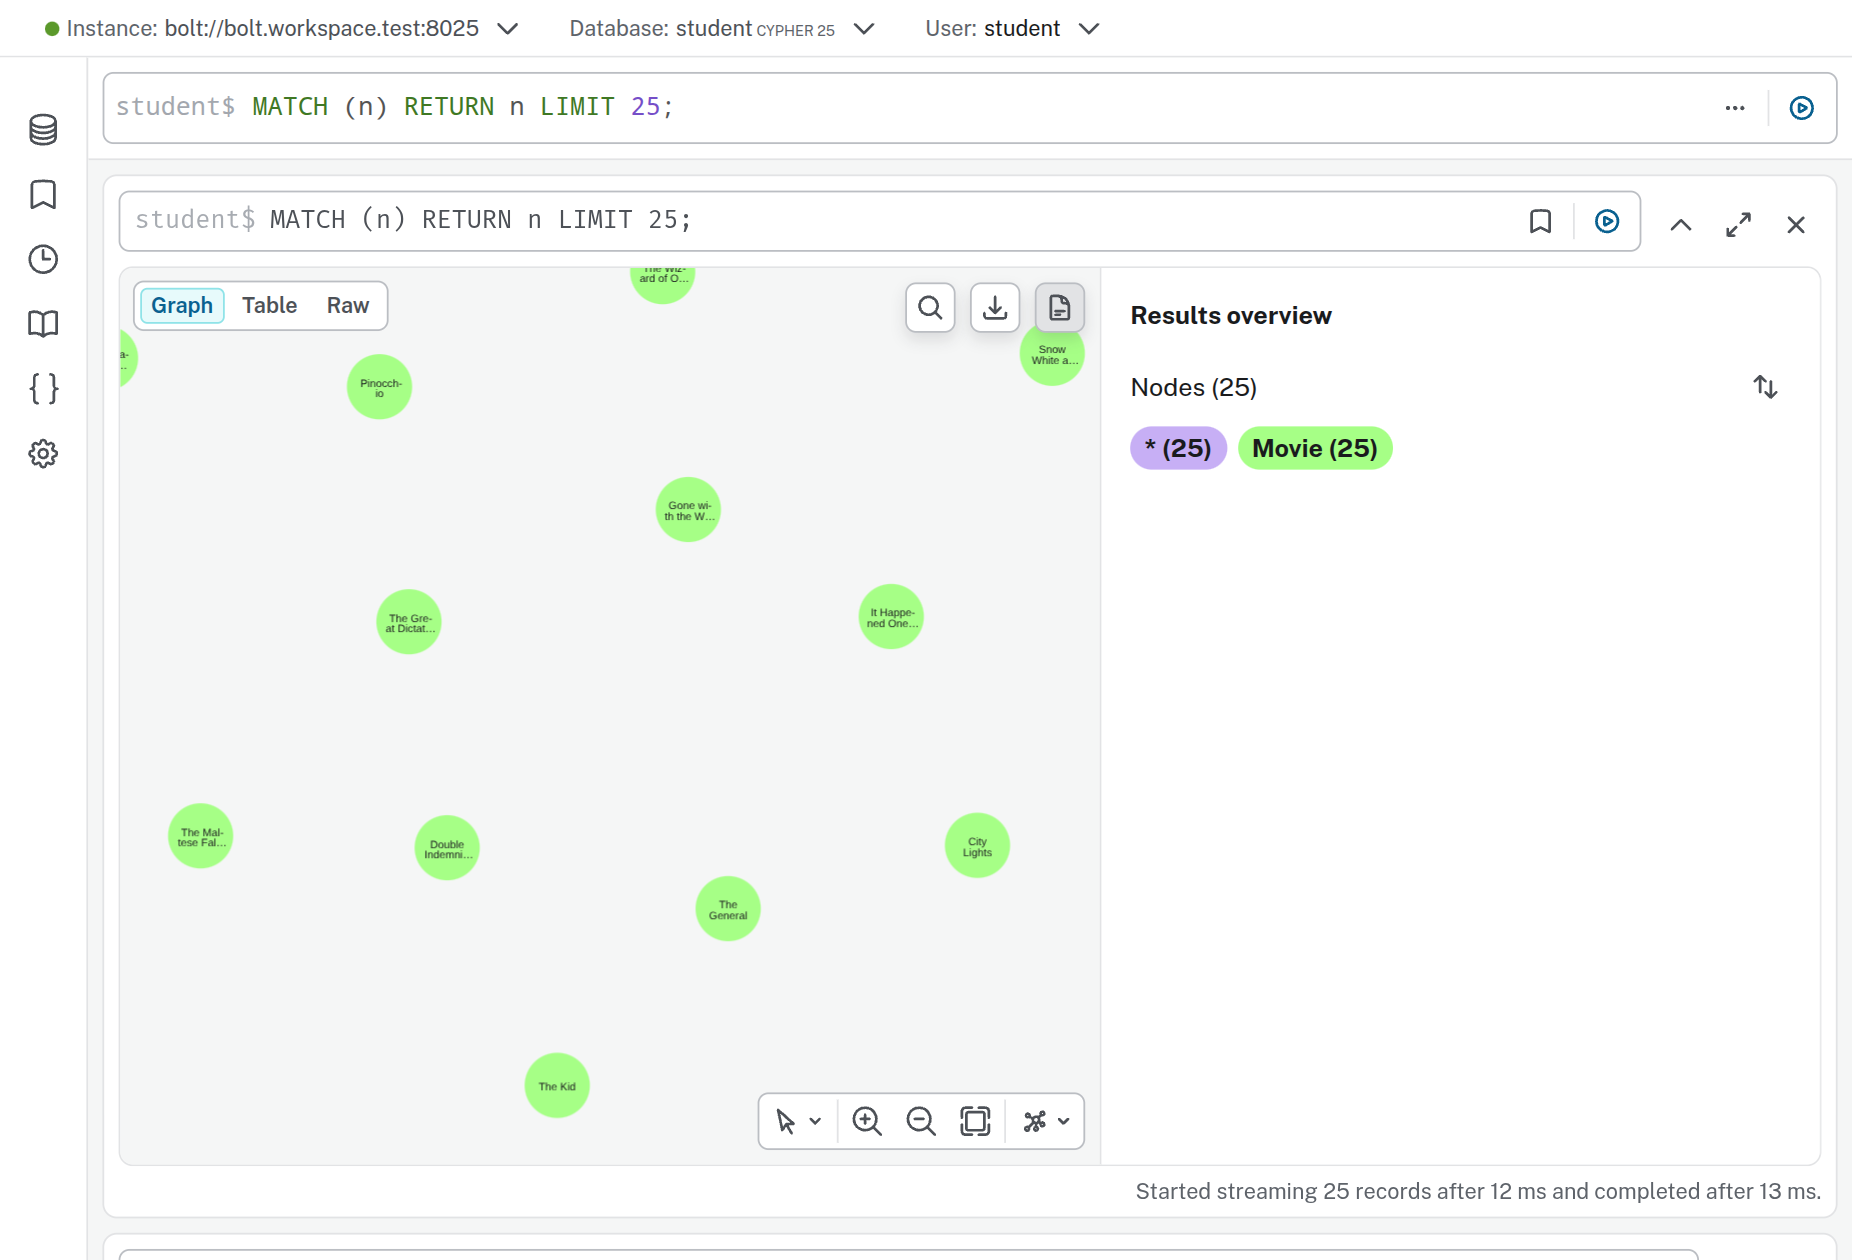
Die Abfrage bedeutet:
MATCH (n)   finde Knoten, und nenne jeden gefundenen Knoten n
RETURN n    gib diese Knoten zurück
LIMIT 25    höchstens 25
n ist ein frei gewählter Name, wie ein Alias in SQL. Mit einem Label findest du nur Knoten einer Art:
MATCH (m:Movie)
RETURN m
LIMIT 10;
Probier das auch für Person und Genre aus.
Wie in SQL filterst du mit WHERE:
MATCH (m:Movie)
WHERE m.title = 'Back to the Future' AND m.year = 1985
RETURN m;
Kürzer schreibst du die Eigenschaften direkt in das Muster:
MATCH (m:Movie {title: 'Back to the Future', year: 1985})
RETURN m;
Beide Abfragen finden denselben Film. Willst du nur einige Eigenschaften, nennst du sie hinter RETURN. Das Ergebnis ist dann eine Tabelle, auch im Terminal:
MATCH (m:Movie {title: 'Back to the Future', year: 1985})
RETURN m.title, m.german_title, m.runtime;
Jetzt kommt der Unterschied zu MySQL. Welche Genres hat »Back to the Future«? In MySQL brauchtest du dafür zwei JOINs, über movie_genre zu genre. Im Graphen liegt die Beziehung schon da, und du schreibst sie als Muster hin:
MATCH (m:Movie {title: 'Back to the Future', year: 1985})-[:IN_GENRE]->(g:Genre)
RETURN m, g;
Lies das Muster wie eine kleine Zeichnung:
(m:Movie {…}) ist der Filmknoten,-[:IN_GENRE]-> eine Beziehung dieses Typs, in Pfeilrichtung,(g:Genre) der Genreknoten am anderen Ende.Brauchst du nur die Namen, gibst du nur sie zurück:
MATCH (m:Movie {title: 'Back to the Future', year: 1985})-[:IN_GENRE]->(g:Genre)
RETURN g.name;
Das ist die Idee von Cypher: Du beschreibst den Ausschnitt des Graphen, den du suchst, und Neo4j findet alle Stellen, an denen er vorkommt.
Was findet MATCH (g:Genre)-[:IN_GENRE]->(m:Movie) RETURN m?
Die Daten legen jede IN_GENRE-Beziehung vom Film zum Genre an. Probier es aus.
Zu einem Film führen Beziehungen verschiedener Typen. Lässt du den Typ weg, passt jede:
MATCH (p:Person)-[r]->(m:Movie {title: 'Back to the Future', year: 1985})
RETURN p, r, m;
Die Beziehung hat jetzt einen Namen, r. Damit fragst du ihren Typ ab:
MATCH (p:Person)-[r]->(m:Movie {title: 'Back to the Future', year: 1985})
RETURN type(r) AS job, p.name
ORDER BY job, p.name;
In MySQL war die Tätigkeit eine eigene Tabelle, die du mit einem weiteren JOIN nachschlagen musstest. Hier ist sie Teil der Beziehung.
MATCH (m:Movie)-[:IN_GENRE]->(:Genre {name: 'Animation'})
RETURN m.title, m.year
ORDER BY m.year DESC
LIMIT 10;
Ein Knoten im Muster braucht keinen Namen, wenn du ihn später nicht mehr verwendest, wie hier das Genre. Zum Vergleich der Weg in SQL:
SQL:     movie JOIN movie_genre JOIN genre WHERE genre.name = 'Animation'
Cypher:  (:Movie)-[:IN_GENRE]->(:Genre {name: 'Animation'})
Sci-Fi) ab dem Jahr 2010 enthält die Datenbank, die neuesten zuerst?Comedy und zu Sci-Fi? Tipp: Ein Muster darf zwei Beziehungen vom selben Film aus haben, (g1:Genre)<-[:IN_GENRE]-(m:Movie)-[:IN_GENRE]->(g2:Genre).Auch Cypher kennt count(), avg(), min() und max(). Wie viele Filme gibt es pro Genre?
MATCH (m:Movie)-[:IN_GENRE]->(g:Genre)
RETURN g.name, count(m) AS movies
ORDER BY movies DESC;
Ein GROUP BY gibt es nicht. Cypher gruppiert von selbst nach allem, was hinter RETURN steht und nicht gezählt wird, hier nach g.name. Auch Durchschnitte gehen so:
MATCH (m:Movie)-[:IN_GENRE]->(g:Genre)
RETURN g.name, count(m) AS movies, round(avg(m.runtime)) AS minutes
ORDER BY minutes DESC;
In MySQL brauchte die Frage »Wer führte bei ›Back to the Future‹ Regie?« drei JOINs. Im Graphen ist das gesuchte Muster fast schon die Antwort:
MATCH (p:Person)-[:DIRECTOR]->(:Movie {title: 'Back to the Future', year: 1985})
RETURN p.name;
Gesucht sind Personen, die in einem Film mitgespielt und bei demselben Film Regie geführt haben. Welches Muster findet sie?
Neo4j wird oft »schemalos« genannt: Du musst keine Tabellen anlegen, bevor du Knoten speicherst. Regeln sind trotzdem sinnvoll. In MySQL hatte jede Tabelle einen Primärschlüssel; auch hier soll es keine zwei Filme mit derselben id geben. Lege dafür drei Schlüssel an:
CREATE CONSTRAINT movie_id IF NOT EXISTS FOR (m:Movie) REQUIRE m.id IS NODE KEY;
CREATE CONSTRAINT genre_id IF NOT EXISTS FOR (g:Genre) REQUIRE g.id IS NODE KEY;
CREATE CONSTRAINT person_id IF NOT EXISTS FOR (p:Person) REQUIRE p.id IS NODE KEY;
Ein Schlüssel verlangt: Jeder Knoten mit diesem Label hat die Eigenschaft, und kein Wert kommt doppelt vor. Das ist, was ein Primärschlüssel in MySQL tut. Versuch danach, einen zweiten Film mit der id von »Back to the Future« anzulegen, und lies die Fehlermeldung:
MATCH (m:Movie {title: 'Back to the Future', year: 1985})
CREATE (:Movie {id: m.id, title: 'Doppelt'});
Für Eigenschaften, nach denen du oft suchst, legst du Indizes an. Sie beschleunigen die Suche, verbieten aber nichts:
CREATE INDEX movie_title IF NOT EXISTS FOR (m:Movie) ON (m.title);
CREATE INDEX person_name IF NOT EXISTS FOR (p:Person) ON (p.name);
SHOW CONSTRAINTS; und SHOW INDEXES; zeigen, was es gibt.
id, die es nicht gibt, kann gar nicht entstehen.
Jetzt die Frage, mit der die Filmdatenbank aufgehört hat: Welche zwei Schauspielerinnen oder Schauspieler standen besonders oft gemeinsam vor der Kamera? Im Graphen ist das ein Muster aus zwei Personen und einem gemeinsamen Film:
(:Person)-[:ACTOR]->(:Movie)<-[:ACTOR]-(:Person)
In einem Film spielen drei Personen mit. Wie viele Zeilen liefert
MATCH (a:Person)-[:ACTOR]->(m)<-[:ACTOR]-(b:Person) RETURN a.name, b.name
für diesen Film, also ohne WHERE a.id < b.id?
In Cypher:
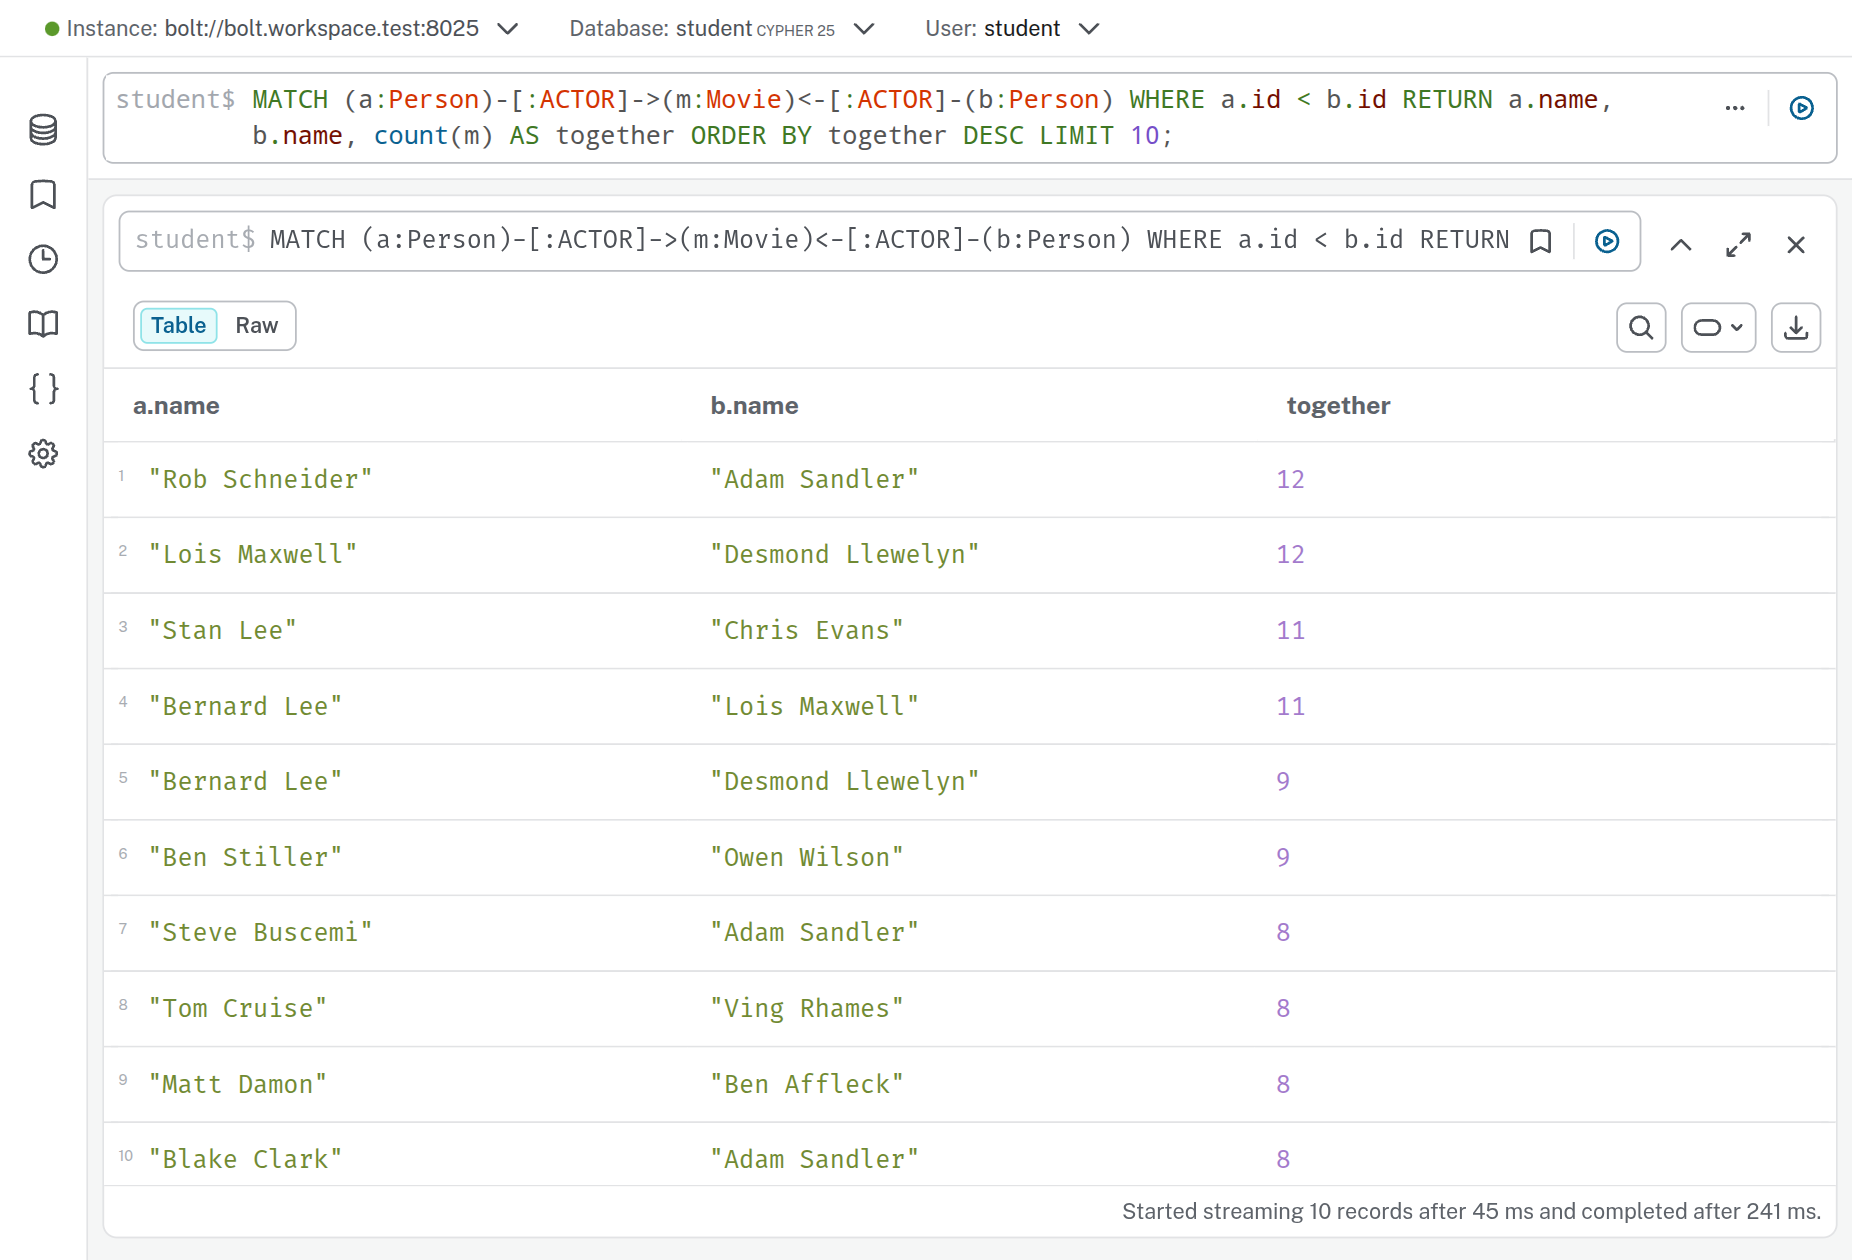
MATCH (a:Person)-[:ACTOR]->(m:Movie)<-[:ACTOR]-(b:Person)
WHERE a.id < b.id
RETURN a.name, b.name, count(m) AS together
ORDER BY together DESC
LIMIT 10;
Wie in SQL sorgt a.id < b.id dafür, dass jedes Paar einmal vorkommt und niemand mit sich selbst. Der Rest ist das Muster selbst: zwei Personen, ein Film, zweimal ACTOR. Vergleich das mit der SQL-Abfrage, die jede Tabelle zweimal brauchte.
Gibt es Paare aus Regie und Kamera, die immer wieder zusammenarbeiten? Das Muster ändert sich nur bei den Typen:
MATCH (d:Person)-[:DIRECTOR]->(m:Movie)<-[:CINEMATOGRAPHER]-(c:Person)
WITH d, c, count(m) AS together
WHERE together >= 3
RETURN d.name AS director, c.name AS cinematographer, together
ORDER BY together DESC;
WITH reicht Zwischenergebnisse weiter, hier die Zahl gemeinsamer Filme. Das WHERE danach filtert die fertigen Paare, so wie HAVING in SQL. In MySQL hätte die Frage movie_crew, job und crew je zweimal gebraucht; hier unterscheiden die Typen DIRECTOR und CINEMATOGRAPHER die beiden Rollen.
Ein Graph kann auch nach Wegen gefragt werden: Wie hängen zwei Personen über Filme zusammen?
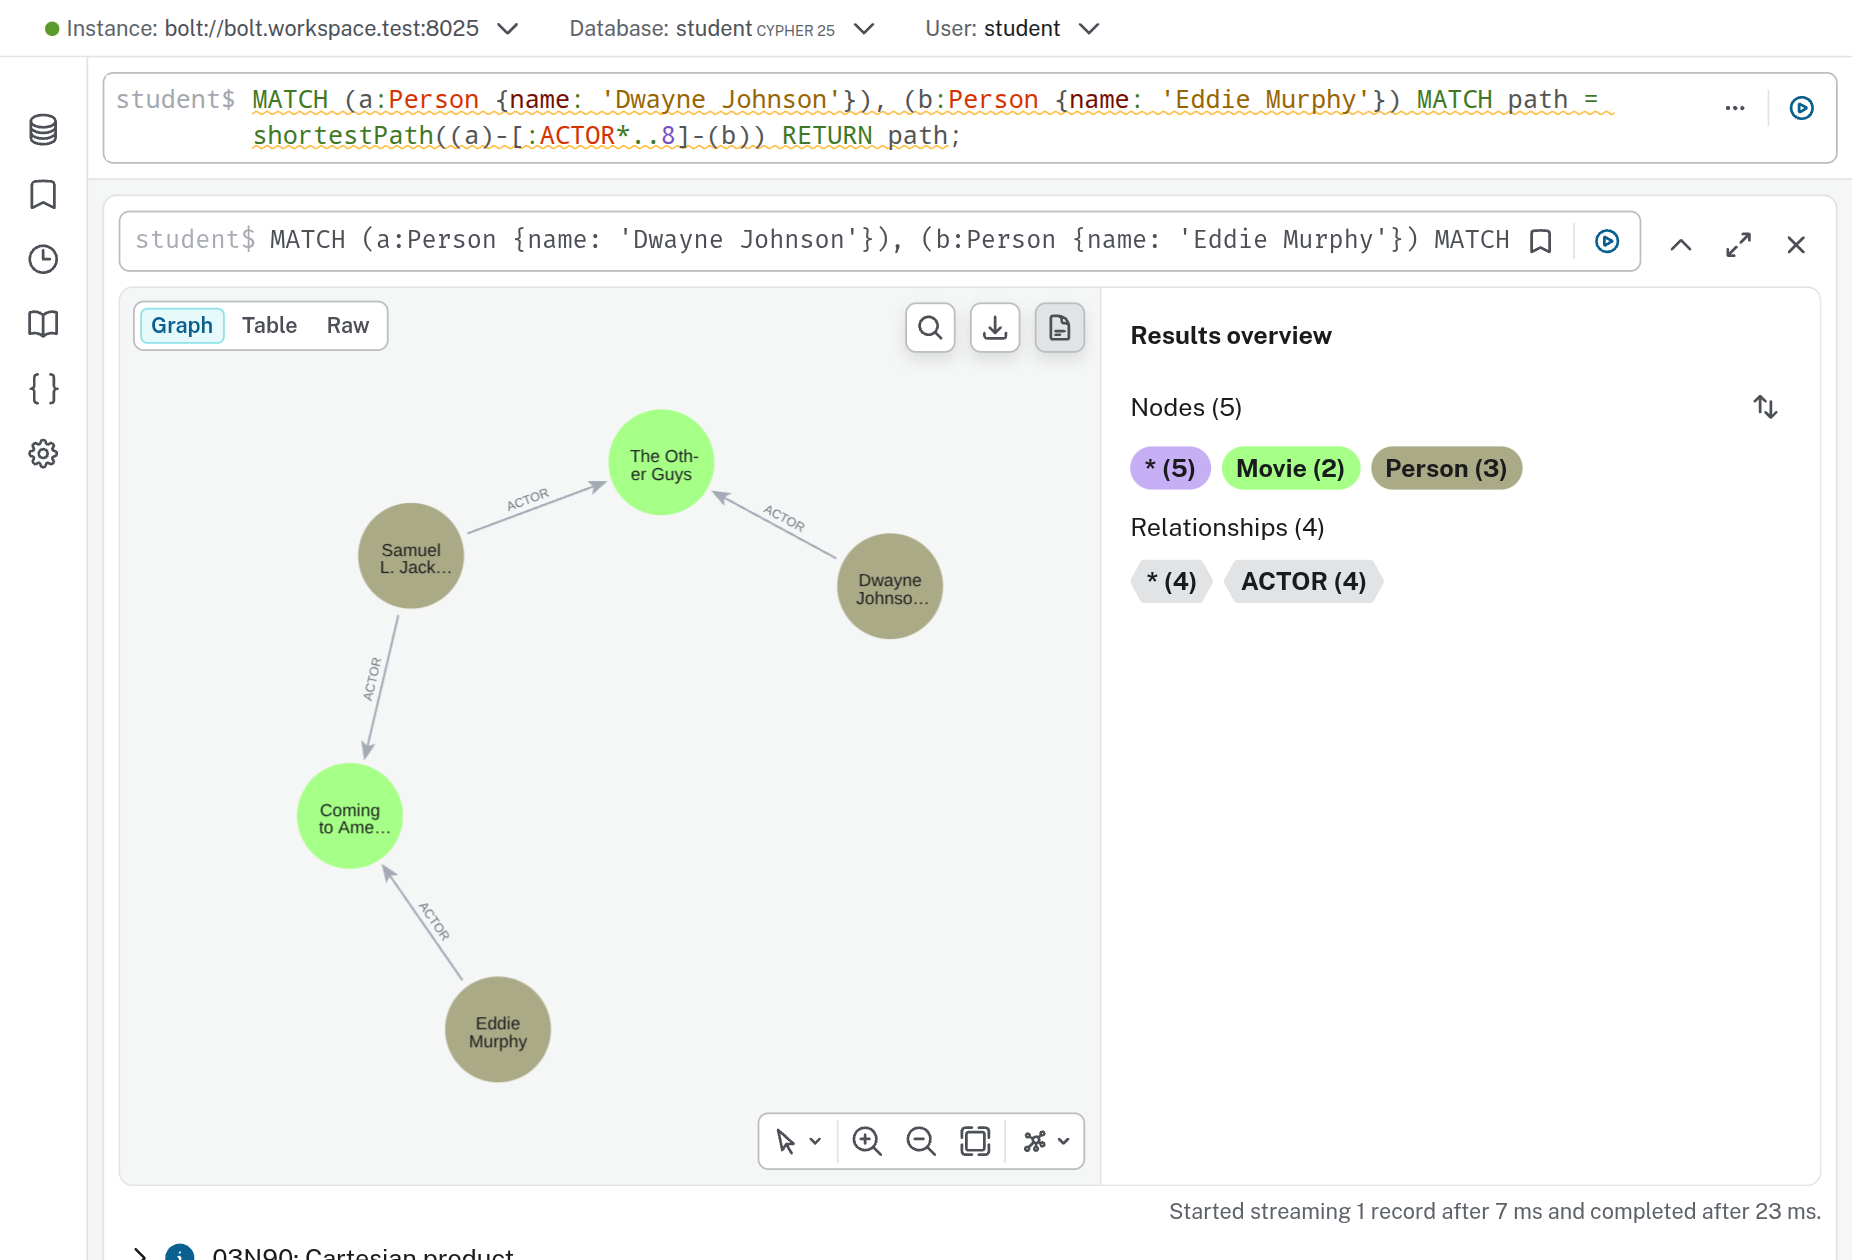
MATCH (a:Person {name: 'Dwayne Johnson'}), (b:Person {name: 'Eddie Murphy'})
MATCH path = shortestPath((a)-[:ACTOR*..8]-(b))
RETURN path;
[:ACTOR*..8] heißt: ein Weg aus höchstens acht ACTOR-Beziehungen, in welche Richtung auch immer. Er führt also nur über Filme und die Menschen, die darin mitgespielt haben: Dwayne Johnson stand mit Samuel L. Jackson für »The Other Guys« vor der Kamera, und Samuel L. Jackson mit Eddie Murphy für »Coming to America«. Im Neo4j Browser siehst du das Ergebnis als Kette aus Personen und Filmen. Ohne :ACTOR darf der Weg jede Beziehung nehmen und führt dann über das Genre Action. Das stimmt, sagt aber nichts darüber, wer mit wem gearbeitet hat.
Du hast dieselben Filmdaten in MySQL und in Neo4j abgefragt. Nenne eine Frage, die du lieber in MySQL stellst, und eine, die du lieber in Neo4j stellst, und begründe beides.
IN_GENRE, ACTOR oder DIRECTOR. Zwischentabellen und die Tabelle job aus MySQL werden zu Beziehungen und ihren Typen.MATCH beschreibt ein Muster, WHERE filtert, RETURN sagt, was herauskommt. Gruppiert wird von selbst, WITH reicht Zwischenergebnisse weiter.IS NODE KEY) übernehmen die Aufgabe von Primärschlüsseln, Indizes beschleunigen Suchen.Eine Graphdatenbank ist nicht besser als eine relationale. MySQL hat dir mit Tabellen, Primär- und Fremdschlüsseln eine klare Struktur gegeben. Aber sobald die Verbindungen selbst die Frage sind, wer mit wem, über welche Wege, lassen sie sich als Graph direkt hinschreiben.