powered by 
Eine Liste speichert Werte in einer Reihenfolge. Wie sie das tut, entscheidet, was schnell geht und was nicht: Eine Array List findet jeden Index sofort und muss beim Einfügen rücken, eine Linked List biegt nur zwei Referenzen um und muss dafür laufen. Stack und Queue sind Listen, die nur an den Enden arbeiten, und eine Queue passt mit einem Ring Buffer in ein festes Array. Hier steht jede Speicherform als Pseudocode und zum Durchklicken.
Eine Liste hält Werte in einer festen Reihenfolge, jeder an einem Index von 0 bis size − 1. Die wichtigsten Operationen:
get(i) gibt den Wert an Index \(i\) zurück,insert(i, value) fügt einen Wert an Index \(i\) ein, alles ab \(i\) rückt einen Index weiter,remove_at(i) nimmt den Wert an Index \(i\) heraus, alles dahinter rückt nach vorn,size sagt, wie viele Werte darin sind.Ein Index außerhalb von 0 bis size − 1 ist ein Fehler, bei insert ist zusätzlich size erlaubt (hinten anhängen). Diese Schnittstelle lässt sich auf zwei grundverschiedene Arten bauen, mit einem Array oder mit verketteten Knoten. Von außen verhalten sich beide gleich, innen kosten dieselben Aufrufe ganz verschieden viel.
Eine Array List legt ihre Werte in die ersten size Zellen eines Arrays. Das Array hat eine Kapazität, meist mehr Zellen als gerade gebraucht.
Die Zelle \(i\) liegt an einer festen Stelle im Speicher: Anfang des Arrays plus \(i\)-mal die Größe einer Zelle. get(i) ist deshalb sofort fertig, egal wie lang die Liste ist.
Soll ein Wert an Index \(i\) hinein, muss dort erst Platz werden: Jeder Wert ab \(i\) rückt eine Zelle nach rechts, und zwar von hinten angefangen, sonst überschreibt der erste Schritt den nächsten Wert. remove macht es umgekehrt und rückt von vorn nach links.
insert(i, value):
    if i < 0 or i > size: error
    if size == capacity: grow
    for j from size - 1 down to i:
        cells[j + 1] ← cells[j]
    cells[i] ← value
    size ← size + 1

remove_at(i):
    if i < 0 or i ≥ size: error
    value ← cells[i]
    for j from i to size - 2:
        cells[j] ← cells[j + 1]
    size ← size - 1
    return value
Ist das Array voll, kommt ein neues, doppelt so großes, und alle Werte werden hinüberkopiert. Das ist teuer, passiert aber selten: Nach dem Kopieren von 4 Werten ist Platz für 4 weitere, nach dem Kopieren von 8 für 8 weitere. Auf jeden angehängten Wert kommt so im Mittel weniger als eine Kopie. Wer das Array stattdessen jedes Mal nur um eine Zelle vergrößert, kopiert bei jedem Anhängen alles.
Probier es mit einem Array mit vier Zellen und den Aufrufen der Data Structures Sandbox aus; der fünfte Wert kommt vorn hin, und dafür muss das Array wachsen:
Und remove in derselben Liste, einmal in der Mitte, einmal vorn:
Typische Fehler
size nicht ändern oder an der falschen Stelle: Der Wert ist im Array, aber nicht in der Liste.remove die letzte Zelle nicht leeren: Bei Zahlen ist das egal, bei Objekten hält die Liste so einen Wert fest, den es nicht mehr gibt.Eine Linked List braucht kein großes Array. Jeder Wert steckt in einem eigenen Knoten, und jeder Knoten kennt seinen Nachfolger: Er hat ein Feld value und ein Feld next, das auf den nächsten Knoten zeigt oder auf nichts. Die Liste selbst merkt sich nur den ersten Knoten, head, und meist size.
Wo der Knoten mit Index \(i\) liegt, weiß niemand. Man findet ihn nur, indem man bei head anfängt und \(i\)-mal next folgt. Darum braucht get(i) bei einer Linked List bis zu size Schritte.
node_at(i):
    k ← head
    repeat i times:
        k ← k.next
    return k
Zum Einfügen läuft man zum Knoten vor dem Index, dem Vorgänger. Dann zeigt der neue Knoten auf den bisherigen Nachfolger, und der Vorgänger zeigt auf den neuen Knoten. Die Reihenfolge ist wichtig: Erst den neuen Knoten verbinden, dann den Vorgänger umbiegen, sonst ist der Rest der Liste verloren. Am Anfang der Liste gibt es keinen Vorgänger, dort wird head umgebogen.
insert(i, value):
    if i < 0 or i > size: error
    new ← a node with value
    if i == 0:
        new.next ← head
        head ← new
    else:
        before ← node_at(i - 1)
        new.next ← before.next
        before.next ← new
    size ← size + 1

remove_at(i):
    if i < 0 or i ≥ size: error
    if i == 0:
        value ← head.value
        head ← head.next
    else:
        before ← node_at(i - 1)
        value ← before.next.value
        before.next ← before.next.next
    size ← size - 1
    return value
Dieselben Aufrufe wie oben, jetzt auf einer Linked List. Die Knoten liegen irgendwo im Speicher; gezeichnet sind sie in der Reihenfolge der Liste:
Und remove, einmal in der Mitte, einmal vorn:
Dasselbe geht ohne node_at und ohne den Sonderfall vorn: Jeder Aufruf kümmert sich um einen Knoten und gibt zurück, was an seiner Stelle stehen soll. Der Knoten, der heraus soll, gibt seinen Nachfolger zurück, und der Knoten davor trägt ihn in sein next ein. Alle anderen geben sich selbst zurück. Aufgerufen wird es als head ← remove_at(head, i); so arbeiten auch Suchbäume.
remove_at(node, i):
    if node == null: error
    if i == 0: return node.next
    node.next ← remove_at(node.next, i - 1)
    return node
Typische Fehler
before.next ← new, dann new.next ← before.next: Der neue Knoten zeigt auf sich selbst, die Liste wird zum Kreis.i == 0 vergessen: Es gibt keinen Vorgänger, node_at(-1) geht schief.insert(i, …) und remove_at(i) braucht man den Knoten an \(i - 1\), nicht an \(i\).size vergessen. Die Sandbox prüft, dass size zur Zahl der Knoten passt.Eine doppelt verkettete Linked List gibt jedem Knoten zusätzlich prev, den Vorgänger, und merkt sich neben head auch tail, den letzten Knoten. Dann geht Anhängen und Entfernen an beiden Enden ohne Laufen, und man kann rückwärts laufen. Dafür muss jedes insert und remove vier Referenzen richtig setzen statt zwei.
Eine sortierte Liste hat kein insert(i, value), sondern nur insert(value): Sie sucht die Stelle selbst, sodass die Werte immer aufsteigend bleiben.
find_position(cells, size, value):
    left ← 0
    right ← size
    while left < right:
        middle ← (left + right) / 2, rounded down
        if cells[middle] < value: left ← middle + 1
        else: right ← middle
    return left
find_position gibt den ersten Index zurück, an dem ein Wert steht, der nicht kleiner ist als value. Genau dort wird eingefügt, und genau dort steht der Wert, wenn man ihn sucht. Ob doppelte Werte erlaubt sind, legt die Aufgabe fest; die Sandbox prüft es.
Ein Stack kann nur an einem Ende arbeiten, oben:
push(value) legt einen Wert oben drauf,pop() nimmt den obersten Wert weg und gibt ihn zurück,peek() zeigt den obersten, ohne ihn wegzunehmen.Was zuletzt hineinkam, kommt zuerst heraus: LIFO, last in, first out. Ein Stack steckt in jedem Programm, das Funktionen aufruft: Jeder Aufruf legt fest, wohin es danach zurückgeht, und return nimmt das wieder vom Stack. Die Tiefensuche benutzt einen, und jedes »Rückgängig« in einem Editor auch.
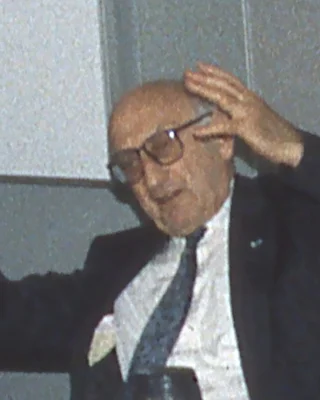
Friedrich L. Bauer (1924–2015, im Bild) und Klaus Samelson (1918–1980), Mathematiker in München, überlegten, wie ein Rechner eine Formel selbst in seine Befehle übersetzen kann. Dafür schlugen sie 1955 einen Speicher vor, bei dem nur zählt, was zuletzt hineinkam, und meldeten ihn 1957 als »Keller« zum Patent an: den Stack.
Sie sahen schon, dass der Keller auch zu Funktionsaufrufen passt, und heute ist es so: Wohin dein Programm nach einem Aufruf zurückkehrt, liegt auf einem Stack. Bauer hielt 1967 an der TU München die erste Vorlesung über Informatik in Deutschland.
Foto: Rolf Kickuth, 1995, CC BY-SA 4.0, zugeschnitten (Wikimedia Commons)
Mit einem Array ist das obere Ende das hintere: push hängt an Index size an, pop nimmt den an size − 1. Nichts muss rücken. Mit Knoten ist das obere Ende der Anfang: push ist insert(0, …), pop ist remove_at(0), und auch da muss nichts laufen.
push(value):
    if size == capacity: full (oder vergrößern)
    cells[size] ← value
    size ← size + 1

pop():
    if size == 0: error, the stack is empty
    size ← size - 1
    return cells[size]
Eine Queue arbeitet an beiden Enden: enqueue(value) stellt hinten an, dequeue() nimmt vorn weg. Was zuerst kam, kommt zuerst dran: FIFO, first in, first out. Die Breitensuche braucht eine, ebenso ein Drucker, der Aufträge der Reihe nach abarbeitet.
Mit Knoten braucht die Queue head und tail: enqueue hängt hinter tail an, dequeue nimmt head weg. Mit einem einfachen Array ginge dequeue als remove_at(0), aber dann rückt bei jedem dequeue die ganze Queue.
Ein Ring Buffer lässt die Werte stehen und bewegt stattdessen den Anfang. Er merkt sich head, den Index des vordersten Werts, und size. Der nächste freie Platz ist size Zellen hinter head. Läuft die Queue hinten aus dem Array, geht es vorn weiter, als wären die Zellen im Kreis angeordnet: Dafür sorgt der Rest der Division, mod.
enqueue(value):
    if size == capacity: error, the queue is full
    cells[(head + size) mod capacity] ← value
    size ← size + 1

dequeue():
    if size == 0: error, the queue is empty
    value ← cells[head]
    head ← (head + 1) mod capacity
    size ← size - 1
    return value
Sechs Zellen; vorn sind schon zwei Werte herausgekommen, deshalb steht head bei 2. Was jetzt hinten hineinkommt, läuft über das Ende des Arrays hinaus nach vorn:
Und dequeue aus der vollen Queue: head läuft hinterher, ebenfalls um das Ende herum:
Typische Fehler
tail speichern und »voll« mit »leer« verwechseln: Bei beiden ist head == tail. Mit size gibt es das Problem nicht.mod in Sprachen, in denen der Rest negativ werden kann (Java, JavaScript, C): head - 1 mod 6 ist dort −1. Beim Rückwärtsgehen vorher die Kapazität addieren.dequeue setzt head weiter, vergisst aber size: Dann ist die Queue scheinbar nie leer.Die Zahl der Schritte für eine Liste mit \(n\) Werten. »sofort« heißt: gleich viele Schritte, egal wie lang die Liste ist.
| get(i) | insert vorn | insert hinten | insert in der Mitte | Platz | |
|---|---|---|---|---|---|
| Array List | sofort | \(n\) rücken | sofort, selten kopieren | \(n/2\) rücken | Array, oft halb leer |
| Linked List | \(i\) laufen | sofort | \(n\) laufen, mit tail sofort |
\(n/2\) laufen | ein next je Wert |
| Ring Buffer | sofort | sofort | sofort | – | fest, kann voll werden |
In der Praxis gewinnt die Array List fast immer, auch wenn die Tabelle anders aussieht: Ihre Werte liegen nebeneinander im Speicher, und Prozessoren lesen Nachbarzellen viel schneller als Knoten, die irgendwo verstreut sind. Eine Linked List lohnt sich, wenn man oft an einer Stelle einfügt, an der man ohnehin schon ist.
Die Array List bringen Ruby und Python fertig mit, als Array und als list; mit push (Python: append) und pop ist sie auch ein Stack. Eine Queue, die vorn schnell herausnimmt, ist in Python collections.deque, in Ruby ein Array mit push und shift.
Array: alle Methoden von Rubys Array List, darunter insert, delete_at, push, pop und shift. Für sortierte Listen findet bsearch_index die Stelle mit binärer Suche.list kann, und warum eine Queue besser eine deque ist.collections.deque: eine Queue, die an beiden Enden schnell einfügt und herausnimmt.bisect: binäre Suche in einer sortierten Liste; bisect_left tut dasselbe wie find_position oben.