powered by 
Ein binärer Suchbaum hält Werte so geordnet, dass Suchen, Einfügen und Entfernen nur einen Weg von oben nach unten brauchen: links das Kleinere, rechts das Größere. Damit das schnell bleibt, darf der Baum nicht zu einer langen Kette werden; ein AVL-Baum verhindert das mit Rotationen. Hier steht jeder Schritt als Pseudocode und zum Durchklicken, dazu die drei Arten, einen Baum zu durchlaufen.
Ein Baum besteht aus Knoten. Ganz oben steht die Wurzel, jeder Knoten hat höchstens zwei Kinder, ein linkes und ein rechtes, und jeder Knoten außer der Wurzel genau ein Elternteil. Ein Knoten ohne Kinder heißt Blatt. Jedes Kind ist selbst wieder die Wurzel eines kleineren Baums, seines Teilbaums: Darum lässt sich fast alles an Bäumen rekursiv schreiben.
Ein binärer Suchbaum hat eine Regel: Für jeden Knoten stehen in seinem linken Teilbaum nur kleinere Werte, in seinem rechten nur größere. Nicht nur das direkte Kind, der ganze Teilbaum.
Die Regel sagt bei jedem Knoten, wohin es weitergeht: Ist der gesuchte Wert kleiner, nach links, ist er größer, nach rechts. Endet der Weg an einer leeren Stelle, ist der Wert nicht im Baum.
find(node, value):
    if node == null: not found
    if value == node.value: found
    if value < node.value: return find(node.left, value)
    else: return find(node.right, value)
Einfügen ist Suchen: Man sucht den Wert, und an der leeren Stelle, an der die Suche endet, kommt der neue Knoten hin. Der Baum wächst immer unten.
insert(node, value):
    if node == null: return a new node with value
    if value < node.value: node.left ← insert(node.left, value)
    if value > node.value: node.right ← insert(node.right, value)
    return node
Dass insert den Knoten zurückgibt und der Aufrufer ihn wieder einträgt, ist der Trick: So braucht kein Knoten sein Elternteil zu kennen, und die leere Wurzel ist kein Sonderfall (root ← insert(root, value)).
Acht Werte nacheinander:
Und im fertigen Baum zwei Suchen, eine erfolgreich und eine nicht:
Ein Knoten wird zuerst gesucht. Dann gibt es drei Fälle:
remove(node, value):
    if node == null: return null
    if value < node.value: node.left ← remove(node.left, value)
    else if value > node.value: node.right ← remove(node.right, value)
    else:
        if node.left == null: return node.right
        if node.right == null: return node.left
        successor ← node.right
        while successor.left != null: successor ← successor.left
        node.value ← successor.value
        node.right ← remove(node.right, successor.value)
    return node
Derselbe Baum, dann alle drei Fälle nacheinander: 20 ist ein Blatt, 40 hat ein Kind, 50 hat zwei:
Typische Fehler
remove nicht eintragen: Der Knoten ist »entfernt«, hängt aber noch am Elternteil.Um jeden Knoten einmal zu besuchen, etwa zum Ausgeben oder Zählen, geht man rekursiv in beide Teilbäume. Die drei Arten unterscheiden sich nur darin, wann der Knoten selbst drankommt:
inorder(node):
    if node == null: done
    inorder(node.left)
    visit node
    inorder(node.right)
Die Höhe eines Baums ist die Zahl der Knoten auf dem längsten Weg von der Wurzel nach unten, ein leerer Baum hat die Höhe 0:
height(node):
    if node == null: return 0
    return 1 + the larger of height(node.left) and height(node.right)
Suchen, Einfügen und Entfernen laufen einen Weg von der Wurzel nach unten, sie brauchen also so viele Schritte, wie der Baum hoch ist. Ein gut gemischter Baum mit einer Million Werten ist etwa 20 Ebenen hoch. Kommen die Werte aber sortiert an, hängt jeder rechts am vorigen, und der Baum wird eine Kette:
Das ist eine Linked List mit Umwegen: Bei einer Million Werten braucht die Suche eine Million Schritte.
Ein AVL-Baum (nach Adelson-Velski und Landis) hält sich selbst ausgeglichen. Jeder Knoten speichert seine Höhe, und für jeden Knoten gilt: Die Höhen seines linken und rechten Teilbaums unterscheiden sich höchstens um 1. Ein AVL-Baum mit \(n\) Werten ist höchstens etwa \(1{,}44 \log_2 n\) hoch.
Nach jedem Einfügen geht man den Weg zurück nach oben, berechnet die Höhen neu und prüft die Regel. Der erste Knoten, bei dem sie verletzt ist, wird mit einer Rotation repariert.
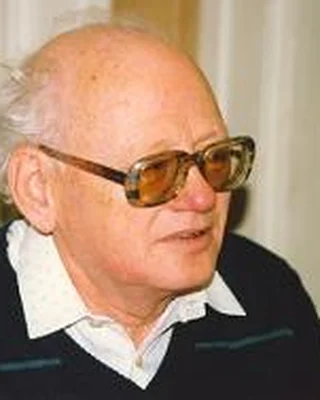
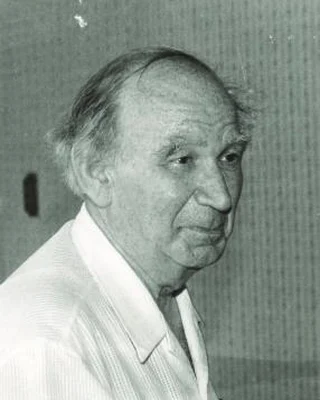
Georgi Adelson-Velski (1922–2014) und Jewgeni Landis (1921–1997), Mathematiker in Moskau, erfanden 1962 den AVL-Baum: den ersten Suchbaum, der sich selbst ausgleicht. Die Buchstaben AVL sind ihre Namen.
Adelson-Velski schrieb auch an Kaissa mit, dem Schachprogramm, das 1974 die erste Weltmeisterschaft im Computerschach gewann.
Fotos: Monroe Newborn, 1980, CC BY 3.0 (Wikimedia Commons); Konrad Jacobs, 1987, CC BY-SA 2.0 de (Wikimedia Commons), beide zugeschnitten
Eine Rotation nach rechts um einen Knoten \(y\) mit linkem Kind \(x\) hebt \(x\) nach oben: \(y\) wird das rechte Kind von \(x\), und der rechte Teilbaum von \(x\) wechselt als linker Teilbaum zu \(y\). Die Suchregel bleibt erfüllt, denn dieser Teilbaum liegt zwischen \(x\) und \(y\). Die Rotation nach links ist dasselbe spiegelverkehrt.
rotate_right(y):
    x ← y.left
    y.left ← x.right
    x.right ← y
    update the height of y, then of x
    return x
Welche Rotation nötig ist, hängt davon ab, wo der neue Wert gelandet ist, von dem zu hohen Knoten aus gesehen:
| Fall | der neue Wert liegt | Reparatur |
|---|---|---|
| LL | links vom linken Kind | rechts rotieren |
| RR | rechts vom rechten Kind | links rotieren |
| LR | rechts vom linken Kind | erst das linke Kind links rotieren, dann rechts rotieren |
| RL | links vom rechten Kind | erst das rechte Kind rechts rotieren, dann links rotieren |
Diese acht Werte lösen alle vier Fälle aus, LL, RR, RL und LR in dieser Reihenfolge. Klein neben jedem Knoten steht seine Höhe:
Entfernt wird wie im Suchbaum. Danach kann ein Teilbaum um eins zu niedrig sein, und das zeigt sich auf dem Weg zurück nach oben: Jeder Aufruf berechnet die Höhe seines Knotens neu und repariert ihn, wenn die Regel verletzt ist. Welche Rotation nötig ist, sagt hier nicht der entfernte Wert, sondern das schwerere Kind: Ist sein innerer Teilbaum höher als sein äußerer, braucht es die Doppelrotation.
Anders als beim Einfügen ist mit einer Rotation nicht unbedingt Schluss. Die Rotation macht den Teilbaum um eins niedriger, und dann kann der Knoten darüber schief sein, bis hinauf zur Wurzel.
remove(node, value):
    (wie im Suchbaum)
    update the height of node
    return rebalance(node)

rebalance(node):
    if height(node.left) - height(node.right) > 1:
        if height(node.left.left) < height(node.left.right):
            node.left ← rotate_left(node.left)
        return rotate_right(node)
    if height(node.right) - height(node.left) > 1:
        if height(node.right.right) < height(node.right.left):
            node.right ← rotate_right(node.right)
        return rotate_left(node)
    return node
Hier fehlt nach dem Entfernen der 10 links ein Stockwerk. Auf dem Weg zurück ist die Wurzel schief, und weil beim schwereren Kind 60 der innere Teilbaum höher ist, braucht sie die Doppelrotation: erst 60 rechts, dann die Wurzel links. In einem größeren Baum könnte danach der Knoten darüber schief sein und die nächste Reparatur brauchen:
Typische Fehler
height(node), die bei leer 0 liefert, stürzt jede Rechnung an einem Blatt ab.Weder Ruby noch Python bringen einen Suchbaum mit. Sollen Schlüssel sortiert bleiben, nimmt man dort meist eine sortierte Liste mit binärer Suche; ist die Reihenfolge egal, eine Hash Table (Hash, dict).
bisect: binäre Suche und Einfügen in einer sortierten Liste.Array#bsearch: binäre Suche in einem sortierten Array.