powered by 
Tipp 2 + 3 * (4 - 1) in einen Taschenrechner, und er weiß, dass erst die Klammer drankommt, dann das Malnehmen und zuletzt das Plus. Woher eigentlich? Du baust einen Rechner, der Ausdrücke versteht, in Ruby oder Python: Er zerlegt den Text in Stücke, baut daraus einen Baum und rechnet den Baum von unten nach oben aus. Genauso fangen Compiler an, die aus deinem Programm Maschinencode machen.
Ein Ausdruck wie 2 + 3 * 4 ist für einen Computer zuerst nur Text, eine Reihe von Zeichen. Von links nach rechts ausgerechnet käme 20 heraus: 2 + 3 ist 5, mal 4 ist 20. Richtig ist 14, denn Malnehmen bindet stärker als Plus. Für Ausdrücke gelten ein paar Regeln, die du aus der Mathematik kennst:
* und / vor + und -.Die letzte Regel klingt selbstverständlich, macht aber einen Unterschied.
Was ergibt 8 - 3 - 2? Überleg zuerst, bevor du es ausprobierst.
Ein Rechner muss diese Regeln kennen. Er arbeitet dafür in drei Schritten:
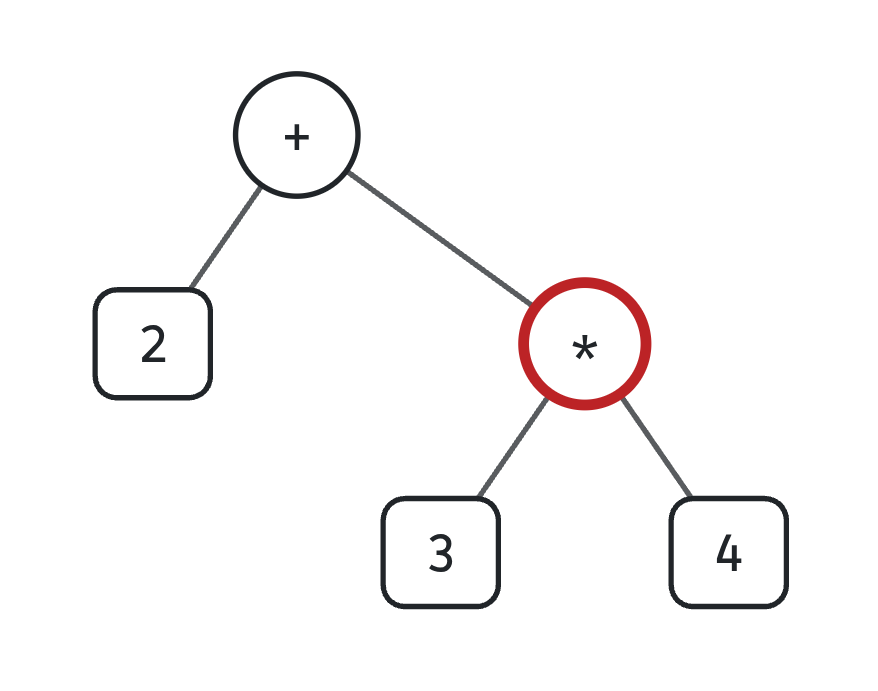
12+3*(4-1) werden Tokens, die kleinsten Stücke, die etwas bedeuten: die Zahl 12, das Zeichen +, die Zahl 3 und so weiter. Leerzeichen fallen dabei weg.So sieht der Baum für 2 + 3 * 4 aus. Das * hängt unter dem +, also wird es zuerst ausgerechnet:
Lege einen Ordner an und öffne ihn mit StrgK StrgO:
mkdir /workspace/calculator
Lege darin calculator.rb an. Die drei Methoden tun noch nichts Richtiges, aber unten wartet schon der Rechner zum Tippen auf dich:
# Ein Rechner für Ausdrücke

# Zerlegt einen Ausdruck in Tokens: Zahlen, Rechenzeichen und Klammern.
def tokenize(text)
    []
end

# Macht aus Tokens einen Baum.
def parse(tokens)
    tokens.first
end

# Rechnet einen Baum aus.
def evaluate(tree, variables = {})
    tree
end

def calculate(text, variables = {})
    evaluate(parse(tokenize(text)), variables)
end

loop do
    print '> '
    line = gets
    if line.nil?
        puts
        break
    end

    line = line.strip
    next if line.empty?

    begin
        p calculate(line)
    rescue ArgumentError => e
        puts "Fehler: #{e.message}"
    end
end
Starte ihn mit ruby calculator.rb und tipp einen Ausdruck. Im Moment kommt nil heraus, egal was du tippst; StrgD beendet ihn. calculate ist schon fertig: Es ruft die drei Schritte nacheinander auf. Die Prüfungen der Aufgaben laden nur deine Methoden und rufen sie direkt auf; die Schleife unten läuft dabei nicht.
Lege darin calculator.py an. Die drei Funktionen tun noch nichts Richtiges, aber unten wartet schon der Rechner zum Tippen auf dich:
# Ein Rechner für Ausdrücke


def tokenize(text):
    """Zerlegt einen Ausdruck in Tokens: Zahlen, Rechenzeichen und Klammern."""
    return []


def parse(tokens):
    """Macht aus Tokens einen Baum."""
    return tokens[0] if tokens else None


def evaluate(tree, variables=None):
    """Rechnet einen Baum aus."""
    return tree


def calculate(text, variables=None):
    return evaluate(parse(tokenize(text)), variables)


while True:
    try:
        line = input('> ').strip()
    except EOFError:
        print()
        break
    if not line:
        continue
    try:
        print(calculate(line))
    except ValueError as error:
        print(f'Fehler: {error}')
Starte ihn mit python3 calculator.py und tipp einen Ausdruck. Im Moment kommt None heraus, egal was du tippst; StrgD beendet ihn. calculate ist schon fertig: Es ruft die drei Schritte nacheinander auf. Die Prüfungen der Aufgaben laden nur deine Funktionen und rufen sie direkt auf; die Schleife unten läuft dabei nicht.
tokenize geht den Text Zeichen für Zeichen durch, mit einem Index i, und entscheidet bei jedem Zeichen, was es ist:
+ - * / ^ ( ) sind je ein Token für sich.3.25.#. Dann bricht tokenize ab, mit einer Meldung, welches Zeichen an welcher Stelle nicht passt.Zahlen kommen als Zahlen in die Liste, alles andere als String: tokenize('12+3*(4-1)') ergibt [12, "+", 3, "*", "(", 4, "-", 1, ")"]. Eine Zahl ohne Punkt wird mit to_i ein Integer, eine mit Punkt mit to_f eine Kommazahl. Ob ein Zeichen c eine Ziffer ist, sagt c =~ /[0-9]/, und einen Fehler meldest du mit raise ArgumentError, "…".
Zahlen kommen als Zahlen in die Liste, alles andere als String: tokenize('12+3*(4-1)') ergibt [12, '+', 3, '*', '(', 4, '-', 1, ')']. Eine Zahl ohne Punkt wird mit int ein int, eine mit Punkt mit float eine Kommazahl. Ob ein Zeichen c eine Ziffer ist, sagt c.isdigit(), und einen Fehler meldest du mit raise ValueError('…').
Was eine Zahl ist, beschreibt ein endlicher Automat, wie du sie aus Endliche Automaten kennst. In Automatron steht z für eine Ziffer und p für den Punkt: z+(pz+)? heißt »mindestens eine Ziffer, danach vielleicht ein Punkt und mindestens eine Ziffer«.
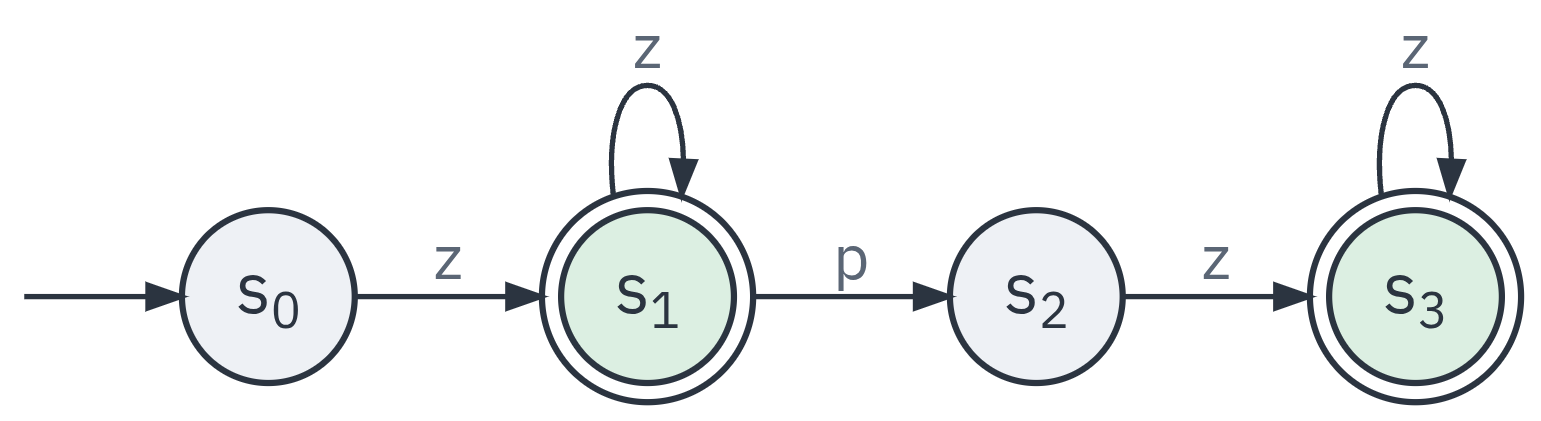
Die Schleifen in tokenize sind dieser Automat: Die erste läuft in s1 im Kreis, solange Ziffern kommen. Ein Punkt führt nach s2, und nur wenn danach wieder eine Ziffer kommt, geht es nach s3 weiter. Hört die Zahl in s2 auf, wie in 3., hat der Automat keine Zahl gelesen. Dein Tokenizer nimmt dann nur die 3 und meldet den Punkt als Zeichen, das nicht passt.
Schreib tokenize in calculator.rb.
Eine while-Schleife mit einem Index i. Bei einer Ziffer läuft eine zweite Schleife weiter, solange Ziffern kommen; text[start...i].to_i macht daraus die Zahl.
Schreib tokenize in calculator.py.
Eine while-Schleife mit einem Index i. Bei einer Ziffer läuft eine zweite Schleife weiter, solange Ziffern kommen; int(text[start:i]) macht daraus die Zahl.
Den Ausdruck 2 + 3 * 4 schreibt der Rechner als Baum, in dem das, was zuerst gerechnet wird, weiter unten hängt: oben das +, links die 2, rechts ein * mit der 3 und der 4. Als Liste ist das
["+", 2, ["*", 3, 4]]
Jeder Knoten ist entweder eine Zahl, ein Blatt, oder eine Liste aus dem Rechenzeichen und den beiden Teilbäumen links und rechts. Ein Minus vor einer Zahl oder einer Klammer ist ein Vorzeichen mit nur einem Teilbaum: -(1 + 2) ist ["neg", ["+", 1, 2]]. Klammern tauchen im Baum gar nicht mehr auf, sie stecken in seiner Form: (2 + 3) * 4 ist ["*", ["+", 2, 3], 4].
Probier es aus. Der Baum steht so, dass du den Ausdruck von links nach rechts lesen kannst. Mit den Pfeilen rechnest du ihn aus, einen Knoten nach dem anderen. Rot umrandet ist der Knoten, der als Nächstes drankommt: immer einer, unter dem nur noch Zahlen hängen.
Für die Tokens hat ein Automat gereicht. Für den Baum reicht er nicht mehr. Um zu wissen, zu welcher Klammer ein ) gehört, muss man sich merken, wie viele Klammern gerade offen sind, und in ((((1)))) können es beliebig viele sein.
Warum kann kein endlicher Automat für jeden Ausdruck entscheiden, ob seine Klammern zusammenpassen?
Was ein Automat nicht kann, kann ein Programm, das sich selbst aufruft. Die Regeln für Ausdrücke lassen sich als Grammatik aufschreiben, eine Regel pro Zeile. { … } heißt »beliebig oft, auch keinmal«, | heißt »oder«:
expression = term { ("+" | "-") term }
term       = factor { ("*" | "/") factor }
factor     = "-" factor | atom
atom       = Zahl | "(" expression ")"
Ein Ausdruck ist eine Summe aus Termen, ein Term ein Produkt aus Faktoren, und ein Faktor ist eine Zahl oder wieder ein ganzer Ausdruck in Klammern. Dass * stärker bindet als +, steht in der Grammatik selbst: Ein Term wird ganz eingesammelt, bevor das nächste + drankommt.
Aus jeder Regel wird eine Methode, die vorn aus der Liste der Tokens nimmt, was zu ihr gehört, und den Baum dafür zurückgibt. So sieht die erste aus:
def expression(tokens)
    tree = term(tokens)
    tree = [tokens.shift, tree, term(tokens)] while ['+', '-'].include?(tokens.first)
    tree
end
tokens.first ist das nächste Token, tokens.shift nimmt es heraus. Solange ein + oder - kommt, wird der Baum bisher zum linken Teil eines neuen Knotens. So hängt 8 - 3 - 2 als ["-", ["-", 8, 3], 2] zusammen, von links nach rechts.
Schreib parse so, dass es eine Kopie der Tokens (tokens.dup) an expression gibt und danach prüft, dass nichts übrig ist. Dann fehlen term, factor und atom. Bei einer Klammer ruft atom wieder expression auf und erwartet danach ein ).
def expression(tokens):
    tree = term(tokens)
    while first(tokens) in ('+', '-'):
        tree = [tokens.pop(0), tree, term(tokens)]
    return tree
first(tokens) gibt das nächste Token zurück oder None, wenn keins mehr da ist; schreib es dir als kleine Hilfsfunktion. tokens.pop(0) nimmt das Token heraus. Solange ein + oder - kommt, wird der Baum bisher zum linken Teil eines neuen Knotens. So hängt 8 - 3 - 2 als ['-', ['-', 8, 3], 2] zusammen, von links nach rechts.
Schreib parse so, dass es eine Kopie der Tokens (list(tokens)) an expression gibt und danach prüft, dass nichts übrig ist. Dann fehlen term, factor und atom. Bei einer Klammer ruft atom wieder expression auf und erwartet danach ein ).
Wo der Automat nur Zustände hatte, merkt sich das Programm, wo es gerade ist: Jeder Aufruf, der noch nicht fertig ist, wartet auf dem Stack, bis der Aufruf darin zurückkommt. Bei ((((1)))) liegen vier atom übereinander, und jedes weiß, dass es noch ein ) braucht. Eine Grammatik wie diese heißt kontextfrei, und ein Parser, der für jede Regel eine Methode hat, die sich gegenseitig aufrufen, heißt rekursiver Abstieg.
Schreib parse in calculator.rb: aus Tokens einen Baum, mit +, -, *, /, Klammern und einem Minus als Vorzeichen.
Eine Methode für jede Regel: expression ruft term auf, term ruft factor auf, und factor ruft für eine Klammer wieder expression auf.
Schreib parse in calculator.py: aus Tokens einen Baum, mit +, -, *, /, Klammern und einem Minus als Vorzeichen.
Eine Funktion für jede Regel: expression ruft term auf, term ruft factor auf, und factor ruft für eine Klammer wieder expression auf.
Den Baum auszurechnen ist das Leichteste: Ein Blatt ist schon sein Wert. Bei jedem anderen Knoten rechnest du zuerst die Teilbäume aus, mit evaluate selbst, und verbindest dann ihre Werte mit dem Rechenzeichen. Genau so, wie der Baumzeichner oben es zeigt, nur dass evaluate die Knoten nicht nacheinander, sondern ineinander erledigt.
op, *args = tree
values = args.map { |arg| evaluate(arg, variables) }
op, *args = tree nimmt das Rechenzeichen und die Teilbäume aus der Liste. Teilen soll immer eine Kommazahl geben, wie auf einem Taschenrechner. In Ruby ist 7 / 2 aber 3, weil zwei Integer geteilt wieder einen Integer geben; 7.to_f / 2 ist 3.5.
op, *args = tree
values = [evaluate(arg, variables) for arg in args]
op, *args = tree nimmt das Rechenzeichen und die Teilbäume aus der Liste. Teilen soll immer eine Kommazahl geben, wie auf einem Taschenrechner, und in Python ist 7 / 2 schon 3.5.
Schreib evaluate in calculator.rb.
Ein Blatt ist schon sein Wert. Sonst rechnest du erst die Kinder aus, mit evaluate, und verbindest dann ihre Werte.
Schreib evaluate in calculator.py.
Ein Blatt ist schon sein Wert. Sonst rechnest du erst die Kinder aus, mit evaluate, und verbindest dann ihre Werte.
Was soll bei (1 + 2 herauskommen, oder bei 1 +? Gar nichts: Das sind keine Ausdrücke. Ein Rechner, der dann trotzdem etwas ausrechnet, ist schlimmer als einer, der es sagt. Wo der Parser etwas anderes findet, als die Grammatik erlaubt, bricht er mit einem Fehler ab:
atom bekommt kein Token mehr, weil der Ausdruck zu früh aufhört: 1 +.atom findet nach einem Ausdruck in Klammern kein ): (1 + 2.atom findet etwas, das keine Zahl und keine Klammer auf ist: ) oder * 3.1 2.Der Rechner zum Tippen fängt solche Fehler ab und schreibt die Meldung hin, statt abzustürzen. Mach die Meldungen so, dass man versteht, was fehlt.
Sorg dafür, dass calculate bei einem falschen Ausdruck mit einem Fehler abbricht (raise), statt irgendetwas auszurechnen.
Sorg dafür, dass calculate bei einem falschen Ausdruck mit einem Fehler abbricht (raise), statt irgendetwas auszurechnen.
Als Nächstes kommt ^ für »hoch« dazu: 2 ^ 3 ist 8. Hoch bindet noch stärker als Malnehmen, 2 * 3 ^ 2 ist 18. Und es hat eine Eigenart:
Was ergibt 2 ^ 3 ^ 2, wenn ^ »hoch« heißt, so wie in der Mathematik?
Hoch wird von rechts nach links gerechnet. Und ein Minus davor gilt erst nach dem Hoch: -2 ^ 2 ist −4, so wie in der Mathematik −2² = −4 ist. Beides passt in eine neue Regel zwischen factor und atom:
factor     = "-" factor | power
power      = atom [ "^" factor ]
[ … ] heißt »vielleicht«. Weil nach dem ^ wieder factor kommt und nicht eine Schleife wie bei +, hängt 2 ^ 3 ^ 2 als ["^", 2, ["^", 3, 2]] zusammen: rechts tiefer, also rechts zuerst. Und weil factor ein Vorzeichen erlaubt, geht auch 2 ^ -1.
Bau ^ in calculator.rb ein.
Eine neue Regel power zwischen factor und den Zahlen. Nach dem ^ ruft sie factor auf, nicht sich selbst in einer Schleife: So wird von rechts gerechnet.
Bau ^ in calculator.py ein.
Eine neue Regel power zwischen factor und den Zahlen. Nach dem ^ ruft sie factor auf, nicht sich selbst in einer Schleife: So wird von rechts gerechnet.
Bei 2 ^ -1 gibt Ruby (1/2) aus: Ein Integer hoch eine negative Zahl ist in Ruby ein Bruch (Rational), genau ein halb, ohne Rundung. Er ist gleich 0.5, die Prüfung nimmt ihn also an; mit to_f wird eine Kommazahl daraus.
Ein Rechner, der sich Zahlen merkt, ist viel praktischer: breite = 4, hoehe = 3, dann breite * hoehe. Dafür braucht es drei Änderungen:
tokenize erkennt Namen: ein Buchstabe oder _, danach beliebig viele Buchstaben, Ziffern und _. Ein Name ist ein String-Token wie die Rechenzeichen.atom, so wie eine Zahl, und im Baum ein Blatt: x * (x + 1) ist ["*", "x", ["+", "x", 1]].evaluate bekommt die Werte der Namen mit und schaut ein Blatt, das ein Name ist, dort nach. Ein Name ohne Wert ist ein Fehler.Die Werte stehen in einem Hash: calculate('x * (x + 1)', { 'x' => 3 }) ist 12. Gib variables in evaluate an jeden Aufruf für die Teilbäume weiter.
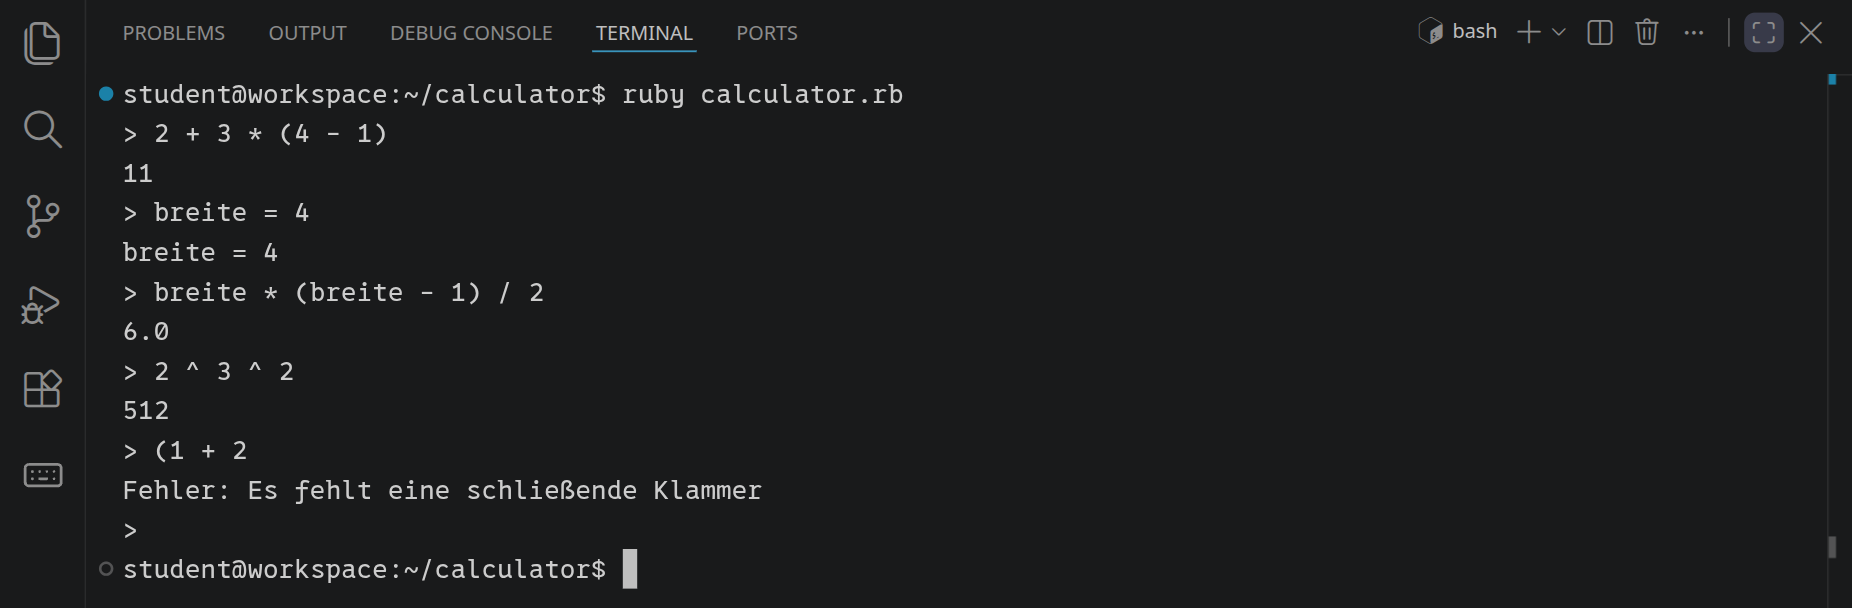
Fehlt noch die Zuweisung. Sie gehört nicht in die Grammatik, sondern in den Rechner zum Tippen: Fängt eine Zeile mit einem Namen und = an, rechnet er den Rest aus und merkt sich das Ergebnis.
if (m = line.match(/\A([a-z_][a-z_0-9]*)\s*=(.*)\z/i))
    variables[m[1]] = calculate(m[2], variables)
    puts "#{m[1]} = #{variables[m[1]]}"
else
    puts calculate(line, variables)
end
variables = {} steht vor der Schleife, damit es sich von Zeile zu Zeile hält.
Die Werte stehen in einem dict: calculate('x * (x + 1)', {'x': 3}) ist 12. Gib variables in evaluate an jeden Aufruf für die Teilbäume weiter.
Fehlt noch die Zuweisung. Sie gehört nicht in die Grammatik, sondern in den Rechner zum Tippen: Fängt eine Zeile mit einem Namen und = an, rechnet er den Rest aus und merkt sich das Ergebnis.
m = re.fullmatch(r'([A-Za-z_]\w*)\s*=(.*)', line)
if m:
    variables[m[1]] = calculate(m[2], variables)
    print(f'{m[1]} = {variables[m[1]]}')
else:
    print(calculate(line, variables))
import re gehört an den Anfang und variables = {} vor die Schleife, damit es sich von Zeile zu Zeile hält.
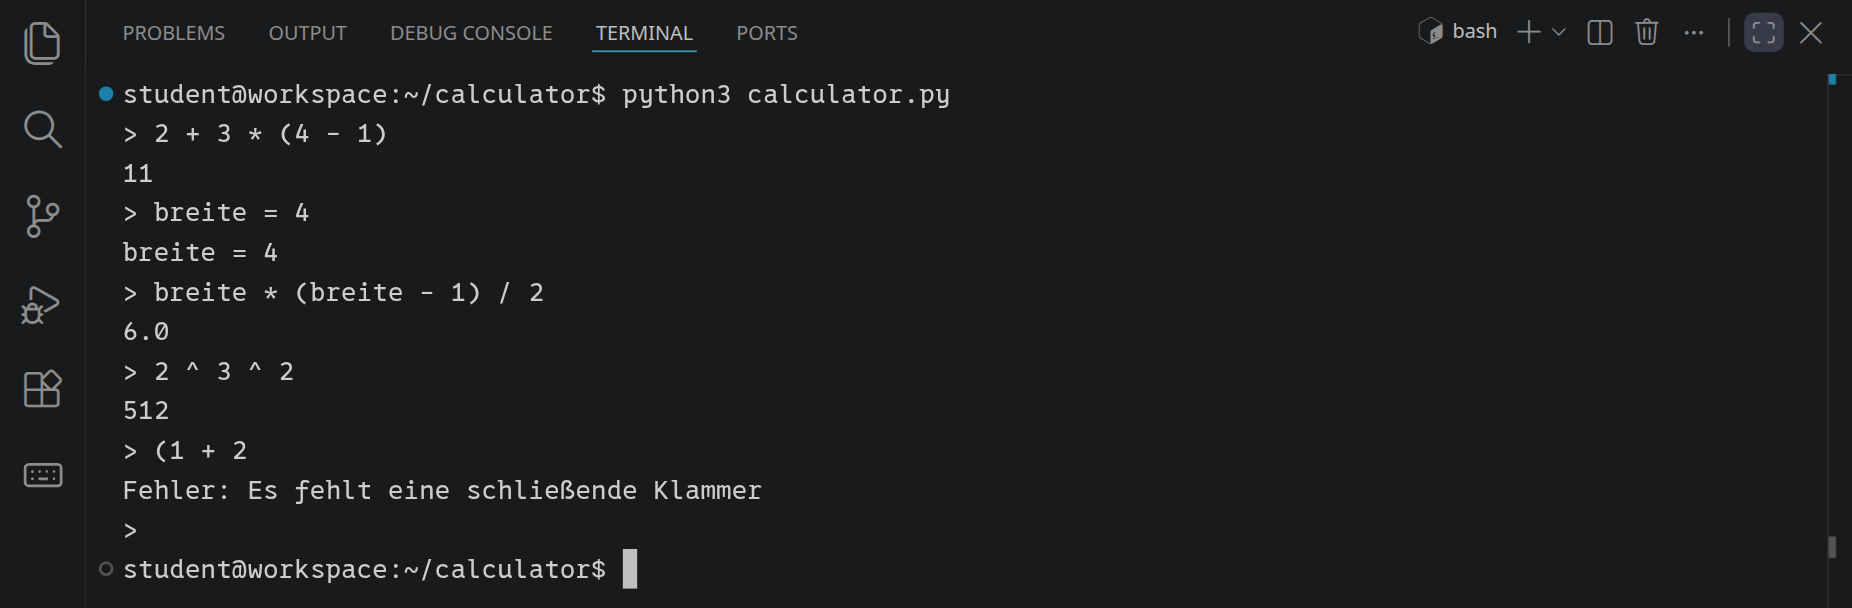
Erweitere calculator.rb um Namen, deren Werte in einem Hash stehen.
Erweitere calculator.py um Namen, deren Werte in einem dict stehen.
sqrt(16) oder max(3, 7). Ein Name mit ( dahinter ist ein Aufruf; die Grammatik bekommt dafür eine Regel mit einer Liste von Ausdrücken, durch Kommas getrennt.x < 3 binden noch schwächer als +: eine Regel über expression. Mit Vergleichen, if und Schleifen wird aus dem Rechner eine kleine Programmiersprache, und evaluate ein Interpreter.ruby -e 'pp RubyVM::AbstractSyntaxTree.parse("2 + 3 * 4")' python3 -c 'import ast; print(ast.dump(ast.parse("2 + 3 * 4", mode="eval"), indent=2))'