powered by 
Woher weiß Python, dass print((1 + 2) * 3) ein Programm ist und print((1 + 2) *) nicht? Hinter jeder Programmiersprache stehen Regeln, die festlegen, welche Texte dazugehören: eine Grammatik. Du liest und schreibst Grammatiken in EBNF und als Syntaxdiagramme und baust in Ruby oder Python aus einer Grammatik ein Programm, das Ausdrücke wie 2+3*(4+5) prüft, mit einer Funktion für jede Regel.
In Kellerautomaten hast du Klammern mit einer Maschine geprüft: Sie liest ein Wort Zeichen für Zeichen, legt Klammern auf einen Stack und sagt am Ende Ja oder Nein. Eine Grammatik beschreibt eine Sprache von der anderen Seite: mit Regeln, nach denen man alle Wörter der Sprache bauen kann. Jede Programmiersprache hat eine. Für Python steht sie vollständig in der Dokumentation, unter Full Grammar specification, und das Datenformat JSON ist auf json.org ganz als Bilder solcher Regeln beschrieben, als Syntaxdiagramme.
Lege im Terminal (StrgJ) einen Ordner an und öffne ihn mit StrgK StrgO:
mkdir /workspace/grammatiken
Alle Dateien dieser Aktivität kommen in diesen Ordner. Ein Programm startest du im Terminal mit ruby und dem Namen der Datei.
Alle Dateien dieser Aktivität kommen in diesen Ordner. Ein Programm startest du im Terminal mit python3 und dem Namen der Datei.
Eine Grammatik für eine winzige Sprache, deren Sätze aus drei Wörtern bestehen:
sentence = subject verb object
subject  = "Pip" | "Bello"
verb     = "findet" | "sucht"
object   = "Bello" | "die Lampe" | "den Weg"
Jede Zeile ist eine Regel. Links vom = steht ein Name, ein Nichtterminal: Es steht für einen Teil des Satzes, der noch gebaut werden muss. In Anführungszeichen stehen Terminale, die so, wie sie sind, im Satz landen. | heißt »oder«. Die erste Regel ist die, mit der man anfängt; ihr Name heißt Startsymbol. Die Namen im Code sind englisch, so wie die Namen der Funktionen, die du gleich daraus machst.
Einen Satz baut man, indem man beim Startsymbol beginnt und immer ein Nichtterminal durch das ersetzt, was rechts in seiner Regel steht, bei | durch eine der Möglichkeiten. Sind nur noch Terminale übrig, ist der Satz fertig. Diese Kette heißt Ableitung:
sentence
⇒ subject verb object
⇒ "Pip" verb object
⇒ "Pip" "findet" object
⇒ "Pip" "findet" "die Lampe"
Alle Sätze, die sich so ableiten lassen, sind die Sprache der Grammatik.
Wie viele verschiedene Sätze lassen sich mit der Grammatik oben ableiten,
sentence als Startsymbol?
Dieselbe Ableitung als Baum heißt Syntaxbaum. Oben steht das Startsymbol, darunter, wodurch es ersetzt wurde. Nichtterminale stehen in eckigen Kästen, Terminale in runden; von links nach rechts gelesen ergeben die runden Kästen den Satz:
sentence(subject("Pip") verb("findet") object("die Lampe"))
Die Grammatik erlaubt auch »Bello findet Bello«. Der Satz ist richtig gebaut, aber ob er etwas Sinnvolles sagt, steht nicht in der Grammatik. Wie ein Text gebaut ist, heißt seine Syntax, was er bedeutet, seine Semantik. In Programmen ist es genauso: print(1 / 0) ist nach der Grammatik von Python ein richtiges Programm, und erst beim Ausführen stellt sich heraus, dass es nichts bedeutet, was der Rechner tun könnte.
Diese Schreibweise geht auf John Backus zurück. 1959 schlug er sie vor, um die Programmiersprache ALGOL festzulegen, und Peter Naur benutzte sie 1960 im Bericht über ALGOL 60, den er herausgab. Seitdem heißt sie Backus-Naur-Form, kurz BNF.
John Backus (1924–2007), amerikanischer Informatiker. Ab 1954 leitete er bei IBM das Team, das Fortran und den ersten Fortran-Compiler baute: Statt Maschinenbefehle schrieb man nun Formeln wie x = a * b + c, und der Compiler machte daraus ein Programm, das fast so schnell lief wie eines von Hand. Wettermodelle wie das des Deutschen Wetterdiensts rechnen bis heute in Fortran.
»Vieles an meiner Arbeit kommt daher, dass ich faul war«, sagte er später: Er schrieb nicht gern Programme, also baute er etwas, das es leichter macht. Die Schreibweise, mit der man festlegt, wie eine Programmiersprache aussieht, heißt nach ihm Backus-Naur-Form.
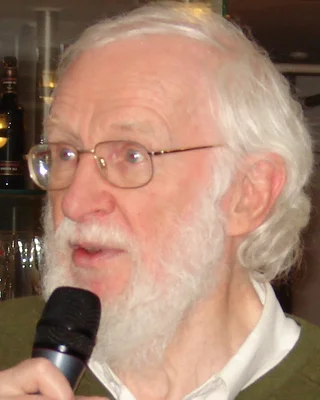
Peter Naur (1928–2016), dänischer Informatiker, zuerst Astronom. 1960 gab er den Bericht über die Programmiersprache ALGOL 60 heraus und legte darin die ganze Sprache mit der Schreibweise von John Backus fest, die seitdem Backus-Naur-Form heißt. Dafür bekam er 2005 den Turing Award.
Das Wort »computer science« mochte er nicht und schlug »datalogi« vor; in Dänemark und Schweden heißt die Informatik bis heute so.
Foto: Eriktj, 2008, CC BY-SA 3.0, zugeschnitten (Wikimedia Commons)
Report on the Algorithmic Language ALGOL 60, herausgegeben von Peter Naur, Communications of the ACM, 1960. Der Bericht, der eine ganze Programmiersprache auf wenigen Seiten in BNF festlegt; unter seinen Autoren sind auch Bauer und Samelson, die den Keller erfanden. Bei der ACM, und die überarbeitete Fassung von 1963 zum Lesen im Browser.
Die Sprache der Sätze oben hat nur endlich viele Wörter. Für eine Programmiersprache reicht das nicht: Es gibt unendlich viele Programme. Dafür hat die Schreibweise drei Klammern, mit denen auch Ein Rechner für Ausdrücke arbeitet:
| In der Regel | heißt |
|---|---|
{ … } |
beliebig oft, auch keinmal |
[ … ] |
einmal oder keinmal |
( … ) |
zusammen, etwa ( "+" | "-" ) für ein Plus oder ein Minus |
Weil die Klammern zur Schreibweise gehören, steht eine Klammer, die selbst im Wort vorkommt, in Anführungszeichen: "(" ist ein Terminal, ( gehört zur Regel. Mit diesen Klammern heißt die Schreibweise EBNF, erweiterte Backus-Naur-Form; vorgeschlagen hat sie Niklaus Wirth 1977.
What can we do about the unnecessary diversity of notation for syntactic definitions?, Niklaus Wirth, Communications of the ACM, 1977. Darin schlägt Wirth EBNF vor, mit { }, [ ] und ( ), weil fast jedes Buch über Programmiersprachen seine eigene Schreibweise für Grammatiken hatte: bei der ACM.
Die Klammerwörter aus dem Kellerautomaten, (), (())() und so weiter, beschreibt eine einzige Regel:
brackets = { "(" brackets ")" }
Ein Klammerwort ist eine Reihe von Klammerpaaren, beliebig viele, und in jedem Paar steht wieder ein Klammerwort. Die Regel benutzt sich selbst, sie ist rekursiv. So beschreibt eine Grammatik mit einer einzigen Zeile unendlich viele Wörter. Der Syntaxbaum von (())(): Das äußere brackets nimmt zwei Paare, das linke enthält ein Paar, alle anderen keins.
brackets("(" brackets("(" brackets ")") ")" "(" brackets ")")
Niklaus Wirth hat Grammatiken auch gezeichnet, zuerst für seine Sprache Pascal. Ein Syntaxdiagramm liest man von links nach rechts, die Linien entlang: Wo sich ein Weg teilt, wählst du einen. Ein runder Kasten ist ein Terminal, das so im Wort steht. Ein eckiger ist ein Nichtterminal: Dort gehst du durch dessen eigenes Diagramm und kommst danach zurück. So sieht eine Grammatik für Zahlen aus:
number = digit { digit }
digit  = "0" | "1" | … | "9"
number = digit { digit }
digit  = "0" | "1" | … | "9"
Bei number geht es einmal durch digit und danach unten zurück, so oft du willst. So zeichnete Wirth x { x }: Ein Pfeil auf dem Weg zurück zeigt die Richtung. Die … stehen für die Ziffern 2 bis 8, die das Bild auslässt.
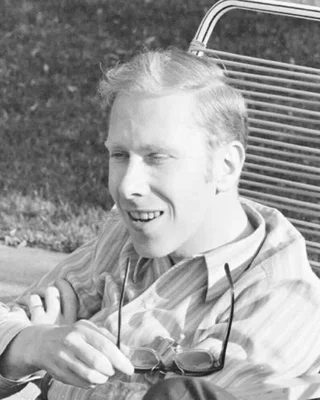
Niklaus Wirth (1934–2024), Schweizer Informatiker an der ETH Zürich. Er entwarf Pascal als Sprache, an der man sauberes Programmieren lernt. Eines seiner Bücher heißt Algorithms + Data Structures = Programs: Ein Programm, das sind Algorithmen plus Datenstrukturen.
1995 warb er für schlanke Software und zitierte einen Kollegen: Software werde schneller langsamer, als die Hardware schneller wird. Der Satz heißt heute Wirthsches Gesetz. 1984 bekam er den Turing Award, den wichtigsten Preis der Informatik.
Foto: Robert M. McClure, CC BY-SA 3.0, zugeschnitten (Wikimedia Commons)
Ein Syntaxdiagramm und eine Regel in EBNF sagen dasselbe; man kann jedes in das andere übersetzen. Diese Zahlen haben ein Vorzeichen, wenn man will, und ein Komma, wie man sie im Deutschen schreibt:
decimal = [ "-" ] digit { digit } [ "," digit { digit } ]
Welches dieser Wörter beschreibt das Syntaxdiagramm decimal nicht?
Jetzt in die andere Richtung. Dieses Diagramm beschreibt Listen von Zahlen zwischen spitzen Klammern, mit Semikolons dazwischen:
list = "<" [ number { ";" number } ] ">"
Welche Regel in EBNF beschreibt genau das Syntaxdiagramm list, also
genau dieselben Wörter?
Aus einer Grammatik lässt sich fast von selbst ein Programm machen, das prüft, ob ein Wort zur Sprache gehört. Jede Regel wird eine Funktion. Sie bekommt das Wort und einen Index i und liest ab dort, was ihre Regel erlaubt. Zurück gibt sie den Index hinter dem, was sie gelesen hat, und wenn das Wort an der Stelle nicht passt, nichts. Ein Nichtterminal in der Regel wird ein Aufruf seiner Funktion. Eine kleine Hilfsfunktion peek zeigt das nächste Zeichen, ohne es zu lesen; am Ende des Worts gibt sie einen leeren String zurück.
So wird jedes Stück einer Regel zu Code:
| In der Regel | In der Funktion |
|---|---|
ein Terminal, etwa "("
|
Ist peek(word, i) genau dieses Zeichen, geht es bei i + 1 weiter; sonst passt das Wort nicht. |
ein Nichtterminal, etwa brackets
|
i = brackets(word, i); passt es nicht, passt auch das Ganze nicht. |
{ … } |
eine Schleife: solange das nächste Zeichen eines ist, mit dem … anfangen kann |
[ … ] |
ein if mit derselben Frage |
a | b |
if und else: Das nächste Zeichen entscheidet, ob a oder b kommt. |
Lege brackets.rb an:
# Wörter aus Klammerpaaren, nach der Grammatik
#   brackets = { "(" brackets ")" }
# Jede Funktion liest ab dem Index i, was ihre Regel erlaubt, und gibt den
# Index dahinter zurück, oder nil, wenn das Wort dort nicht passt.

# Das Zeichen am Index i, am Ende des Worts ein leerer String
def peek(word, i)
    word[i] || ''
end

# brackets = { "(" brackets ")" }
def brackets(word, i)
    while peek(word, i) == '('
        i = brackets(word, i + 1)
        return nil if i.nil? || peek(word, i) != ')'
        i += 1
    end
    i
end

# Das Wort gehört dazu, wenn brackets es bis zum Ende liest
def accepts(word)
    brackets(word, 0) == word.length
end

['(())()', '(()', '())', ''].each do |word|
    puts "#{word.inspect} #{accepts(word)}"
end
word[i] ist hinter dem Ende des Worts nil, darum gibt peek dort '' zurück. Die Schleife in brackets ist das { … } der Regel: Solange eine ( kommt, liest sie ein Paar. Nach der ( ruft brackets sich selbst auf, für das Klammerwort im Paar, und danach muss eine ) kommen. Starte es mit ruby brackets.rb:
Lege brackets.py an:
# Wörter aus Klammerpaaren, nach der Grammatik
#   brackets = { "(" brackets ")" }
# Jede Funktion liest ab dem Index i, was ihre Regel erlaubt, und gibt den
# Index dahinter zurück, oder None, wenn das Wort dort nicht passt.

# Das Zeichen am Index i, am Ende des Worts ein leerer String
def peek(word, i):
    return word[i] if i < len(word) else ''


# brackets = { "(" brackets ")" }
def brackets(word, i):
    while peek(word, i) == '(':
        i = brackets(word, i + 1)
        if i is None or peek(word, i) != ')':
            return None
        i += 1
    return i


# Das Wort gehört dazu, wenn brackets es bis zum Ende liest
def accepts(word):
    return brackets(word, 0) == len(word)


for word in ['(())()', '(()', '())', '']:
    print(repr(word), accepts(word))
word[i] gäbe hinter dem Ende des Worts einen Fehler, darum fragt peek erst nach der Länge. Die Schleife in brackets ist das { … } der Regel: Solange eine ( kommt, liest sie ein Paar. Nach der ( ruft brackets sich selbst auf, für das Klammerwort im Paar, und danach muss eine ) kommen. Starte es mit python3 brackets.py:
"(())()" true
"(()" false
"())" false
"" true
Bei ()) liest brackets ein Paar und hört vor der zweiten ) auf, weil danach keine ( mehr kommt. Es gibt 2 zurück, das Wort ist aber 3 Zeichen lang: Darum prüft accepts, ob das ganze Wort gelesen ist.
Wie viele Aufrufe von brackets sind bei accepts('((()))') höchstens
gleichzeitig offen, also angefangen und noch nicht zurückgekehrt?
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
Vier. Bei der ersten ), am Index 3, ist jeder Aufruf, der eine ( gelesen hat, noch offen und wartet auf seine ), und der Aufruf für das innerste Klammerwort liest gerade:
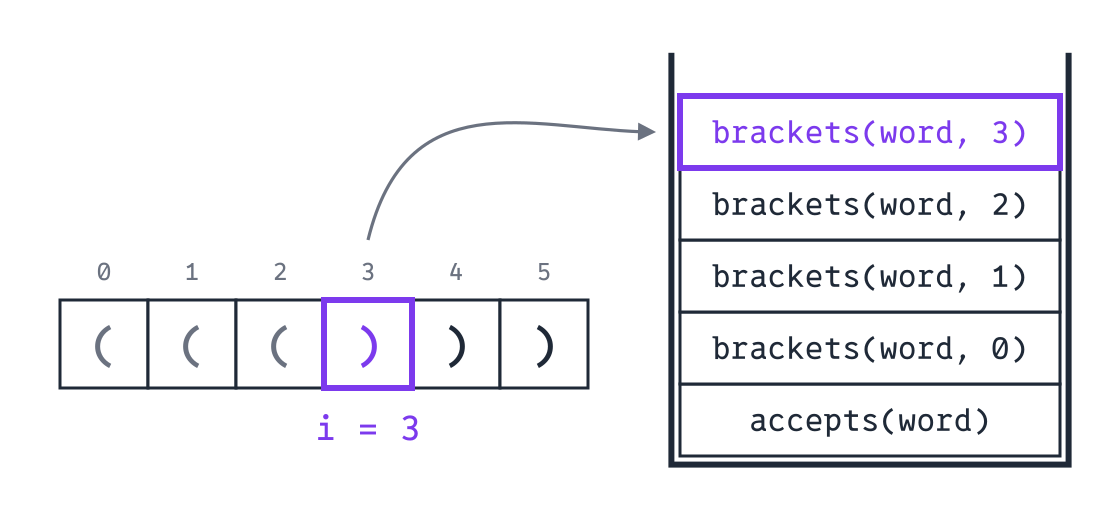
Wie viele Aufrufe offen sind, merkt sich das Programm auf dem Stack der Aufrufe: Jeder Aufruf, der noch nicht fertig ist, liegt darauf, bis er zurückkehrt. Das ist der Stack des Kellerautomaten, nur dass jetzt Aufrufe darauf liegen statt Klammern. Eine Regel, die sich selbst aufruft, braucht ihn; ein endlicher Automat hat keinen.
Lege number.rb mit diesem Anfang an; peek kopierst du aus brackets.rb:
# Zahlen aus Ziffern, nach der Grammatik
#   number = digit { digit }
#   digit  = "0" | "1" | … | "9"

# Das Zeichen am Index i, am Ende des Worts ein leerer String
def peek(word, i)
    word[i] || ''
end

# hier: digit und number

p number('123', 0)
p number('12a', 0)
p number('a1', 0)
digit(word, i) und number(word, i) nach ihren Regeln. digit liest eine Ziffer, number so viele Ziffern, wie hintereinander kommen, mindestens eine. Beide geben den Index dahinter zurück, oder nil. Am Ende soll das Programm 3, 2 und nil ausgeben.
Geh 12a von Hand durch, ab dem Index 0: Am Index 0 steht eine Ziffer, am Index 1 auch, am Index 2 keine mehr. Also hört number vor dem Index 2 auf und gibt 2 zurück. Bei a1 steht am Index 0 keine Ziffer; dann ist es keine Zahl.
Ob ein Zeichen eine Ziffer ist, sagt peek(word, i).between?('0', '9'); für den leeren String am Ende ist das false. number = digit { digit } heißt: einmal digit, und wenn das nil gibt, nil zurückgeben; danach eine Schleife, solange die nächste Ziffer kommt, wie in brackets.
Ein Gerüst:
def digit(word, i)
    return nil unless …
    i + 1
end

def number(word, i)
    i = digit(word, i)
    return nil if i.nil?
    i = digit(word, i) while …
    i
end
# digit = "0" | "1" | … | "9"
def digit(word, i)
    return nil unless peek(word, i).between?('0', '9')
    i + 1
end

# number = digit { digit }
def number(word, i)
    i = digit(word, i)
    return nil if i.nil?
    i = digit(word, i) while peek(word, i).between?('0', '9')
    i
end
Lege number.py mit diesem Anfang an; peek kopierst du aus brackets.py:
# Zahlen aus Ziffern, nach der Grammatik
#   number = digit { digit }
#   digit  = "0" | "1" | … | "9"

# Das Zeichen am Index i, am Ende des Worts ein leerer String
def peek(word, i):
    return word[i] if i < len(word) else ''


# hier: digit und number

print(number('123', 0))
print(number('12a', 0))
print(number('a1', 0))
digit(word, i) und number(word, i) nach ihren Regeln. digit liest eine Ziffer, number so viele Ziffern, wie hintereinander kommen, mindestens eine. Beide geben den Index dahinter zurück, oder None. Am Ende soll das Programm 3, 2 und None ausgeben.
Geh 12a von Hand durch, ab dem Index 0: Am Index 0 steht eine Ziffer, am Index 1 auch, am Index 2 keine mehr. Also hört number vor dem Index 2 auf und gibt 2 zurück. Bei a1 steht am Index 0 keine Ziffer; dann ist es keine Zahl.
Ob ein Zeichen eine Ziffer ist, sagt '0' <= peek(word, i) <= '9'; für den leeren String am Ende ist das False. number = digit { digit } heißt: einmal digit, und wenn das None gibt, None zurückgeben; danach eine Schleife, solange die nächste Ziffer kommt, wie in brackets.
Ein Gerüst:
def digit(word, i):
    if not …:
        return None
    return i + 1


def number(word, i):
    i = digit(word, i)
    if i is None:
        return None
    while …:
        i = digit(word, i)
    return i
# digit = "0" | "1" | … | "9"
def digit(word, i):
    if not '0' <= peek(word, i) <= '9':
        return None
    return i + 1


# number = digit { digit }
def number(word, i):
    i = digit(word, i)
    if i is None:
        return None
    while '0' <= peek(word, i) <= '9':
        i = digit(word, i)
    return i
Schreib in number.rb die Funktionen digit(word, i) und
number(word, i) nach den Regeln digit = "0" | "1" | … | "9" und
number = digit { digit }. Beide lesen ab dem Index i und geben den
Index hinter dem Gelesenen zurück, oder nil, wenn dort keine Ziffer
steht. Die Prüfung ruft sie mit eigenen Wörtern auf.
Geh 12a von Hand durch, ab dem Index 0: Wo steht die erste Ziffer,
wo die letzte? Welchen Index soll number zurückgeben?
digit fragt peek nach dem Zeichen und gibt i + 1 zurück, wenn es
zwischen '0' und '9' liegt. number ruft digit einmal auf und
dann in einer Schleife, solange die nächste Ziffer kommt.
Schreib in number.py die Funktionen digit(word, i) und
number(word, i) nach den Regeln digit = "0" | "1" | … | "9" und
number = digit { digit }. Beide lesen ab dem Index i und geben den
Index hinter dem Gelesenen zurück, oder None, wenn dort keine Ziffer
steht. Die Prüfung ruft sie mit eigenen Wörtern auf.
Geh 12a von Hand durch, ab dem Index 0: Wo steht die erste Ziffer,
wo die letzte? Welchen Index soll number zurückgeben?
digit fragt peek nach dem Zeichen und gibt i + 1 zurück, wenn es
zwischen '0' und '9' liegt. number ruft digit einmal auf und
dann in einer Schleife, solange die nächste Ziffer kommt.
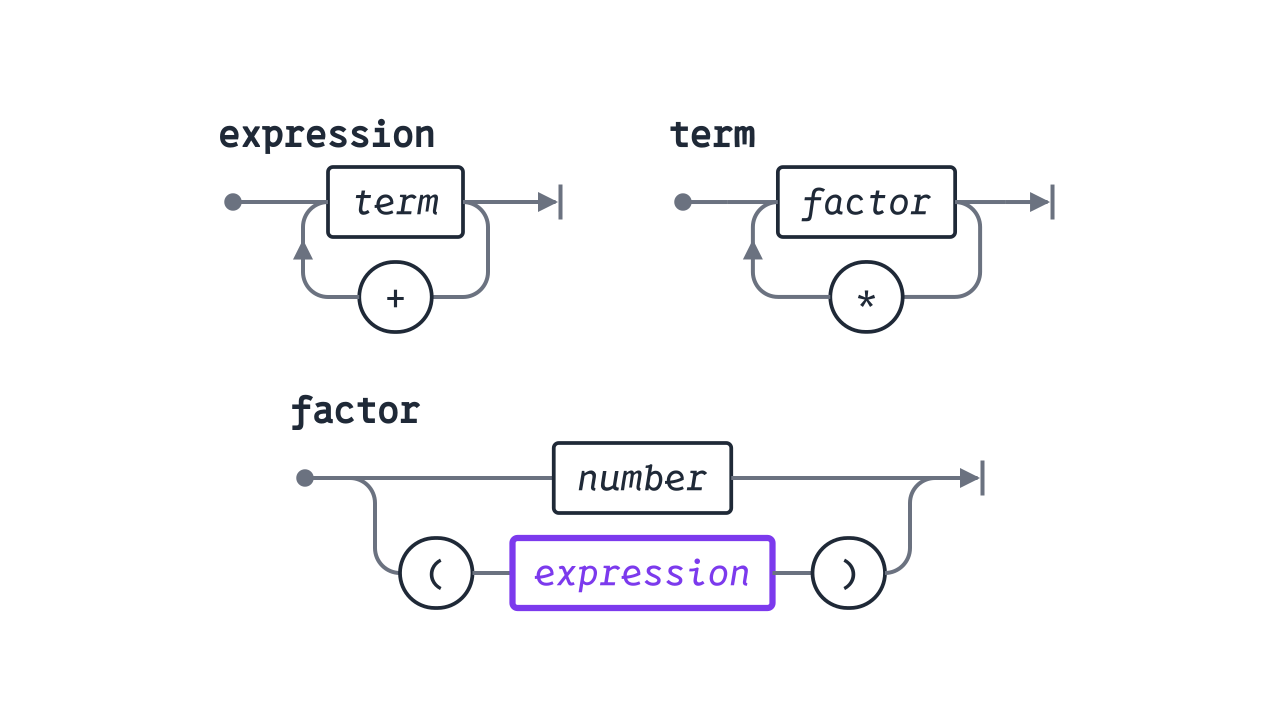
Jetzt eine Sprache, die schon nach Programmieren aussieht: Ausdrücke aus Zahlen mit +, * und runden Klammern, ohne Leerzeichen, etwa 2+3*4 oder (1+2)*3.
expression = term { "+" term }
term       = factor { "*" factor }
factor     = number | "(" expression ")"
expression = term { "+" term }
term       = factor { "*" factor }
factor     = number | "(" expression ")"
Ein Ausdruck ist eine Summe aus Termen, ein Term ein Produkt aus Faktoren, und ein Faktor ist eine Zahl oder wieder ein ganzer Ausdruck in Klammern. Dass Multiplizieren stärker bindet als Plus, steht damit in der Grammatik selbst: Ein Term sammelt alle Faktoren mit * ein, bevor das nächste + drankommt. Der Syntaxbaum von 2+3*4 zeigt es: Das * hängt tiefer, in einem Term, und wird zuerst gerechnet.
expression(term(factor(number("2"))) "+" term(factor(number("3")) "*" factor(number("4"))))
Die Zahlen sind hier Blätter; ihre Ziffern bis hinunter zu digit lässt der Baum weg.
Kopiere number.rb nach expression.rb, zum Beispiel mit cp number.rb expression.rb im Terminal, und ersetze die Zeilen am Ende durch diese:
['2+3*4', '(1+2)*3', '2+', '(1+2', '2*+3'].each do |word|
    puts "#{word.inspect} #{accepts(word)}"
end
Kopiere number.py nach expression.py, zum Beispiel mit cp number.py expression.py im Terminal, und ersetze die Zeilen am Ende durch diese:
for word in ['2+3*4', '(1+2)*3', '2+', '(1+2', '2*+3']:
    print(repr(word), accepts(word))
Schreib in expression.rb die Funktionen expression, term und
factor nach den drei Regeln oben, jede mit (word, i) wie number,
und accepts(word), die true zurückgibt, wenn word ein ganzer
Ausdruck ist. Die Prüfung ruft accepts mit eigenen Wörtern auf, ohne
Leerzeichen.
Geh (1+2)*3 von Hand durch: expression ruft term auf, term ruft
factor auf. Was sieht factor als Erstes? Welche Funktion liest das
1+2 in der Klammer?
expression sieht aus wie number: einmal term, dann eine Schleife,
solange das nächste Zeichen ein + ist; in der Schleife term ab dem
Zeichen hinter dem +. term genauso mit factor und *. factor
fragt peek: Bei ( liest es einen Ausdruck und danach die ), sonst
eine Zahl.
Ein Gerüst für zwei der Funktionen:
def expression(word, i)
    i = term(word, i)
    while !i.nil? && peek(word, i) == '+'
        i = …
    end
    i
end

def factor(word, i)
    return … unless peek(word, i) == '('
    i = expression(word, i + 1)
    return nil if i.nil? || peek(word, i) != ')'
    …
end
Schreib in expression.py die Funktionen expression, term und
factor nach den drei Regeln oben, jede mit (word, i) wie number,
und accepts(word), die True zurückgibt, wenn word ein ganzer
Ausdruck ist. Die Prüfung ruft accepts mit eigenen Wörtern auf, ohne
Leerzeichen.
Geh (1+2)*3 von Hand durch: expression ruft term auf, term ruft
factor auf. Was sieht factor als Erstes? Welche Funktion liest das
1+2 in der Klammer?
expression sieht aus wie number: einmal term, dann eine Schleife,
solange das nächste Zeichen ein + ist; in der Schleife term ab dem
Zeichen hinter dem +. term genauso mit factor und *. factor
fragt peek: Bei ( liest es einen Ausdruck und danach die ), sonst
eine Zahl.
Ein Gerüst für zwei der Funktionen:
def expression(word, i):
    i = term(word, i)
    while i is not None and peek(word, i) == '+':
        i = …
    return i


def factor(word, i):
    if peek(word, i) != '(':
        return …
    i = expression(word, i + 1)
    if i is None or peek(word, i) != ')':
        return None
    return …
+ und ein Term, also expression = expression "+" term | term. Lass dazu expression als Erstes expression(word, i) aufrufen und starte das Programm. Achte darauf, welcher Fehler kommt und welche Funktion in den Zeilen darüber immer wieder steht. Stell expression danach wieder zurück.
+ und ein Term, also expression = expression "+" term | term. Lass dazu expression als Erstes expression(word, i) aufrufen und starte das Programm. Achte darauf, welcher Fehler kommt und welche Funktion in den Zeilen darüber immer wieder steht. Stell expression danach wieder zurück.
Eine Funktion, die sich als Erstes selbst aufruft, mit demselben Index, kommt nie zu einem Zeichen: Sie ruft sich auf, bis der Stack der Aufrufe voll ist. Darum schreibt man solche Regeln in EBNF mit { … }, als Schleife. Ein Programm, das so für jede Regel eine Funktion hat und die Funktionen sich gegenseitig aufrufen lässt, heißt rekursiver Abstieg: Es steigt von der Regel für das Ganze zu den Regeln für die Teile hinab.
Warum so umständlich mit term und factor? Kürzer ginge es so:
expression = expression "+" expression | expression "*" expression | number
Wie viele verschiedene Syntaxbäume hat 2+3*4 nach dieser kürzeren
Grammatik, mit expression als Startsymbol?
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
Zwei. In dem einen hängt das * tiefer, wie es sein soll:
expression(expression(number("2")) "+" expression(expression(number("3")) "*" expression(number("4"))))
Im anderen hängt das + tiefer, und wer diesen Baum ausrechnet, rechnet erst 2 + 3 und dann mal 4, also 20 statt 14:
expression(expression(expression(number("2")) "+" expression(number("3"))) "*" expression(number("4")))
Eine Grammatik, nach der ein Wort zwei verschiedene Syntaxbäume haben kann, heißt mehrdeutig. Für eine Programmiersprache ist das schlecht: Der Baum entscheidet, was ein Programm tut. Die Grammatik mit term und factor erzeugt dieselben Wörter, aber für jedes nur einen Baum, den mit Punkt vor Strich.
Noam Chomsky, ein Sprachwissenschaftler, hat 1956 Grammatiken danach geordnet, was ihre Regeln dürfen. Jede Stufe passt zu einer Art von Automaten, der genau ihre Sprachen erkennt:
| Typ | Die Regeln | Erkennt sie | Zum Beispiel |
|---|---|---|---|
| 3, regulär | Rechts steht ein Terminal, höchstens gefolgt von einem Nichtterminal, etwa a = "x" b. In EBNF geht dasselbe mit Schleifen { … }, solange keine Regel sich selbst mittendrin enthält, auch nicht über andere Regeln. |
ein endlicher Automat | Zahlen, Namen, Zahlenschlösser |
| 2, kontextfrei | Links steht ein einzelnes Nichtterminal, rechts beliebig viel, auch das Nichtterminal selbst mittendrin. | ein Kellerautomat | Klammern, Ausdrücke, Programmiersprachen |
| 1, kontextsensitiv | Links dürfen mehrere Zeichen stehen, sodass eine Regel nur in einer bestimmten Umgebung gilt; ein Wort wird dabei nie kürzer. | eine Turingmaschine, deren Band nicht länger ist als das Wort | anbncn |
| 0 | beliebige Regeln | eine Turingmaschine | alles, was ein Programm überhaupt erkennen kann |
Diese Ordnung heißt Chomsky-Hierarchie. Jede Stufe enthält die darunter: Eine reguläre Grammatik ist auch kontextfrei. Alle Grammatiken auf dieser Seite sind kontextfrei; was Programmiersprachen brauchen, liegt auf Stufe 2.
Noam Chomsky (geboren 1928), amerikanischer Sprachwissenschaftler am MIT. Er beschrieb Sprachen durch Regeln, die alle ihre Sätze erzeugen, durch Grammatiken, und machte das 1957 mit seinem Buch Syntactic Structures bekannt.
1956 ordnete er Grammatiken danach, was ihre Regeln dürfen; die Ordnung heißt heute Chomsky-Hierarchie. Die Syntax von Programmiersprachen beschreibt man seit ALGOL 60 mit kontextfreien Grammatiken, ihrer Stufe 2.
Foto: unbekannt, 1961, aus The Technology Review, MIT Museum, gemeinfrei, zugeschnitten (Wikimedia Commons)
Die Grammatik der Ausdrücke besteht aus fünf Regeln. Wegen welcher Regel erkennt kein endlicher Automat ihre Sprache?
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
In factor steht expression zwischen zwei Klammern, also mitten in einer Regel, die über term und expression wieder bei factor landet. Ohne diese Klammern wären Ausdrücke eine reguläre Sprache, Zahlen mit + und * dazwischen, und ein endlicher Automat könnte sie prüfen. Mit ihnen muss sich ein Programm merken, wie viele Klammern offen sind, ohne Grenze, und dafür braucht es einen Stack.
|, { … }, [ … ] und ( … ). Ein Syntaxdiagramm zeichnet dieselbe Regel: runde Kästen für Terminale, eckige für Nichtterminale.{ … } eine Schleife. Wie tief die Aufrufe gerade gehen, merkt sich der Stack der Aufrufe.- und /. Die Funktionen geben dort nicht nur zurück, ob ein Ausdruck passt, sondern bauen seinen Syntaxbaum, und am Ende rechnet der Rechner ihn aus.Compiler Construction, Niklaus Wirth, 1996, überarbeitet 2017. Das Buch fängt mit Terminalen, Nichtterminalen und Startsymbol an, kommt über reguläre Sprachen zum rekursiven Abstieg und baut damit einen ganzen Compiler für eine kleine Sprache, bis zu den Befehlen eines Prozessors. Wirth stellt es auf seiner Seite an der ETH Zürich frei zum Lesen bereit.