powered by 
Stehen in x = (a[1] + b) * {2} alle Klammern richtig? Ein endlicher Automat kann das nicht prüfen, ein Zähler auch nicht. Du gibst einem Automaten einen Stack als Gedächtnis und baust damit in Ruby oder Python einen Kellerautomaten, der Klammern prüft und Wörter wie aaabbb erkennt. Dann findest du heraus, warum ein endlicher Automat an aaabbb scheitern muss, egal wie viele Zustände er hat.
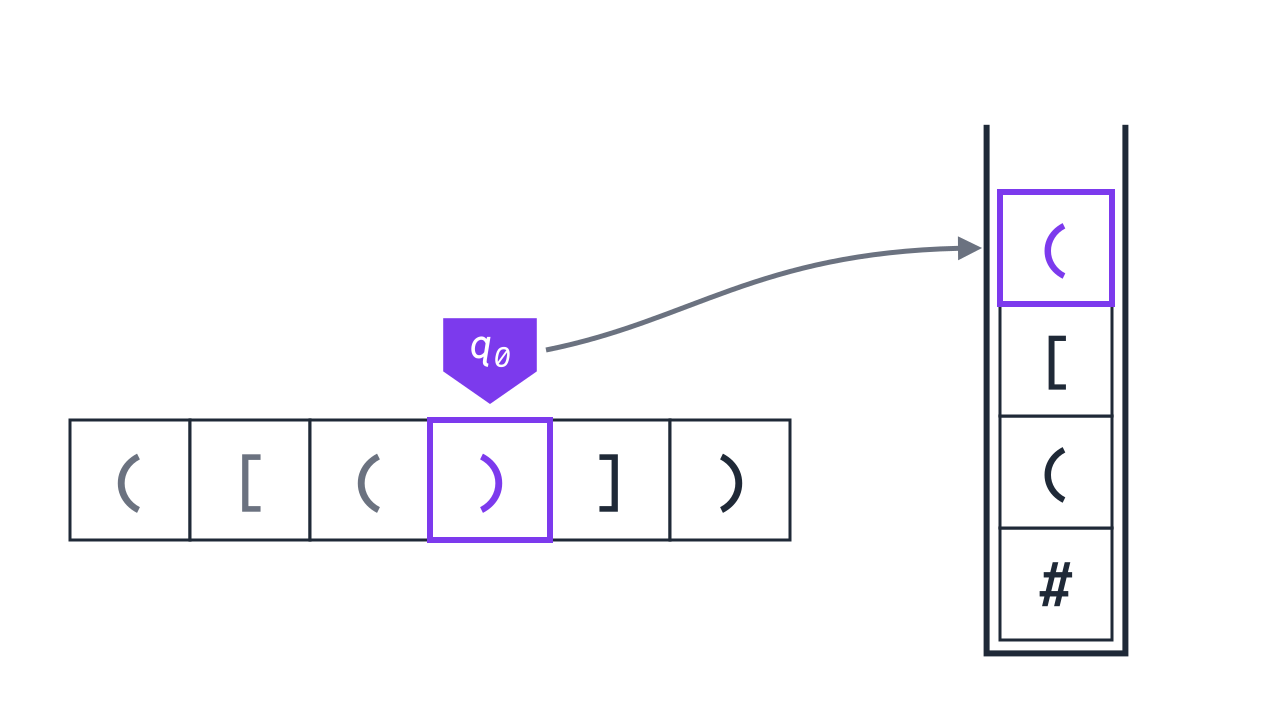
Bevor es um Begriffe geht, sieh einem Kellerautomaten bei der Arbeit zu. Er prüft, ob die runden Klammern in (()()) richtig stehen, und liest dazu das Wort Zeichen für Zeichen von links. Rechts daneben hat er einen Stack, einen Stapel, auf den er oben etwas legen und von dem er oben etwas herunternehmen kann; ganz unten liegt #. Schalte Schritt für Schritt weiter und achte darauf, was bei jeder ( und bei jeder ) mit dem Stack passiert.
Derselbe Automat liest jetzt ((). Spiel es im Kopf durch, Zeichen für
Zeichen: Was liegt am Ende auf dem Stack, und nimmt er das Wort an?
In Endliche Automaten hast du gesehen, was ein Automat mit endlich vielen Zuständen kann: Drehkreuze, Zahlenschlösser, Teilbarkeit. Am Ende stand eine Grenze. Was er sich merken müsste, ohne dass es eine feste Obergrenze gibt, kann er nicht. Klammern sind so ein Fall: In ((((…)))) können beliebig viele Klammern offen sein, bevor die erste zugeht.
Jeder Compiler und jeder Editor, der dir eine fehlende Klammer rot markiert, löst genau dieses Problem. Er braucht dafür mehr als Zustände, nämlich einen Stack. Ein endlicher Automat mit einem Stack heißt Kellerautomat, nach dem deutschen Wort, das Friedrich L. Bauer und Klaus Samelson dem Stack gaben: dem Keller.
Lege im Terminal (StrgJ) einen Ordner an und öffne ihn mit StrgK StrgO:
mkdir /workspace/kellerautomat
Alle Dateien dieser Aktivität kommen in diesen Ordner. Ein Programm startest du im Terminal mit ruby und dem Namen der Datei.
Alle Dateien dieser Aktivität kommen in diesen Ordner. Ein Programm startest du im Terminal mit python3 und dem Namen der Datei.
Für runde Klammern allein reicht ein Zähler. Jede ( zählt eins hoch, jede ) eins herunter. Fällt der Zähler unter 0, schließt eine Klammer, die nie geöffnet wurde. Am Ende muss er wieder bei 0 sein.
Lege count.rb an:
# Stehen die runden Klammern richtig? Ein Zähler merkt sich, wie viele
# Klammern gerade offen sind.
def balanced(word)
    depth = 0
    word.each_char do |symbol|
        if symbol == '('
            depth += 1
        elsif symbol == ')'
            depth -= 1
            return false if depth < 0
        end
    end
    depth == 0
end

['(()())', '(()', '())(', ''].each do |word|
    puts "#{word.inspect} #{balanced(word)}"
end
ruby count.rb
"(()())" true
"(()" false
"())(" false
"" true
Lege count.py an:
# Stehen die runden Klammern richtig? Ein Zähler merkt sich, wie viele
# Klammern gerade offen sind.
def balanced(word):
    depth = 0
    for symbol in word:
        if symbol == '(':
            depth += 1
        elif symbol == ')':
            depth -= 1
            if depth < 0:
                return False
    return depth == 0


for word in ['(()())', '(()', '())(', '']:
    print(repr(word), balanced(word))
python3 count.py
'(()())' True
'(()' False
'())(' False
'' True
Das leere Wort, ganz ohne Klammern, ist auch richtig: Es gibt nichts, das offen bleibt. Ein Zähler kann beliebig groß werden, darum ist er schon mehr, als ein endlicher Automat hat. Aber reicht er auch, wenn es mehrere Sorten von Klammern gibt?
Jetzt gibt es auch eckige Klammern. Angenommen, du zählst runde und
eckige Klammern getrennt, jede Sorte mit ihrem eigenen Zähler wie in
balanced. Was sagen die beiden Zähler über ([)]?
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
Zwei Zähler wissen, wie viele Klammern jeder Sorte offen sind, aber nicht, in welcher Reihenfolge sie geöffnet wurden. Genau darauf kommt es an: Die zuletzt geöffnete Klammer muss als erste zugehen.
Ein Stack ist eine Liste, an der man nur an einem Ende arbeitet, oben: push legt einen Wert oben drauf, pop nimmt den obersten wieder herunter. Was zuletzt hineinkam, kommt als Erstes wieder heraus, wie bei einem Stapel Teller. Wie ein Stack aufgebaut ist, steht im Handbuch unter Der Stack.
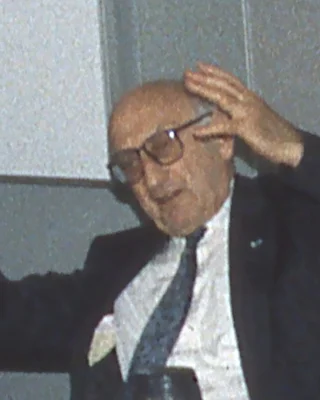
Friedrich L. Bauer (1924–2015, im Bild) und Klaus Samelson (1918–1980), Mathematiker in München, überlegten, wie ein Rechner eine Formel selbst in seine Befehle übersetzen kann. Dafür schlugen sie 1955 einen Speicher vor, bei dem nur zählt, was zuletzt hineinkam, und meldeten ihn 1957 als »Keller« zum Patent an: den Stack.
Sie sahen schon, dass der Keller auch zu Funktionsaufrufen passt, und heute ist es so: Wohin dein Programm nach einem Aufruf zurückkehrt, liegt auf einem Stack. Bauer hielt 1967 an der TU München die erste Vorlesung über Informatik in Deutschland.
Foto: Rolf Kickuth, 1995, CC BY-SA 4.0, zugeschnitten (Wikimedia Commons)
Für die Klammern heißt das: Jede öffnende Klammer kommt auf den Stack. Kommt eine schließende Klammer, muss oben die passende öffnende liegen; sie wird heruntergenommen. Liegt oben eine andere, oder ist der Stack leer, stimmt das Wort nicht. Am Ende muss der Stack leer sein.
In Ruby ist ein Array schon ein Stack: stack.push(x) legt x oben drauf, stack.pop nimmt den obersten Wert herunter und gibt ihn zurück, stack.last zeigt ihn, ohne ihn wegzunehmen.
Lege brackets.rb an. Diese Zeilen kommen ans Ende, darüber schreibst du balanced:
['([]{})', '([)]', '((', ''].each do |word|
    puts "#{word.inspect} #{balanced(word)}"
end
In Python ist eine Liste schon ein Stack: stack.append(x) legt x oben drauf, stack.pop() nimmt den obersten Wert herunter und gibt ihn zurück, stack[-1] zeigt ihn, ohne ihn wegzunehmen.
Lege brackets.py an. Diese Zeilen kommen ans Ende, darüber schreibst du balanced:
for word in ['([]{})', '([)]', '((', '']:
    print(repr(word), balanced(word))
Schreib in brackets.rb die Methode balanced(word): Sie gibt true
zurück, wenn die runden, eckigen und geschweiften Klammern in word
richtig stehen, sonst false. Andere Zeichen zählen nicht. Die Prüfung
ruft sie mit eigenen Wörtern auf.
Lies ([)] von Hand und leg jede öffnende Klammer auf einen Stapel.
Wenn eine schließende Klammer kommt: Welche Klammer muss oben liegen,
damit es passt?
Eine öffnende Klammer kommt mit push oben auf das Array, eine
schließende nimmt mit pop die oberste herunter. Passt die nicht zu ihr,
oder ist das Array leer, ist das Wort falsch. Am Ende muss das Array leer
sein.
Ein Gerüst:
PAIRS = { ')' => '(', ']' => '[', '}' => '{' }

def balanced(word)
    stack = []
    word.each_char do |symbol|
        if PAIRS.value?(symbol)
            # öffnend: auf den Stack
        elsif PAIRS.key?(symbol)
            # schließend: passt die oberste?
        end
    end
    # leer?
end
Schreib in brackets.py die Funktion balanced(word): Sie gibt True
zurück, wenn die runden, eckigen und geschweiften Klammern in word
richtig stehen, sonst False. Andere Zeichen zählen nicht. Die Prüfung
ruft sie mit eigenen Wörtern auf.
Lies ([)] von Hand und leg jede öffnende Klammer auf einen Stapel.
Wenn eine schließende Klammer kommt: Welche Klammer muss oben liegen,
damit es passt?
Eine öffnende Klammer kommt mit append oben auf die Liste, eine
schließende nimmt mit pop die oberste herunter. Passt die nicht zu ihr,
oder ist die Liste leer, ist das Wort falsch. Am Ende muss die Liste leer
sein.
Ein Gerüst:
PAIRS = {')': '(', ']': '[', '}': '{'}

def balanced(word):
    stack = []
    for symbol in word:
        if symbol in PAIRS.values():
            ...  # öffnend: auf den Stack
        elif symbol in PAIRS:
            ...  # schließend: passt die oberste?
    return ...
balanced nach jedem Zeichen den Stack ausgeben und starte es mit ([)]. Achte darauf, was oben liegt, wenn die ) kommt.
Dein balanced ist ein Programm mit Schleifen und Vergleichen. Ein Kellerautomat wie der vom Anfang der Seite schafft dasselbe nur mit einer Tabelle, wie ein endlicher Automat. Er hat Zustände, liest das Wort Zeichen für Zeichen und hat dazu einen Stack. Bei jedem Zeichen sieht er in seiner Tabelle nach, und zwar mit drei Angaben: seinem Zustand, dem gelesenen Zeichen und dem obersten Zeichen des Stacks. Die Tabelle sagt ihm den neuen Zustand und was er an die Stelle des obersten Zeichens legt: nichts, dasselbe Zeichen wieder oder mehrere Zeichen.
Ganz unten im Stack liegt am Anfang ein #. So erkennt der Automat, dass sein Stack leer ist: wenn # oben liegt. Nimmt er ein Wort an, ist er am Ende in einem akzeptierenden Zustand, und auf dem Stack liegt nur noch #. Fehlt für ein Paar aus Zeichen und oberstem Zeichen ein Übergang, lehnt er das Wort ab.
Lege pda.rb an. PDA steht für pushdown automaton, das englische Wort für Kellerautomat.
# Ein Kellerautomat prüft runde Klammern. Er liest das Wort Zeichen für
# Zeichen und hat einen Stack; ganz unten liegt #, das Zeichen für »leer«.
START = 'q0'
ACCEPTING = ['q0']
# [Zustand, gelesenes Zeichen, oberstes Zeichen des Stacks]
#   => [neuer Zustand, was an dessen Stelle auf den Stack kommt]
# Der Stack wird von unten nach oben geschrieben: '#(' heißt, # bleibt
# liegen und ( kommt oben drauf; '' heißt, das oberste Zeichen ist weg.
TRANSITIONS = {
    ['q0', '(', '#'] => ['q0', '#('],
    ['q0', '(', '('] => ['q0', '(('],
    ['q0', ')', '('] => ['q0', ''],
}

def accepts(word, trace: false)
    state = START
    stack = ['#']
    puts "      #{state}  #{stack.join}" if trace
    word.each_char do |symbol|
        top = stack.pop
        move = TRANSITIONS[[state, symbol, top]]
        # kein Übergang: der Fehlerzustand, das Wort ist abgelehnt
        return false if move.nil?
        state, push = move
        stack.concat(push.chars)
        puts "#{symbol.ljust(5)} #{state}  #{stack.join}" if trace
    end
    ACCEPTING.include?(state) && stack == ['#']
end

accepts('(()())', trace: true)
['(()())', '(()', '())(', ''].each do |word|
    puts "#{word.inspect} #{accepts(word)}"
end
accepts nimmt bei jedem Zeichen das oberste Zeichen mit pop vom Stack und schlägt mit Zustand, Zeichen und diesem obersten Zeichen in TRANSITIONS nach. Was dort steht, kommt mit concat wieder oben drauf, Zeichen für Zeichen. Starte es mit ruby pda.rb.
Lege pda.py an. PDA steht für pushdown automaton, das englische Wort für Kellerautomat.
# Ein Kellerautomat prüft runde Klammern. Er liest das Wort Zeichen für
# Zeichen und hat einen Stack; ganz unten liegt #, das Zeichen für »leer«.
START = 'q0'
ACCEPTING = {'q0'}
# (Zustand, gelesenes Zeichen, oberstes Zeichen des Stacks)
#   -> (neuer Zustand, was an dessen Stelle auf den Stack kommt)
# Der Stack wird von unten nach oben geschrieben: '#(' heißt, # bleibt
# liegen und ( kommt oben drauf; '' heißt, das oberste Zeichen ist weg.
TRANSITIONS = {
    ('q0', '(', '#'): ('q0', '#('),
    ('q0', '(', '('): ('q0', '(('),
    ('q0', ')', '('): ('q0', ''),
}


def accepts(word, trace=False):
    state = START
    stack = ['#']
    if trace:
        print(f'      {state}  {"".join(stack)}')
    for symbol in word:
        top = stack.pop()
        move = TRANSITIONS.get((state, symbol, top))
        # kein Übergang: der Fehlerzustand, das Wort ist abgelehnt
        if move is None:
            return False
        state, push = move
        stack.extend(push)
        if trace:
            print(f'{symbol:<5} {state}  {"".join(stack)}')
    return state in ACCEPTING and stack == ['#']


accepts('(()())', trace=True)
for word in ['(()())', '(()', '())(', '']:
    print(repr(word), accepts(word))
accepts nimmt bei jedem Zeichen das oberste Zeichen mit pop vom Stack und schlägt mit Zustand, Zeichen und diesem obersten Zeichen in TRANSITIONS nach. Was dort steht, kommt mit extend wieder oben drauf, Zeichen für Zeichen. Starte es mit python3 pda.py.
Als Bild hat dieser Kellerautomat einen einzigen Zustand q0, und alle drei Übergänge führen zu ihm zurück. Jede Zeile am Pfeil ist ein Übergang aus TRANSITIONS:
Weil hier die Zeichen selbst Klammern sind, liest sich das schwer. Vor dem Komma steht das gelesene Zeichen, zwischen Komma und Schrägstrich das oberste Zeichen des Stacks, hinter dem Schrägstrich, was danach an seiner Stelle liegt, von unten nach oben geschrieben. ε heißt: dort liegt nichts mehr, wie '' in der Tabelle.
| Am Pfeil | gelesen | oben auf dem Stack | danach an seiner Stelle | in Worten |
|---|---|---|---|---|
(, # / #( |
( |
# |
#( |
Keine Klammer ist offen, eine geht auf: ( kommt auf #. |
(, ( / (( |
( |
( |
(( |
Noch eine Klammer geht auf: ( kommt auf die offene (. |
), ( / ε |
) |
( |
nichts | Eine Klammer geht zu: Die oberste ( verschwindet. |
Die Ausgabe mit trace zeigt nach jedem Zeichen den Zustand und den Stack, von unten nach oben gelesen. So sieht der Stack beim Wort (()()) aus, das oberste Zeichen hervorgehoben:
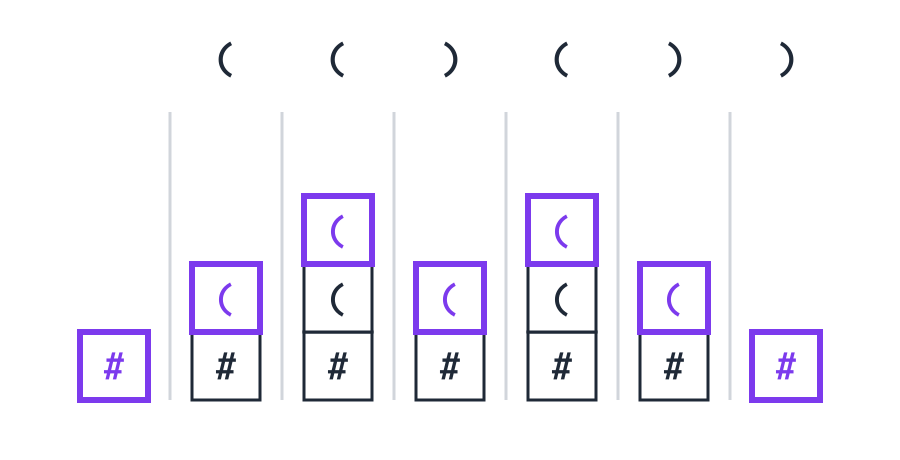
Die Höhe des Stacks ist der Zähler aus count. Der Stack kann sich aber mehr merken als eine Zahl: welche Klammern in welcher Reihenfolge offen sind.
Ergänze TRANSITIONS in pda.rb, sodass der Kellerautomat auch eckige
Klammern prüft: accepts('([]())') ist true, accepts('([)]') ist
false. Ändere accepts nicht; der Automat bleibt bei dem einen Zustand
q0.
Welche Paare aus gelesenem Zeichen und oberstem Zeichen des Stacks
können jetzt vorkommen? Eine öffnende Klammer kann auf #, auf ( und
auf [ treffen.
Für [ brauchst du drei Übergänge, je einen für #, ( und [ oben,
und für ( einen weiteren, wenn [ oben liegt. ] passt nur, wenn [
oben liegt, und nimmt es weg.
Zwei der neuen Zeilen:
    ['q0', '[', '#'] => ['q0', '#['],
    ['q0', ']', '['] => ['q0', ''],
Ergänze TRANSITIONS in pda.py, sodass der Kellerautomat auch eckige
Klammern prüft: accepts('([]())') ist True, accepts('([)]') ist
False. Ändere accepts nicht; der Automat bleibt bei dem einen Zustand
q0.
Welche Paare aus gelesenem Zeichen und oberstem Zeichen des Stacks
können jetzt vorkommen? Eine öffnende Klammer kann auf #, auf ( und
auf [ treffen.
Für [ brauchst du drei Übergänge, je einen für #, ( und [ oben,
und für ( einen weiteren, wenn [ oben liegt. ] passt nur, wenn [
oben liegt, und nimmt es weg.
Zwei der neuen Zeilen:
    ('q0', '[', '#'): ('q0', '#['),
    ('q0', ']', '['): ('q0', ''),
TRANSITIONS den Übergang heraus, der eine ) liest, und starte accepts('()', trace: true). Achte auf die Zeile, nach der die Ausgabe aufhört. Welche Wörter nimmt der Automat jetzt noch an? Setz den Übergang danach wieder ein.
TRANSITIONS den Übergang heraus, der eine ) liest, und starte accepts('()', trace=True). Achte auf die Zeile, nach der die Ausgabe aufhört. Welche Wörter nimmt der Automat jetzt noch an? Setz den Übergang danach wieder ein.
Die Sprache anbn ist die einfachste Sprache, an der endliche Automaten scheitern: alle Wörter aus einer Reihe a und dahinter genauso vielen b. Dazu gehören das leere Wort, ab, aabb und aaabbb, nicht aber aab, abb oder abab. Sie sieht aus wie die Klammern mit a für ( und b für ), mit einer Regel mehr: Nach dem ersten b kommt kein a mehr.
Kopiere pda.rb nach anbn.rb, zum Beispiel mit cp pda.rb anbn.rb im Terminal. Leere dort TRANSITIONS und ersetze die Zeilen am Ende:
accepts('aabb', trace: true)
['ab', 'aabb', 'aab', 'abab', 'ba', ''].each do |word|
    puts "#{word.inspect} #{accepts(word)}"
end
Kopiere pda.py nach anbn.py, zum Beispiel mit cp pda.py anbn.py im Terminal. Leere dort TRANSITIONS und ersetze die Zeilen am Ende:
accepts('aabb', trace=True)
for word in ['ab', 'aabb', 'aab', 'abab', 'ba', '']:
    print(repr(word), accepts(word))
Auf den Stack darf jedes Zeichen außer #, auch eines, das im Wort gar nicht vorkommt, etwa ein großes A für jedes gelesene a.
Schreib in anbn.rb die Übergänge und die akzeptierenden Zustände eines
Kellerautomaten, der genau die Wörter anbn annimmt:
'', 'ab', 'aabb', 'aaabbb' und so weiter, aber nicht 'aab',
'abab' oder 'ba'. accepts bleibt, wie es ist.
Jedes a legt etwas auf den Stack, jedes b nimmt es wieder weg. Am Ende
muss der Stack wieder leer sein, also nur # darauf liegen. Probier es
für aabb und aab von Hand.
Was verhindert abab? Sobald das erste b gelesen ist, darf kein a mehr
kommen. Dafür wechselt der Automat beim ersten b in einen zweiten Zustand
q1, in dem es für a keinen Übergang gibt.
Ein Gerüst; zwei Ziele fehlen:
ACCEPTING = ['q0', 'q1']
TRANSITIONS = {
    ['q0', 'a', '#'] => ['q0', '#A'],
    ['q0', 'a', 'A'] => ...,
    ['q0', 'b', 'A'] => ...,
    ['q1', 'b', 'A'] => ['q1', ''],
}
Schreib in anbn.py die Übergänge und die akzeptierenden Zustände eines
Kellerautomaten, der genau die Wörter anbn annimmt:
'', 'ab', 'aabb', 'aaabbb' und so weiter, aber nicht 'aab',
'abab' oder 'ba'. accepts bleibt, wie es ist.
Jedes a legt etwas auf den Stack, jedes b nimmt es wieder weg. Am Ende
muss der Stack wieder leer sein, also nur # darauf liegen. Probier es
für aabb und aab von Hand.
Was verhindert abab? Sobald das erste b gelesen ist, darf kein a mehr
kommen. Dafür wechselt der Automat beim ersten b in einen zweiten Zustand
q1, in dem es für a keinen Übergang gibt.
Ein Gerüst; zwei Ziele fehlen:
ACCEPTING = {'q0', 'q1'}
TRANSITIONS = {
    ('q0', 'a', '#'): ('q0', '#A'),
    ('q0', 'a', 'A'): ...,
    ('q0', 'b', 'A'): ...,
    ('q1', 'b', 'A'): ('q1', ''),
}
Kellerautomaten können also mehr als endliche Automaten. Aber vielleicht hat nur noch niemand den richtigen endlichen Automaten für anbn gefunden, einen mit sehr vielen Zuständen? Dass es ihn nicht geben kann, zeigt eine Überlegung, die mit Briefen und Fächern anfängt: Steckst du 5 Briefe in 4 Fächer, landen in einem Fach mindestens zwei. Das heißt Schubfachprinzip.
Ein endlicher Automat mit 4 Zuständen liest ein a nach dem anderen. Vor dem ersten a ist er in seinem Startzustand. Nach wie vielen a ist sicher, dass er in einem Zustand ist, in dem er vorher schon einmal war, egal wie seine Übergänge aussehen?
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
Für einen Automaten heißt das: Hat er k Zustände und liest er k a, war er in k + 1 Zuständen, mit dem Startzustand. Also war er zweimal im selben Zustand, sagen wir nach i a und nach j a, mit i kleiner als j.
Von da an weiß der Automat nicht mehr, ob er i oder j a gelesen hat; er ist ja im selben Zustand. Liest er jetzt i b, macht er in beiden Fällen dasselbe und landet im selben Zustand. Er nimmt also aibi und ajbi beide an oder beide nicht. Richtig wäre aber, das erste anzunehmen und das zweite nicht. Das gilt für jedes k, also für jeden endlichen Automaten: Keiner prüft anbn.
Der Weg vom Zustand nach i a zum selben Zustand nach j a ist eine Schleife im Automaten. Man kann sie beliebig oft durchlaufen, »aufpumpen«, ohne dass er es merkt. Daher hat der Satz, der diese Überlegung für alle Sprachen fasst, seinen Namen: Pumping-Lemma.
Welche dieser Fragen über ein Wort aus a und b kann ein endlicher Automat beantworten, ganz ohne Stack?
Klammern sind überall, wo Text eine Struktur hat, die in sich verschachtelt ist. HTML-Tags wie <ul> und </ul> sind Klammern mit Namen. In Ruby sind def und end ein Paar, in Python die Einrückung. Jede Sprache, in der man etwas so tief verschachteln kann, wie man will, braucht zum Prüfen einen Stack. Solche Sprachen beschreibt man mit kontextfreien Grammatiken, und für jede kontextfreie Grammatik gibt es einen Kellerautomaten, der ihre Wörter prüft.
Sequential Formula Translation, Klaus Samelson und Friedrich L. Bauer, Communications of the ACM, 1960. Wie ein Rechner eine Formel mit Klammern in seine Befehle übersetzt, mit einem Keller für alles, was noch offen ist; die englische Fassung des Aufsatzes von 1959, der den Keller bekannt machte: bei der ACM.
Ein Compiler prüft, ob in deinem Programm jedes if sein end hat (in
Ruby) oder jede Klammer ihr Gegenstück. Beschreib in ein paar Sätzen, warum
er dafür einen Stack braucht und was er darauf legt.
2 + 3 * (4 - 1) versteht und ausrechnet.