powered by 
Ein endlicher Automat liest ein Wort Zeichen für Zeichen und weiß am Ende nur eins: ob das Wort dazugehört. Hier steht, wie ein Automat aufgeschrieben wird, wie ein deterministischer (DEA) und ein nichtdeterministischer (NEA) ein Wort lesen, wie aus einem regulären Ausdruck ein NEA wird, wie die Potenzmengenkonstruktion daraus einen DEA macht und wie die Minimierung ihn so klein wie möglich macht. Jeder Schritt hat ein Beispiel zum Durchklicken und Pseudocode, den du in deine Sprache übersetzt.
Ein endlicher Automat hat:
Mathematisch ist ein Automat das Tupel \((Q, \Sigma, \delta, q_0, F)\): Q die Zustände, Σ (Sigma) das Alphabet, δ (delta) die Übergänge, q0 der Start, F die akzeptierenden Zustände. Die Wörter, die er annimmt, heißen seine Sprache.
Im Bild ist jeder Zustand ein Kreis und jeder Übergang ein Pfeil mit seinem Zeichen. Ein Pfeil ohne Anfang zeigt auf den Start, akzeptierende Zustände haben einen doppelten Rand. Dieser Automat nimmt die Wörter aus a und b an, in denen a gerade oft vorkommt: q0 heißt »bisher gerade oft«, q1 »bisher ungerade oft«.
Im Programm schreibt man die Übergänge als Tabelle: eine Zeile je Zustand, eine Spalte je Zeichen. In Ruby ist das ein Hash, in Python ein Dictionary mit dem Paar aus Zustand und Zeichen als Schlüssel:
| Zustand | a | b |
|---|---|---|
| → q0 (akzeptiert) | q1 | q0 |
| q1 | q0 | q1 |
Fehlt zu einem Zustand und einem Zeichen ein Übergang, geht der Automat in einen Fehlerzustand, aus dem er nicht mehr herauskommt und der nichts akzeptiert. Meist zeichnet man ihn nicht, sondern sagt dazu, dass alle fehlenden Pfeile dorthin führen.
Bei einem deterministischen endlichen Automaten (DEA) steht jeder Schritt fest: Zu jedem Zustand und jedem Zeichen gibt es höchstens einen Übergang. Er braucht sich darum nur einen Zustand zu merken.
accepts(word):
    state ← start
    for each symbol in word:
        if (state, symbol) not in delta: return false    # Fehlerzustand
        state ← delta[(state, symbol)]
    return state in accepting
Probier es aus: Der Ring ist der Zustand, in dem der DEA gerade ist, der Pfeil, den er nimmt, leuchtet auf. Das Wort darfst du ändern.
Typische Fehler
fetch in Ruby, ein KeyError in Python). Gemeint ist der Fehlerzustand: Das Wort wird abgelehnt.Ein nichtdeterministischer endlicher Automat (NEA) darf zu einem Zustand und einem Zeichen mehrere Übergänge haben, oder keinen. Man stellt sich vor, er rät den richtigen Weg; nachrechnen lässt sich das, indem man alle Wege zugleich verfolgt. Der NEA ist dann nicht in einem Zustand, sondern in einer Menge von Zuständen, und er nimmt ein Wort an, wenn am Ende wenigstens einer davon akzeptiert.
Dieser NEA nimmt die Wörter an, in denen aa vorkommt. In q0 liest er, was vor dem aa steht; bei jedem a kann das aa anfangen:
Ein ε-Übergang (Epsilon) kostet kein Zeichen: Der NEA darf ihn jederzeit nehmen, auch mehrere hintereinander. Die Zustände, die er von einem Zustand aus über ε-Übergänge erreicht, samt diesem selbst, heißen seine ε-Hülle. Die ε-Hülle einer Menge sind die ε-Hüllen ihrer Zustände zusammen; die Funktion closure bildet sie. Ein NEA ohne ε-Übergänge hat in jeder Hülle nur den Zustand selbst.
Ein Beispiel: der NEA, den die Thompson-Konstruktion aus a*b baut. Von q0 erreicht er ohne ein Zeichen q1, wo das a gelesen wird, und q3, wo das b gelesen wird, wenn kein a kommt; von q2 aus geht es zurück zu q1 (noch ein a) oder weiter zu q3:
| q | ε-Hülle E(q) |
|---|---|
| q0 | {q0, q1, q3} |
| q1 | {q1} |
| q2 | {q1, q2, q3} |
| q3 | {q3} |
| q4 | {q4} |
closure(states):
    result ← copy of states
    todo ← list of states
    while todo not empty:
        state ← take one from todo
        for each target of (state, ε):
            if target not in result:
                add target to result and to todo
    return result
Mit der ε-Hülle liest ein NEA ein Wort so: am Anfang die Hülle des Starts, nach jedem Zeichen die Hülle aller Ziele.
accepts(word):
    states ← closure({start})
    for each symbol in word:
        next ← {}
        for each state in states:
            add every target of (state, symbol) to next
        states ← closure(next)
    return states contains an accepting state
Ein NEA ist oft kleiner und leichter aufzuschreiben als ein DEA für dieselbe Sprache: Er beschreibt nur das Muster. Ein DEA ist leichter auszuführen: Er merkt sich einen Zustand statt einer Menge.
Ein regulärer Ausdruck beschreibt eine Sprache, und die Thompson-Konstruktion baut daraus einen NEA, Stück für Stück aus wenigen Bausteinen. Jeder Baustein hat einen Start und einen akzeptierenden Zustand, und die Bausteine werden mit ε-Übergängen verbunden. Die Bilder in diesem Abschnitt zeichnet Automatron, und genau so sehen die Automaten dort aus. Es baut nach dieser Konstruktion, lässt aber ε-Übergänge weg, die nur ein Stück an das nächste hängen.
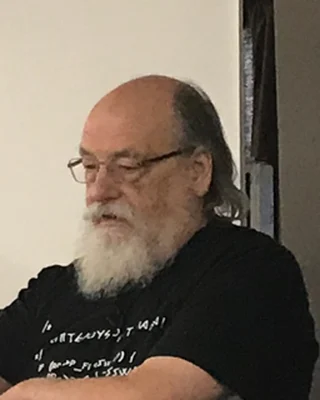
Ken Thompson (geboren 1943). Du suchst im Terminal mit grep? Das hat er 1973 geschrieben; der Name kommt aus seinem Texteditor, wo der Befehl g/re/p hieß: global, regular expression, print. Wie man aus einem regulären Ausdruck einen Automaten baut, hatte er schon 1968 beschrieben: die Thompson-Konstruktion.
Das Terminal selbst läuft unter Linux, und Linux funktioniert wie Unix, das er ab 1969 mit Dennis Ritchie schrieb. Unten rechts in VS Code steht UTF-8: Die Kodierung hat er 1992 mit Rob Pike auf ein Tischset in einem Diner gezeichnet. Und die Sprache Go hat er mit erfunden.
Foto: A. C. Diller, 2019, CC BY-SA 4.0, zugeschnitten (Wikimedia Commons)
Regular Expression Search Algorithm, Ken Thompson, Communications of the ACM, 1968. Auf vier Seiten baut Thompson aus einem regulären Ausdruck einen NEA und verfolgt beim Suchen alle Zustände zugleich, in denen er sein könnte; sein Programm übersetzt den Ausdruck dafür gleich in Maschinencode für den Rechner IBM 7094: frei bei der ACM.
a: ein Zeichen ist ein Pfeil.ab: Der akzeptierende Zustand des ersten Stücks ist der Start des zweiten.a|b: ein neuer Start mit ε zu beiden Stücken, von beiden mit ε zu einem neuen Ende. Die Sprache ist die Vereinigung der beiden Sprachen.a*: ein ε am Stück vorbei (keinmal) und eins vom Ende zurück an seinen Anfang (noch einmal).a+: derselbe Baustein ohne den Pfeil vorbei, das Stück kommt mindestens einmal.a?: derselbe Baustein ohne den Pfeil zurück, das Stück kommt höchstens einmal.Symbol, Verkettung, Alternative und Kleenesche Hülle reichen für jeden regulären Ausdruck; positive Hülle und Option sind Abkürzungen: a+ ist aa*, a? ist »a oder nichts«.
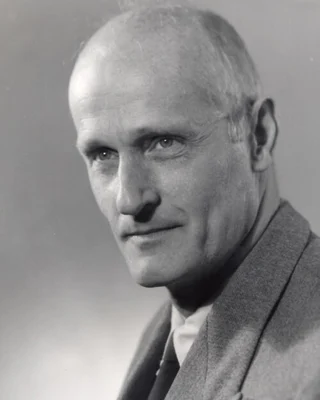
Stephen Cole Kleene (1909–1994), Mathematiker in Madison, Wisconsin. Jedes * in einem regulären Ausdruck, bei grep oder in der Suche von VS Code, ist sein Stern.
1951 wollte er wissen, welche Muster ein Netz aus Nervenzellen erkennen kann, und erfand dafür die Bausteine, die heute reguläre Ausdrücke heißen, zwanzig Jahre bevor es grep gab. Er bewies auch, dass sie und endliche Automaten genau dasselbe können.
Foto: Harold N. Hone, um 1963, gemeinfrei (Wikimedia Commons)
Representation of Events in Nerve Nets and Finite Automata, Stephen C. Kleene, Forschungsbericht RM-704 der RAND Corporation, 1951; 1956 gedruckt im Buch Automata Studies, herausgegeben von Claude Shannon und John McCarthy. Hier stehen die regulären Ausdrücke zum ersten Mal, noch als regular events, mit dem Stern und dem Beweis, dass sie und endliche Automaten dieselben Sprachen beschreiben: frei bei RAND.
Die Kleenesche Hülle einer Sprache L, geschrieben L*, sind alle Wörter, die sich aus beliebig vielen Wörtern von L zusammensetzen lassen, auch aus keinem: Das leere Wort ε gehört immer dazu. Die positive Hülle L+ lässt das leere Zusammensetzen weg: mindestens ein Wort von L; L+ ist dasselbe wie L L*. Größere Ausdrücke werden aus diesen Bausteinen zusammengesetzt, von innen nach außen; für (a|b)*aa steckt der Baustein für a|b im Baustein für *, und danach kommen zwei a:
Ein NEA lässt sich immer in einen DEA verwandeln, der dieselben Wörter annimmt. Die Idee steckt schon im Pseudocode des NEA, mit der ε-Hülle nach jedem Schritt: Er ist in einer Menge von Zuständen, und welche Menge nach dem nächsten Zeichen kommt, steht fest. Die Potenzmengenkonstruktion macht darum aus jeder Menge, die vorkommen kann, einen Zustand des DEA. (Die Potenzmenge ist die Menge aller Teilmengen; gebraucht werden meist nur wenige davon.)
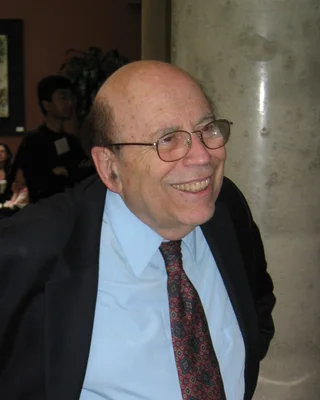
Michael O. Rabin (1931–2026, im Bild), in Breslau geboren und in Haifa aufgewachsen, und Dana Scott (geboren 1932), amerikanischer Logiker, schrieben 1959 als junge Forscher bei IBM einen Aufsatz über endliche Automaten. Darin darf ein Automat zum ersten Mal raten: der NEA. Sie zeigten auch, wie man aus jedem NEA einen DEA baut, der dieselben Wörter annimmt; die Potenzmengenkonstruktion heißt darum auch Rabin-Scott-Konstruktion.
1976 bekamen beide dafür den Turing Award, den wichtigsten Preis der Informatik. Rabin machte später aus einem Primzahltest von Gary Miller einen schnellen Zufallstest: Wenn openssl ein RSA-Schlüsselpaar erzeugt, prüft es seine Primzahlen mit dem Test von Miller und Rabin.
Foto: Andrej Bauer, 2004, CC BY-SA 2.5 si, zugeschnitten (Wikimedia Commons)
Finite Automata and Their Decision Problems, Michael O. Rabin und Dana Scott, IBM Journal of Research and Development, 1959. Der Aufsatz, in dem endliche Automaten zum ersten Mal raten dürfen, mit dem Beweis, dass es zu jedem NEA einen DEA gibt, der dieselben Wörter annimmt, gebaut aus Mengen von Zuständen wie hier: als PDF, auch bei IEEE Xplore.
to_dea(nea):
    first ← closure({nea.start})
    states ← [first]
    todo ← [first]
    while todo not empty:
        set ← take one from todo
        for each symbol a:
            next ← closure(every target of (state, a) for each state in set)
            if next is empty: continue                 # Fehlerzustand
            if next not in states: add next to states and to todo
            delta[(set, a)] ← next
    accepting: every set that contains an accepting state of the nea
Schritt für Schritt für den NEA, den Automatron aus a*b baut: oben der NEA, die durchgezogenen Ringe sind set, die gestrichelten next; unten wächst der DEA, jeder Zustand mit seiner Menge darunter, an der Stelle, die er am Ende hat; daneben die Tabelle. Bei a* arbeitet die ε-Hülle mit.
Ein Beispiel ohne ε zum Nachrechnen: Dieser NEA nimmt die Wörter an, die auf aa enden.
Die Konstruktion beginnt mit {q0} und geht jede neue Menge mit jedem Zeichen durch:
| Zustand des DEA | Menge im NEA | a | b |
|---|---|---|---|
| → r0 | {q0} | {q0, q1} = r1, neu | {q0} = r0 |
| r1 | {q0, q1} | {q0, q1, q2} = r2, neu | {q0} = r0 |
| r2 (akzeptiert, enthält q2) | {q0, q1, q2} | {q0, q1, q2} = r2 | {q0} = r0 |
Keine neue Menge mehr: Der DEA hat drei Zustände. r1 heißt »zuletzt ein a gelesen«, r2 »zuletzt zwei a«.
Typische Fehler
Set (Python: ein frozenset, damit es als Schlüssel taugt) oder sortiert die Liste.Der DEA aus der Potenzmengenkonstruktion hat oft mehr Zustände als nötig. Zwei Zustände dürfen einer werden, wenn kein Wort sie unterscheidet: Von beiden aus nimmt der DEA genau dieselben Wörter an. Die Minimierung findet diese Zustände und legt sie zusammen. Heraus kommt der minimierte DEA, der DEA mit den wenigsten Zuständen für die Sprache; es gibt nur einen, bis auf die Namen der Zustände.
Man schreibt alle Paare von Zuständen in eine Tabelle und markiert die, die sicher verschieden sind:
minimize(dea):
    mark every pair (p, q) where exactly one of p and q is accepting
    repeat until nothing changes:
        for each unmarked pair (p, q):
            for each symbol a:
                if the pair (delta[(p, a)], delta[(q, a)]) is marked:
                    mark (p, q)
    the states of every unmarked pair become one state
Schritt für Schritt für den DEA, den Automatron aus (a|b)*abb baut, »endet auf abb«: Die beiden Ringe sind das Paar, das gerade dran ist, die gestrichelten das Paar, zu dem ein Zeichen führt; daneben die Tabelle der Paare.
Ein Paar wird markiert, wenn ein Zeichen es zu einem schon markierten Paar führt: Dann gibt es ein Wort, das die beiden unterscheidet, dieses Zeichen und dahinter das Wort für das andere Paar. Automatron baut für (a|b)*bb, »endet auf bb«, diesen DEA:
| r1 | r2 | r3 | |
|---|---|---|---|
| r0 | gleich | (b) | |
| r1 | (b) | ||
| r2 |
r0 und r1 werden ein Zustand s0, r2 wird s1, r3 wird s2. Der minimierte DEA hat drei Zustände:
Ein endlicher Automat geht bei jedem Zeichen in genau einen nächsten Zustand. Bei einer Markow-Kette entscheidet der Zufall: Jeder Übergang hat eine feste Wahrscheinlichkeit, und die Kette liest kein Wort, sie erzeugt eine Folge von Zuständen. Welcher Zustand als Nächstes kommt, hängt nur vom Zustand jetzt ab, nicht davon, wie die Kette dorthin kam. Ein Sprachmodell aus Wortpaaren ist eine Markow-Kette, deren Zustände die Wörter sind: Nach »Es« kommt mit einer gewissen Wahrscheinlichkeit »war«, mit einer anderen »ist«.
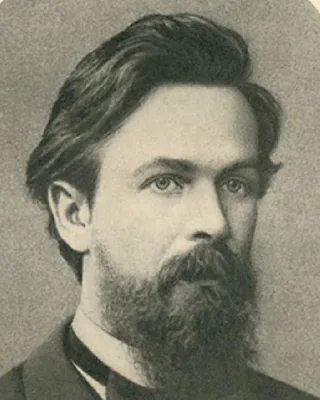
Andrei Markow (1856–1922), russischer Mathematiker in Sankt Petersburg. 1913 ging er die ersten 20 000 Buchstaben von Puschkins »Eugen Onegin« durch und zählte, wie oft auf einen Vokal ein Vokal folgt und wie oft ein Konsonant: Der nächste Buchstabe hängt vom vorigen ab, und mit dieser Abhängigkeit kann man rechnen.
Eine Kette, in der jedes Glied nur vom vorigen abhängt, heißt nach ihm Markow-Kette. Auch ein Sprachmodell aus Wortpaaren ist eine Markow-Kette.
Foto: unbekannt, 1886, gemeinfrei, zugeschnitten (Wikimedia Commons)
Wie man solche Automaten selbst programmiert, zeigt die Aktivität Endliche Automaten; Automatron rechnet alle Schritte dieser Seite für einen eigenen regulären Ausdruck durch. Automaten stehen in jedem Lehrbuch der theoretischen Informatik. Zum Weiterlesen: