powered by 
Ein regulärer Ausdruck ist ein Muster für Text: »eine Postleitzahl«, »ein Wort, das auf ing endet«, »eine Zeile mit einem Datum«. Hier stehen die Bausteine, mit denen man solche Muster schreibt, wie man sie in Ruby, Python, mit grep und in VS Code benutzt, und was sie mit endlichen Automaten zu tun haben: Hinter jedem regulären Ausdruck steckt ein Automat.
Reguläre Ausdrücke heißen auf Englisch regular expressions, kurz Regex oder Regexp. Ein Buchstabe oder eine Ziffer steht in ihnen für sich selbst: ing passt auf die drei Zeichen i, n, g hintereinander. Für »eines von mehreren Zeichen« gibt es Zeichenklassen:
| Muster | passt auf | Beispiel |
|---|---|---|
. |
ein beliebiges Zeichen außer dem Zeilenende |
h.t passt auf hat, hut, h7t |
[aeiou] |
eines der Zeichen in den Klammern |
h[aeiou]t passt auf hat, hut, nicht auf h7t |
[a-z], [0-9]
|
eines aus dem Bereich |
[A-Z][a-z] passt auf Ab, Xy |
[^0-9] |
ein Zeichen, das nicht in den Klammern steht |
[^ ] passt auf alles außer einem Leerzeichen |
\d, \w, \s
|
eine Ziffer, ein Wortzeichen (Buchstabe, Ziffer, _), ein Leerraum (Leerzeichen, Tab, Zeilenende) |
\d\d passt auf 42 |
\D, \W, \S
|
das Gegenteil davon |
\S+ passt auf ein ganzes Wort ohne Leerzeichen |
\., \*, \(
|
das Zeichen selbst: Ein \ nimmt einem Sonderzeichen seine Bedeutung |
3\.14 passt nur auf 3.14 |
| Muster | bedeutet | Beispiel |
|---|---|---|
A|B |
A oder B | Katze|Hund |
(…) |
fasst zusammen, wie in der Mathematik |
(ab)+ passt auf ab, abab, ababab |
A* |
A beliebig oft, auch keinmal: die Kleenesche Hülle (der Kleene-Stern) |
ab* passt auf a, ab, abbb |
A+ |
A mindestens einmal: die positive Hülle |
\d+ passt auf jede Zahl |
A? |
A höchstens einmal |
Farbe? passt auf Farb und Farbe |
A{3}, A{2,4}
|
genau dreimal, zwei- bis viermal |
\d{5} passt auf eine Postleitzahl |
^, $
|
Anfang und Ende einer Zeile |
^# passt auf Zeilen, die mit # beginnen |
*, + und ? gelten für das, was direkt davor steht: In ab* wiederholt sich nur das b, in (ab)* beides. Und sie nehmen so viel, wie sie können: <.*> passt in <b>fett</b> auf alles von der ersten < bis zur letzten >. Mit einem ? dahinter (<.*?>) nehmen sie so wenig wie möglich und passen nur auf <b>.
Am schnellsten probierst du einen Ausdruck in VS Code aus: Strg+F öffnet die Suche, Alt+R (oder der Knopf .*) schaltet reguläre Ausdrücke ein, und jede Stelle, auf die er passt, wird markiert. Beim Ersetzen (Strg+H) steht $1 für das, was die erste Klammer gefunden hat.
Den Automaten hinter einem Ausdruck zeichnet Automatron. Es kennt nur die Bausteine aus der Theorie, Zeichen, |, *, +, ? und Klammern, keine Zeichenklassen; [0-9] schreibst du dort als (0|1|2|3|4|5|6|7|8|9).
In Ruby steht ein regulärer Ausdruck zwischen Schrägstrichen:
plz = /\A\d{5}\z/
puts '10115'.match?(plz)            # true
puts '1011'.match?(plz)             # false

text = 'Am 3.10. und am 24.12. ist frei.'
p text.scan(/\d+\.\d+\./)           # ["3.10.", "24.12."]
puts text.gsub(/\d+/, '#')          # Am #.#. und am #.#. ist frei.

if (m = text.match(/(\d+)\.(\d+)\./))
  puts "Tag #{m[1]}, Monat #{m[2]}" # Tag 3, Monat 10
end
\A und \z sind Anfang und Ende des ganzen Strings. ^ und $ sind in Ruby Anfang und Ende jeder Zeile: /^\d{5}$/ passt auch auf einen String, in dem irgendwo eine Zeile nur aus fünf Ziffern besteht.
In Python stehen die Funktionen im Modul re. Das Muster schreibt man als Raw-String r"…", damit Python die Backslashes nicht selbst auswertet:
import re

print(bool(re.fullmatch(r"\d{5}", "10115")))   # True: der ganze String passt
print(bool(re.fullmatch(r"\d{5}", "1011")))    # False

text = "Am 3.10. und am 24.12. ist frei."
print(re.findall(r"\d+\.\d+\.", text))       # ['3.10.', '24.12.']
print(re.sub(r"\d+", "#", text))              # Am #.#. und am #.#. ist frei.

m = re.search(r"(\d+)\.(\d+)\.", text)
if m:
    print(f"Tag {m.group(1)}, Monat {m.group(2)}")   # Tag 3, Monat 10
re.fullmatch prüft den ganzen String, re.search sucht eine Stelle irgendwo darin, re.match eine am Anfang.
Im Terminal sucht grep Zeilen, auf die ein Ausdruck passt. Mit -E versteht es die Bausteine dieser Seite (+, ?, |, {…}, Klammern) ohne zusätzliche Backslashes; \d kennt es nicht, dafür schreibt man [0-9]:
grep -E "[0-9]{5}" adressen.txt          # Zeilen mit einer Postleitzahl
grep -E -o "[0-9]{5}" adressen.txt       # nur die Postleitzahlen
grep -E -c "^#" notizen.md               # wie viele Zeilen mit # beginnen
grep -E -v "^\s*$" notizen.md            # alle Zeilen, die nicht leer sind
Die anderen Schalter von grep (-i, -n, -r, …) stehen auf der Handbuch-Seite Terminal.
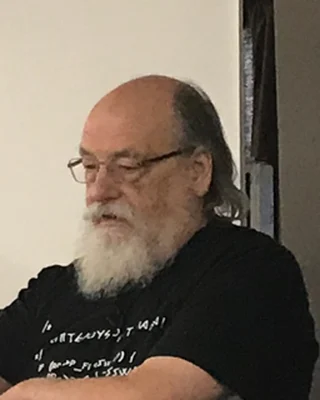
Ken Thompson (geboren 1943). Du suchst im Terminal mit grep? Das hat er 1973 geschrieben; der Name kommt aus seinem Texteditor, wo der Befehl g/re/p hieß: global, regular expression, print. Wie man aus einem regulären Ausdruck einen Automaten baut, hatte er schon 1968 beschrieben: die Thompson-Konstruktion.
Das Terminal selbst läuft unter Linux, und Linux funktioniert wie Unix, das er ab 1969 mit Dennis Ritchie schrieb. Unten rechts in VS Code steht UTF-8: Die Kodierung hat er 1992 mit Rob Pike auf ein Tischset in einem Diner gezeichnet. Und die Sprache Go hat er mit erfunden.
Foto: A. C. Diller, 2019, CC BY-SA 4.0, zugeschnitten (Wikimedia Commons)
Die Bausteine Zeichen, Hintereinander, | und * reichen für alles Reguläre; +, ?, {…} und die Zeichenklassen sind Abkürzungen dafür. Aus jedem solchen Ausdruck lässt sich ein endlicher Automat bauen, der genau die passenden Wörter annimmt, und aus jedem endlichen Automaten ein Ausdruck: Beide beschreiben dieselben Sprachen, die regulären Sprachen. Wie der Automat entsteht (Thompson-Konstruktion, Potenzmengenkonstruktion, Minimierung), steht auf der Handbuch-Seite Endliche Automaten. Für (a|b)*abb, »endet auf abb«, ist der minimierte DEA:
So arbeiten die Suchfunktionen in Editoren und grep im Prinzip: Sie lesen den Text Zeichen für Zeichen und merken sich, in welchen Zuständen des Automaten sie gerade sind.
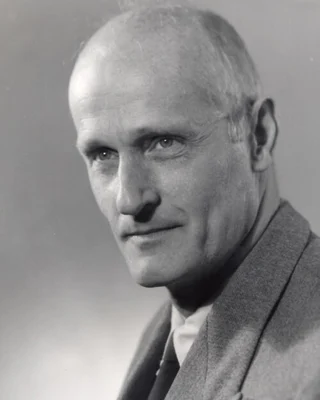
Stephen Cole Kleene (1909–1994), Mathematiker in Madison, Wisconsin. Jedes * in einem regulären Ausdruck, bei grep oder in der Suche von VS Code, ist sein Stern.
1951 wollte er wissen, welche Muster ein Netz aus Nervenzellen erkennen kann, und erfand dafür die Bausteine, die heute reguläre Ausdrücke heißen, zwanzig Jahre bevor es grep gab. Er bewies auch, dass sie und endliche Automaten genau dasselbe können.
Foto: Harold N. Hone, um 1963, gemeinfrei (Wikimedia Commons)
Was ein endlicher Automat nicht kann, kann auch kein regulärer Ausdruck aus diesen Bausteinen: zählen ohne Grenze. »Gleich viele a wie b« oder »jede öffnende Klammer hat eine schließende« ist keine reguläre Sprache. Ruby und Python können trotzdem etwas mehr, zum Beispiel Rückverweise: (\w+) \1 passt auf ein Wort, das zweimal hintereinander steht. Dafür reicht kein endlicher Automat mehr, und solche Muster können bei langen Texten sehr langsam werden.
Regexp: alle Bausteine, Optionen und Methoden in Ruby.re und das Regular Expression HOWTO: das Modul und eine Einführung.