powered by 
Wie kann ein Programm einen Satz weiterschreiben? Du zählst in den Märchen der Brüder Grimm, welches Wort auf welches folgt, und lässt dein Programm daraus neue Märchen schreiben, Wort für Wort. Dabei siehst du, was so ein Modell kann, wo es nur abschreibt und was es aus seinem Text übernimmt.
Tippst du auf dem Handy eine Nachricht, schlägt die Tastatur über den Buchstaben drei Wörter vor, die als Nächstes kommen könnten. Ein Chatbot macht im Grunde dasselbe, nur sehr viel besser: Er schreibt ein Wort, schaut, was bisher dasteht, schreibt das nächste Wort, und so weiter, bis die Antwort fertig ist. Ein Programm, das zu einem Text das nächste Wort vorhersagt, heißt Sprachmodell.
Du baust heute ein winziges Sprachmodell. Es lernt aus den Märchen der Brüder Grimm: 54 Märchen mit zusammen etwa 80 000 Wörtern, von »Marienkind« bis »Des Herrn und des Teufels Getier«. Lernen heißt hier: zählen, welches Wort wie oft auf welches folgt.
In den Märchen beginnen viele Sätze mit »Es«. Welches Wort folgt darauf am häufigsten?
Was so ein Modell zählt, merkt es sich in einem Dictionary, genauer in einem Dictionary von Dictionaries. Wie Dictionaries gehen, übst du in den Katas: Dictionaries.
Lege einen Ordner an und lade die Märchen herunter:
mkdir -p ~/sprachmodell
cd ~/sprachmodell
wget https://workspace.hackschule.de/sprachmodell/maerchen.txt
touch model.rb story.rb
In model.rb kommen die Funktionen deines Modells, in story.rb das Programm,
das damit Märchen schreibt. Ausprobieren kannst du die Funktionen in irb, das
model.rb vorher lädt:
irb -r ./model.rb
Nach einer Änderung an model.rb beendest du irb mit
StrgD und startest es neu.
Lege einen Ordner an und lade die Märchen herunter:
mkdir -p ~/sprachmodell
cd ~/sprachmodell
wget https://workspace.hackschule.de/sprachmodell/maerchen.txt
touch model.py story.py
In model.py kommen die Funktionen deines Modells, in story.py das Programm,
das damit Märchen schreibt. Ausprobieren kannst du die Funktionen in Python
selbst, das model.py vorher ausführt:
python3 -i model.py
Nach einer Änderung an model.py beendest du Python mit
StrgD und startest es neu.
Die Märchen stehen in der Schreibweise eines Buchs von 1921: »daß« statt »dass«, »Türe« statt »Tür«. Der Text kommt von Project Gutenberg, wo Freiwillige alte Bücher abtippen, die niemandem mehr gehören; die vier Märchen auf Plattdeutsch sind herausgenommen, damit das Modell nur eine Sprache lernt.
Ein Modell zählt Wörter, also muss der Text zuerst in Wörter zerlegt werden. Satzzeichen zählen dabei als eigene Wörter: Wer weiß, dass nach »König« oft ein Komma kommt und nach einem Punkt ein neuer Satz, schreibt Sätze, die enden. Anführungszeichen lässt das Modell weg, denn es kann sich nicht merken, ob es gerade eines geöffnet hat.
Schreib in model.rb:
# Der Text als Liste von Wörtern und Satzzeichen
def words(text)
  text.scan(/\p{L}+|[.,;:!?]/)
end
scan findet im Text alles, was zu dem Muster zwischen den Schrägstrichen
passt, einem regulären Ausdruck: \p{L}+ ist ein
oder mehrere Buchstaben hintereinander, auch Umlaute und ß, [.,;:!?] ein
Satzzeichen.
Schreib in model.py:
import random
import re


# Der Text als Liste von Wörtern und Satzzeichen
def words(text):
    return re.findall(r"[^\W\d_]+|[.,;:!?]", text)
re.findall findet im Text alles, was zu dem Muster passt, einem
regulären Ausdruck: [^\W\d_]+ ist ein oder
mehrere Buchstaben hintereinander, auch Umlaute und ß, [.,;:!?] ein
Satzzeichen. random brauchst du später.
words("Es war einmal ein König.")
auf. Achte darauf, was mit dem Punkt am Ende passiert.
Wie viele Wörter und Satzzeichen findet words in den ganzen Märchen?
Lies dazu maerchen.txt ein, ruf words damit auf und lass dir die
Länge der Liste geben.
In Ruby liest File.read("maerchen.txt") die Datei als einen String, in
Python open("maerchen.txt").read(). Die Länge einer Liste gibt
.size in Ruby und len(…) in Python.
Das Modell soll sich für jedes Wort merken, welche Wörter danach kamen und wie oft. Für den kleinen Text »Der Wolf kam. Der Wolf fraß. Der Jäger kam.« sieht das so aus:
{
  "Der" => { "Wolf" => 2, "Jäger" => 1 },
  "Wolf" => { "kam" => 1, "fraß" => 1 },
  "kam" => { "." => 2 },
  "." => { "Der" => 2 },
  "fraß" => { "." => 1 },
  "Jäger" => { "kam" => 1 }
}
{
    "Der": {"Wolf": 2, "Jäger": 1},
    "Wolf": {"kam": 1, "fraß": 1},
    "kam": {".": 2},
    ".": {"Der": 2},
    "fraß": {".": 1},
    "Jäger": {"kam": 1},
}
Ein Dictionary, dessen Werte wieder Dictionaries sind: Unter jedem Wort steht, was darauf folgte, und unter jedem Nachfolger, wie oft. Nach dem letzten Punkt kommt nichts mehr, darum zählt er nicht mit.
Was steht im Dictionary des Textes »Der Wolf kam. Der Jäger kam. Der Wolf lief.« unter »kam«?
follow_counts(tokens),
die zu einer Liste von Wörtern dieses Dictionary zurückgibt.
Geh die Liste mit einem Index durch, vom ersten bis zum vorletzten Wort: Das
Wort ist tokens[i], sein Nachfolger tokens[i + 1].
Kommt ein Wort zum ersten Mal vor, gibt es für es noch kein Dictionary. Leg es
dann an, mit counts[word] ||= {}. Ein Nachfolger, der noch fehlt, hat die
Anzahl 0: (counts[word][following] || 0) + 1.
def follow_counts(tokens)
  counts = {}
  (0...tokens.size - 1).each do |i|
    word = tokens[i]
    following = tokens[i + 1]
    # hier: das Dictionary für word anlegen, wenn es fehlt, und following zählen
  end
  counts
end
# Für jedes Wort: welche Wörter darauf folgen, und wie oft
def follow_counts(tokens)
  counts = {}
  (0...tokens.size - 1).each do |i|
    word = tokens[i]
    following = tokens[i + 1]
    counts[word] ||= {}
    counts[word][following] = (counts[word][following] || 0) + 1
  end
  counts
end
Geh die Liste mit einem Index durch, vom ersten bis zum vorletzten Wort: Das
Wort ist tokens[i], sein Nachfolger tokens[i + 1].
Kommt ein Wort zum ersten Mal vor, gibt es für es noch kein Dictionary. Leg es
dann an, wenn word not in counts ist. Ein Nachfolger, der noch fehlt, hat die
Anzahl 0: counts[word].get(following, 0) + 1.
def follow_counts(tokens):
    counts = {}
    for i in range(len(tokens) - 1):
        word = tokens[i]
        following = tokens[i + 1]
        # hier: das Dictionary für word anlegen, wenn es fehlt, und following zählen
    return counts
# Für jedes Wort: welche Wörter darauf folgen, und wie oft
def follow_counts(tokens):
    counts = {}
    for i in range(len(tokens) - 1):
        word = tokens[i]
        following = tokens[i + 1]
        if word not in counts:
            counts[word] = {}
        counts[word][following] = counts[word].get(following, 0) + 1
    return counts
Schreib in sprachmodell/model.rb die Funktion follow_counts(tokens).
Die Prüfung ruft sie mit kurzen Listen auf und vergleicht das
Dictionary, das herauskommt.
Schreib in sprachmodell/model.py die Funktion follow_counts(tokens).
Die Prüfung ruft sie mit kurzen Listen auf und vergleicht das
Dictionary, das herauskommt.
Jetzt zählt dein Modell die ganzen Märchen. Damit du nachsehen kannst, was auf
ein Wort folgt, schreib noch diese Funktion dazu; sie gibt die n häufigsten
Nachfolger mit ihrer Anzahl zurück:
# Die n häufigsten Nachfolger von word, mit ihrer Anzahl
def top(counts, word, n)
  (counts[word] || {}).sort_by { |following, count| -count }.first(n)
end
In irb:
counts = follow_counts(words(File.read("maerchen.txt")))
top(counts, "Es", 5)
# Die n häufigsten Nachfolger von word, mit ihrer Anzahl
def top(counts, word, n):
    followers = counts.get(word, {})
    return sorted(followers.items(), key=lambda pair: -pair[1])[:n]
In Python:
counts = follow_counts(words(open("maerchen.txt").read()))
top(counts, "Es", 5)
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
Auf »Es« folgt 41-mal »war«, 21-mal »ist« und 13-mal »trug«; zusammen kommt »Es« 150-mal vor.
Was folgt in den Märchen am häufigsten auf »sprach«? Schau mit top
nach.
Ein Modell, das zu jedem Wort seine Nachfolger kennt, kann schreiben: Es beginnt mit einem Wort, nimmt einen Nachfolger, dann dessen Nachfolger, und so weiter. Am einfachsten nimmt es jedes Mal den häufigsten.
most_likely(counts, word),
die den häufigsten Nachfolger von word zurückgibt, oder
nil (in Python None), wenn das Wort nie vorkam.
counts[word] ist das Dictionary der Nachfolger. Von seinen Paaren suchst du
das mit der größten Anzahl: max_by { |following, count| count } gibt dieses
Paar zurück, [following, count].
# Der häufigste Nachfolger von word, nil für ein unbekanntes Wort
def most_likely(counts, word)
  return nil unless counts.key?(word)

  counts[word].max_by { |following, count| count }[0]
end
counts[word] ist das Dictionary der Nachfolger. max findet seinen größten
Schlüssel; mit key=counts[word].get vergleicht es stattdessen die Anzahlen.
# Der häufigste Nachfolger von word, None für ein unbekanntes Wort
def most_likely(counts, word):
    if word not in counts:
        return None
    return max(counts[word], key=counts[word].get)
Schreib in sprachmodell/model.rb die Funktion most_likely(counts, word).
Die Prüfung ruft sie mit kleinen Dictionaries auf, auch mit einem Wort,
das darin fehlt.
Schreib in sprachmodell/model.py die Funktion most_likely(counts, word).
Die Prüfung ruft sie mit kleinen Dictionaries auf, auch mit einem Wort,
das darin fehlt.
Zum Schreiben noch eine Funktion, die eine Liste von Wörtern wieder als Text ausgibt, ohne Leerzeichen vor einem Satzzeichen:
# Wörter als Text, ohne Leerzeichen vor einem Satzzeichen
def text(tokens)
  tokens.join(" ").gsub(/ ([.,;:!?])/, '\1')
end
# Wörter als Text, ohne Leerzeichen vor einem Satzzeichen
def text(tokens):
    return re.sub(r" ([.,;:!?])", r"\1", " ".join(tokens))
Das Programm beginnt mit »Es« und hängt 30-mal das häufigste nächste Wort an. Was kommt heraus?
Schreib das Programm in story.rb; es lädt model.rb mit require_relative:
require_relative "model"

counts = follow_counts(words(File.read("maerchen.txt")))
tokens = ["Es"]
30.times do
  tokens << most_likely(counts, tokens.last)
end
puts text(tokens)
ruby story.rb
Schreib das Programm in story.py; es holt die Funktionen aus model.py mit
import:
from model import *

counts = follow_counts(words(open("maerchen.txt").read()))
tokens = ["Es"]
for _ in range(30):
    tokens.append(most_likely(counts, tokens[-1]))
print(text(tokens))
python3 story.py
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
Es war, und sprach: Ich bin ich will ich will ich will ich will ich will ich will ich will ich will ich will ich will ich will ich
Auf »ich« folgt am häufigsten »will«, auf »will« am häufigsten »ich«: Das Modell ist in einer Schleife gefangen und kommt nie wieder heraus. Und es schreibt jedes Mal genau diesen Text, denn es entscheidet nie anders.
Ein Modell, das nur das häufigste Wort nimmt, schreibt immer dasselbe. Besser: Es würfelt, aber so, dass ein häufiger Nachfolger öfter drankommt. Auf »Es« folgt 41-mal »war« und 21-mal »ist«; dann soll »war« ungefähr doppelt so oft gewählt werden wie »ist«.
Das geht mit einer Zufallszahl. Folgte auf ein Wort sechsmal »war«, dreimal »ist« und einmal »trug«, zusammen zehnmal, zieht das Modell eine Zahl von 0 bis 9 und geht die Nachfolger der Reihe nach durch:
| Zufallszahl | Nachfolger |
|---|---|
| 0, 1, 2, 3, 4, 5 | war |
| 6, 7, 8 | ist |
| 9 | trug |
Ist die Zahl kleiner als die Anzahl des ersten Nachfolgers, nimmt das Modell diesen Nachfolger. Sonst zieht es dessen Anzahl von der Zahl ab und vergleicht mit der Anzahl des nächsten Nachfolgers.
next_word(counts, word),
die einen Nachfolger von word so zieht, dass jeder so oft drankommt,
wie er gezählt wurde, und nil (in Python None) für ein
Wort, das nie vorkam.
Die Summe der Anzahlen ist counts[word].values.sum. rand(total) gibt eine
ganze Zufallszahl von 0 bis total - 1.
def next_word(counts, word)
  return nil unless counts.key?(word)

  r = rand(counts[word].values.sum)
  counts[word].each do |following, count|
    # hier: following zurückgeben, wenn r kleiner als count ist,
    # sonst count von r abziehen
  end
end
# Ein Nachfolger von word, gezogen nach seiner Anzahl; nil für ein unbekanntes Wort
def next_word(counts, word)
  return nil unless counts.key?(word)

  r = rand(counts[word].values.sum)
  counts[word].each do |following, count|
    return following if r < count

    r -= count
  end
end
Die Summe der Anzahlen ist sum(counts[word].values()). random.randrange(total)
gibt eine ganze Zufallszahl von 0 bis total - 1.
def next_word(counts, word):
    if word not in counts:
        return None
    r = random.randrange(sum(counts[word].values()))
    for following, count in counts[word].items():
        # hier: following zurückgeben, wenn r kleiner als count ist,
        # sonst count von r abziehen
        ...
# Ein Nachfolger von word, gezogen nach seiner Anzahl; None für ein unbekanntes Wort
def next_word(counts, word):
    if word not in counts:
        return None
    r = random.randrange(sum(counts[word].values()))
    for following, count in counts[word].items():
        if r < count:
            return following
        r -= count
Python kann das auch selbst: random.choices(list(followers), weights=list(followers.values()))[0]
zieht genauso. Hier war es dein Code.
Schreib in sprachmodell/model.rb die Funktion next_word(counts, word).
Die Prüfung zieht 4000-mal aus { "a" => 3, "b" => 1 } und erwartet
ungefähr dreimal so oft »a« wie »b«, dazu ein Wort mit nur einem
Nachfolger und eines, das fehlt.
Schreib in sprachmodell/model.py die Funktion next_word(counts, word).
Die Prüfung zieht 4000-mal aus {"a": 3, "b": 1} und erwartet
ungefähr dreimal so oft »a« wie »b«, dazu ein Wort mit nur einem
Nachfolger und eines, das fehlt.
generate(counts, start, n),
die mit dem Wort start beginnt und n Wörter mit
next_word anhängt. Sie gibt die Liste zurück und hört früher auf,
wenn ein Wort keinen Nachfolger hat.
Es ist das Programm aus story.rb, mit next_word statt most_likely, als
Funktion, die die Liste zurückgibt. Aufhören kann eine Schleife mit break.
# start und bis zu n gezogene Wörter danach
def generate(counts, start, n)
  tokens = [start]
  n.times do
    following = next_word(counts, tokens.last)
    break if following.nil?

    tokens << following
  end
  tokens
end
Es ist das Programm aus story.py, mit next_word statt most_likely, als
Funktion, die die Liste zurückgibt. Aufhören kann eine Schleife mit break.
# start und bis zu n gezogene Wörter danach
def generate(counts, start, n):
    tokens = [start]
    for _ in range(n):
        following = next_word(counts, tokens[-1])
        if following is None:
            break
        tokens.append(following)
    return tokens
Schreib in sprachmodell/model.rb die Funktion generate(counts, start, n).
Die Prüfung gibt ihr Dictionaries, in denen jedes Wort nur einen
Nachfolger hat, so dass das Ergebnis feststeht.
Schreib in sprachmodell/model.py die Funktion generate(counts, start, n).
Die Prüfung gibt ihr Dictionaries, in denen jedes Wort nur einen
Nachfolger hat, so dass das Ergebnis feststeht.
Ändere story.rb, so dass es drei Märchenanfänge schreibt:
counts = follow_counts(words(File.read("maerchen.txt")))3.times do puts text(generate(counts, "Es", 30)) putsend
Ändere story.py, so dass es drei Märchenanfänge schreibt:
counts = follow_counts(words(open("maerchen.txt").read()))for _ in range(3): print(text(generate(counts, "Es", 30))) print()
Zum Beispiel:
Es trug sich um zu dem Richter, dann wollen wir uns doch der König in solche Blume, in einer kurzen Marsch haben will gleich nicht zu den sieben Zwerge
Wenn dein Modell das nächste Wort zieht: Was von dem bisher Geschriebenen berücksichtigt es?
Der Mathematiker Claude Shannon hat 1948 genau solche Texte erzeugt, ohne Computer: Er schlug ein Buch an einer zufälligen Stelle auf, las bis zu dem Wort, das er zuletzt aufgeschrieben hatte, und schrieb das Wort dahinter auf. Dann blätterte er weiter zu einer anderen Stelle, suchte dort dieses Wort, und so weiter. Ein Buch würfelt so von selbst nach der Häufigkeit: Ein Wort, das oft folgt, findet man oft.
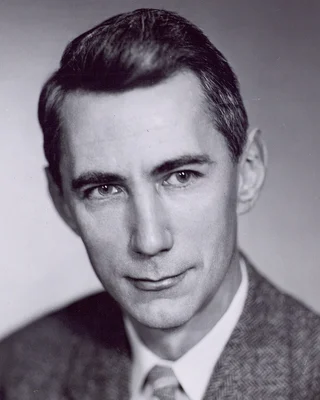
Claude Shannon (1916–2001). Wie viele Bits eine Nachricht mindestens braucht, rechnete er 1948 aus und gründete damit die Informationstheorie; das Wort Bit machte er bekannt. Er fuhr Einrad, jonglierte und baute die Maus Theseus, die selbst lernte, durch ein Labyrinth zu finden.
Einen Code mit so wenigen Bits wie möglich suchten er und Robert Fano fast gleichzeitig, jeder für sich. Der Shannon-Fano-Code kam nah heran, aber nicht immer ganz.
In derselben Arbeit von 1948 ließ er englische Texte Wort für Wort entstehen, jedes Wort nach dem vorigen aus einem Buch gezogen: ein winziges Sprachmodell, von Hand.
Foto: Tekniska museet, CC BY 2.0, zugeschnitten (Wikimedia Commons)
A Mathematical Theory of Communication, Claude E. Shannon, Bell System Technical Journal, 1948. Der Aufsatz, mit dem die Informationstheorie beginnt; in Abschnitt 3 stehen englische Texte aus Buchstaben und aus Wörtern, jedes nach dem vorigen gezogen, wie bei dir: PDF, auch bei Wiley.
Gezählt hatte vor ihm schon Andrei Markow: 1913 ging er die ersten 20 000 Buchstaben von Puschkins Versroman »Eugen Onegin« durch und zählte, wie oft auf einen Vokal ein Vokal folgt und wie oft ein Konsonant. Eine Kette, in der jedes Glied nur vom vorigen abhängt, heißt seitdem Markow-Kette, und dein Modell ist eine Markow-Kette: Welches Wort es zieht, hängt nur vom Wort davor ab.
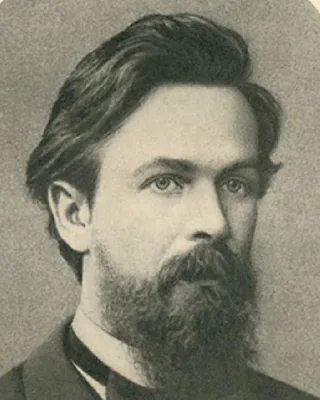
Andrei Markow (1856–1922), russischer Mathematiker in Sankt Petersburg. 1913 ging er die ersten 20 000 Buchstaben von Puschkins »Eugen Onegin« durch und zählte, wie oft auf einen Vokal ein Vokal folgt und wie oft ein Konsonant: Der nächste Buchstabe hängt vom vorigen ab, und mit dieser Abhängigkeit kann man rechnen.
Eine Kette, in der jedes Glied nur vom vorigen abhängt, heißt nach ihm Markow-Kette. Auch ein Sprachmodell aus Wortpaaren ist eine Markow-Kette.
Foto: unbekannt, 1886, gemeinfrei, zugeschnitten (Wikimedia Commons)
Dein Modell schaut nur auf das letzte Wort. Was vorher stand, hat es vergessen.
Schaut es auf die letzten zwei, weiß es mehr: Nach »sprach der« kommt ein
anderes Wort als nach »Da sprach«. Der Kontext ist jetzt ein Paar von
Wörtern, und als Schlüssel nimmt das Modell beide zusammen, mit einem
Leerzeichen dazwischen: Unter "sprach der" steht, was nach »sprach der« kam.
pair_counts(tokens):
wie follow_counts, aber der Schlüssel sind zwei Wörter
hintereinander, mit einem Leerzeichen dazwischen, und gezählt wird das Wort
danach.
Der Index läuft jetzt nur bis zum drittletzten Wort. Der Schlüssel ist
"#{tokens[i]} #{tokens[i + 1]}", der Nachfolger tokens[i + 2].
# Für jedes Paar von Wörtern: welche Wörter darauf folgen, und wie oft
def pair_counts(tokens)
  counts = {}
  (0...tokens.size - 2).each do |i|
    pair = "#{tokens[i]} #{tokens[i + 1]}"
    following = tokens[i + 2]
    counts[pair] ||= {}
    counts[pair][following] = (counts[pair][following] || 0) + 1
  end
  counts
end
Der Index läuft jetzt nur bis zum drittletzten Wort. Der Schlüssel ist
tokens[i] + " " + tokens[i + 1], der Nachfolger tokens[i + 2].
# Für jedes Paar von Wörtern: welche Wörter darauf folgen, und wie oft
def pair_counts(tokens):
    counts = {}
    for i in range(len(tokens) - 2):
        pair = tokens[i] + " " + tokens[i + 1]
        following = tokens[i + 2]
        if pair not in counts:
            counts[pair] = {}
        counts[pair][following] = counts[pair].get(following, 0) + 1
    return counts
Schreib in sprachmodell/model.rb die Funktion pair_counts(tokens).
Die Prüfung ruft sie mit kurzen Listen auf und vergleicht das
Dictionary.
Schreib in sprachmodell/model.py die Funktion pair_counts(tokens).
Die Prüfung ruft sie mit kurzen Listen auf und vergleicht das
Dictionary.
Gleich schreibt dein Modell mit zwei Wörtern Kontext. Wie wird der Text?
Zum Schreiben braucht das Modell eine zweite Fassung von generate, die mit
zwei Wörtern beginnt und jedes Mal die letzten beiden als Schlüssel nimmt:
# first, second und bis zu n gezogene Wörter danach, mit zwei Wörtern Kontext
def generate_pairs(counts, first, second, n)
  tokens = [first, second]
  n.times do
    following = next_word(counts, tokens.last(2).join(" "))
    break if following.nil?

    tokens << following
  end
  tokens
end
Und in story.rb:
pairs = pair_counts(words(File.read("maerchen.txt")))
3.times do
  puts text(generate_pairs(pairs, "Es", "war", 30))
  puts
end
# first, second und bis zu n gezogene Wörter danach, mit zwei Wörtern Kontext
def generate_pairs(counts, first, second, n):
    tokens = [first, second]
    for _ in range(n):
        following = next_word(counts, " ".join(tokens[-2:]))
        if following is None:
            break
        tokens.append(following)
    return tokens
Und in story.py:
pairs = pair_counts(words(open("maerchen.txt").read()))
for _ in range(3):
    print(text(generate_pairs(pairs, "Es", "war", 30)))
    print()
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
Es war da ganz finster und brannte auch kein Schiffchen, antwortete der Wolf wollte, ließ er sich auf den Herd und guckte nach dem Sperling. Aber der Sperling:
Je zwei, drei Wörter hintereinander klingen jetzt wie ein Märchen, ganze Satzstücke sogar. Nur ob das Ganze einen Sinn ergibt, weiß das Modell immer noch nicht.
Klingt der Text besser, weil das Modell mehr verstanden hat? Schau nach, wie viel Auswahl es noch hat. Hat ein Paar von Wörtern in den Märchen nur einen einzigen Nachfolger, kann das Modell nach diesem Paar nur genau das Wort schreiben, das im Märchen steht: Es schreibt ab.
Wie viel Prozent der Paare in pair_counts haben in den Märchen genau
einen Nachfolger? Runde auf eine ganze Zahl.
Ein Paar hat genau einen Nachfolger, wenn sein Dictionary nur einen Eintrag hat. Zähl diese Paare und teile durch die Zahl aller Paare.
In Ruby: pairs.count { |pair, followers| followers.size == 1 }, in
Python sum(1 for followers in pairs.values() if len(followers) == 1).
Die Zahl aller Paare ist pairs.size oder len(pairs); mal 100.
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
Bei 78 von 100 Paaren gibt es nur einen Nachfolger, bei einzelnen Wörtern nur bei 55 von 100. Mit zwei Wörtern Kontext schreibt das Modell also meistens ab, was in den Märchen steht, und nur ab und zu biegt es an einem häufigen Paar wie »sprach der« in ein anderes Märchen ab. Mit drei Wörtern wäre es fast nur noch Abschreiben.
Das ist das Dilemma jedes Sprachmodells: Mehr Kontext macht den Text besser, aber jeder längere Kontext ist im Text seltener, und das Modell hat weniger, aus dem es lernen kann. Mit 80 000 Wörtern ist bei zwei Wörtern Schluss. Große Sprachmodelle lernen darum aus Billionen von Wörtern, und auch sie geben manchmal ganze Absätze aus ihren Texten wörtlich wieder.
Dein Modell kennt nur die Märchen. Was dort oft steht, schreibt es oft; was dort nie steht, schreibt es nie. Es hat keine Meinung, aber es gibt die Meinungen seines Textes weiter.
Was folgt in den Märchen am häufigsten auf »böse«? Vermute erst, dann
schau mit top(counts, "böse", 4) nach.
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
Auf »böse« folgen in den Märchen am häufigsten »Weib« und »Hexe«, je dreimal, dann »Stiefmutter« und »Buben«, je zweimal: vor allem Frauen. Von den 14 Malen, die »böse« in den Märchen steht, ist es achtmal eine Frau. Schreibt das Modell »böse«, schreibt es danach also meistens eine Frau. Die Märchen sind 200 Jahre alt, aber große Sprachmodelle lernen genauso aus dem, was Menschen geschrieben haben, und übernehmen, was darin häufig ist, auch Vorurteile. Wer ein solches Modell baut, muss nachsehen, was es gelernt hat, und entscheiden, was er dagegen tut.
Ein Chatbot rechnet auch nur aus, welches Wort als Nächstes kommt, und würfelt dann. Aber fast alles andere ist größer:
| Dein Modell | Ein großes Sprachmodell | |
|---|---|---|
| Text zum Lernen | 80 000 Wörter Märchen | Billionen von Wörtern aus dem Netz, aus Büchern, aus Code |
| Kontext | das letzte Wort oder die letzten zwei | Hunderttausende Wörter, das ganze Gespräch bis jetzt |
| Was es sich merkt | eine Tabelle: wie oft welches Wort folgte | ein neuronales Netz mit Milliarden von Zahlen, die beim Training eingestellt werden |
| Ein unbekannter Kontext | kein Nachfolger, Schluss | ein Kontext, der ähnlichen Texten gleicht, bekommt ähnliche Nachfolger |
| Wörter | ganze Wörter und Satzzeichen | Tokens: häufige Wörter ganz, seltene in Stücken |
Die Tabelle deines Modells kann für einen Kontext, der nie vorkam, nichts sagen. Ein neuronales Netz kann es, weil es nicht jeden Kontext einzeln speichert, sondern lernt, welche Kontexte einander ähneln. Gleich bleibt die Idee: aus vielen Texten lernen, wie es weitergeht, und dann Wort für Wort ziehen.
Ein Extra für Schnelle. Wer es auslässt, springt zu Zum Nachschlagen.
Dein Modell lernt aus jedem Text, nicht nur aus Märchen. Lade einen anderen
herunter, etwa ein Buch von Project Gutenberg,
oder nehmt als Klasse eure eigenen Texte, und ersetze maerchen.txt in
story.rb (in Python story.py) durch die neue Datei.
words