powered by 
Im Morsecode ist E ein einziger kurzer Ton und Q ein langes Lang-lang-kurz-lang, weil E so viel häufiger vorkommt. Huffman-Codes machen dasselbe mit Bytes, aber so, dass man keine Pausen braucht, um zu wissen, wo ein Code aufhört. Du baust den Baum, aus dem die Codes kommen, in Ruby oder Python, codierst und decodierst damit und findest heraus, wie JPEG seine Huffman-Tabellen mit ein paar Bytes speichert.
Jedes Byte hat 8 Bits, ob es ein »e« ist, in einem deutschen Text etwa jeder sechste Buchstabe, oder ein »q«, das kaum vorkommt. Das ist bequem, aber verschwenderisch. Samuel Morse und Alfred Vail haben das schon in den 1830er Jahren besser gemacht: Im Morsecode ist E ein einziger kurzer Ton (·), T ein langer (−), und seltene Buchstaben wie Q (−−·−) sind lang. Im Mittel wird eine Nachricht so kürzer.
Der Morsecode braucht dafür Pausen zwischen den Buchstaben: Ohne sie könnte ·· ein I sein oder zweimal E. Ein Computer soll ohne Pausen auskommen. Mit der Tabelle unten geht das. Lies 0101100 Bit für Bit und achte darauf, an welchem Bit du jeweils sicher bist, dass ein Code zu Ende ist.
| Zeichen | Code |
|---|---|
| A | 0 |
| B | 10 |
| R | 110 |
| C | 1110 |
| D | 1111 |
Mit dieser Tabelle ist 0101100 eindeutig: 0 ist A, dann 10 ist B, 110 ist R, 0 ist A.
Der Morsecode braucht Pausen, die Tabelle oben kommt ohne sie aus. Wann lässt sich eine Codetabelle ohne Pausen eindeutig lesen?
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
Kein Code der Tabelle ist der Anfang eines anderen, also gibt es keine zweite Möglichkeit. Eine solche Codetabelle heißt präfixfrei: Wer Bit für Bit liest, weiß in dem Moment, in dem ein Code vollständig ist, dass er zu Ende ist. Im Morsecode ist dagegen E (·) der Anfang von I (··), darum braucht er die Pausen.
Welche dieser Tabellen ist präfixfrei, lässt sich also ohne Pausen eindeutig lesen?
Wie findet man die besten Codes, also die, mit denen ein Text so wenige Bits wie möglich braucht? Diese Frage stellte Robert Fano 1951 seinen Studierenden am MIT als Hausarbeit, statt einer Prüfung. Er selbst kannte nur ein Verfahren, das gute, aber nicht immer die besten Codes findet. David Huffman fand nach Monaten eins, das immer die besten findet, und es ist erstaunlich einfach:
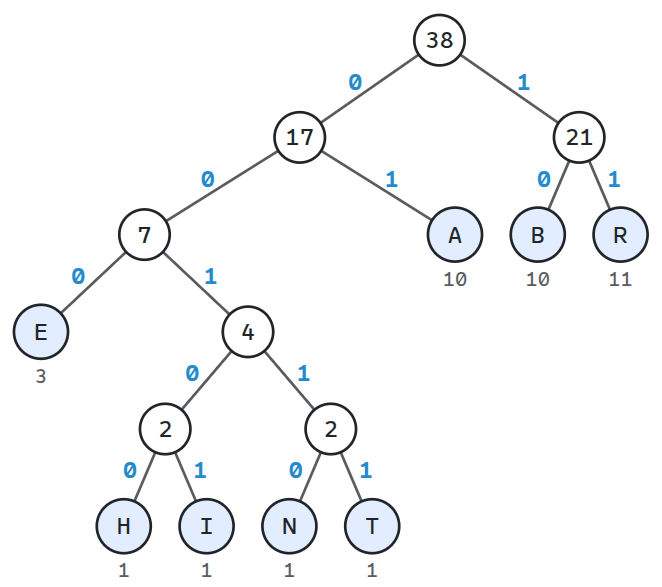
Den Code eines Bytes liest du auf dem Weg von oben zu seinem Blatt ab: links eine 0, rechts eine 1. Seltene Bytes werden früh zusammengefasst und landen tief unten, mit langen Codes; häufige kommen spät dazu und bleiben oben, mit kurzen. Und weil jedes Byte an einem Blatt hängt und nie auf dem Weg zu einem anderen liegt, ist die Tabelle von selbst präfixfrei.
Die Tabelle von oben ist so ein Baum. Der Weg zu R geht nach rechts, rechts und links, und das ist sein Code 110. Keiner der fünf Buchstaben liegt auf dem Weg zu einem anderen:
David A. Huffman (1925–1999), amerikanischer Informatiker. Als Student am MIT wollte er 1951 lieber die Hausarbeit schreiben als die Prüfung. Monatelang fand er nichts, und als er schon aufgeben wollte, kam ihm die Idee, den Baum von unten zu bauen, aus den zwei seltensten Zeichen. Sein Professor Robert Fano hatte mit Claude Shannon von oben gebaut und nicht immer die besten Codes gefunden.
Huffman-Codes stecken in ZIP, PNG, JPEG und MP3.
A Method for the Construction of Minimum-Redundancy Codes, David A. Huffman, Proceedings of the IRE, 1952. Auf vier Seiten der Baum, den du hier von unten baust, immer aus den beiden seltensten Zeichen: PDF, auch beim IEEE.
Probier es aus, mit einem der Texte oben. Lila umrandet sind die beiden Bäume, die als nächste zusammenkommen. Es zählen nur die Gewichte oben an den Bäumen: Sind zwei Bäume zusammengefasst, zählt ihre Summe, und ihre eigenen Zahlen werden blass.
Haben zwei Bäume dasselbe Gewicht, ist es egal, welchen man nimmt. Die Codes sehen dann anders aus, manche sind sogar anders lang, aber der Text braucht insgesamt genau gleich viele Bits.
Bau den Huffman-Baum für ABRACADABRA auf Papier: A kommt 5-mal vor,
B und R je 2-mal, C und D je einmal. Wie viele Bits braucht der ganze
Text mit diesen Codes?
Fass zuerst C und D zusammen (Gewicht 2). Dann gibt es drei Bäume mit Gewicht 2. Am Ende zählst du für jedes Zeichen Anzahl mal Länge seines Codes zusammen.
Lege im Terminal (StrgJ) einen Ordner an und öffne ihn mit StrgK StrgO:
mkdir /workspace/huffman
Lege darin die Datei huffman.rb an:
# Huffman-Codes: häufige Bytes bekommen kurze Codes, seltene lange.
#
# Ein Baum ist entweder ein Blatt, das Byte selbst (eine Zahl), oder ein
# Knoten, ein Array [links, rechts]. Links steht für 0, rechts für 1.

# Wie oft jedes Byte vorkommt: {65 => 5, 66 => 2, ...}
def frequencies(data)
end

# Immer die beiden leichtesten Bäume zusammenfassen, bis einer übrig ist.
def build_tree(counts)
end

# Der Code jedes Bytes als String aus 0 und 1: {65 => '0', 66 => '10', ...}
def code_table(tree)
end

# Der ganze Text als String aus 0 und 1
def encode(data, table)
end

# Aus den Bits und dem Baum wieder die Bytes
def decode(bits, tree)
end

p frequencies('ABRACADABRA')
Lege darin die Datei huffman.py an:
# Huffman-Codes: häufige Bytes bekommen kurze Codes, seltene lange.
#
# Ein Baum ist entweder ein Blatt, das Byte selbst (eine Zahl), oder ein
# Knoten, ein Tupel (links, rechts). Links steht für 0, rechts für 1.


def frequencies(data):
    """Wie oft jedes Byte vorkommt: {65: 5, 66: 2, ...}"""


def build_tree(counts):
    """Immer die beiden leichtesten Bäume zusammenfassen, bis einer übrig ist."""


def code_table(tree):
    """Der Code jedes Bytes als String aus 0 und 1: {65: '0', 66: '10', ...}"""


def encode(data, table):
    """Der ganze Text als String aus 0 und 1"""


def decode(bits, tree):
    """Aus den Bits und dem Baum wieder die Bytes"""


print(frequencies(b'ABRACADABRA'))
b'ABRACADABRA' sind Bytes, keine Zeichen; alle Methoden bekommen und liefern Bytes.
Die Bits schreiben wir der Einfachheit halber als String aus den Zeichen 0 und 1. Echte Programme packen je 8 davon in ein Byte, wie GIF und JPEG es tun; gezählt wird hier trotzdem in Bits.
Schreib frequencies. Es gibt einen Hash zurück, der für jedes Byte des Texts sagt, wie oft es vorkommt.
Schreib frequencies. Es gibt ein dict zurück, das für jedes Byte des Texts sagt, wie oft es vorkommt.
data.each_byte { |byte| … } geht die Bytes durch, als Zahlen.Hash.new(0) ist ein Hash, der für jeden Schlüssel, den es noch nicht gibt, 0 liefert. Damit kannst du gleich counts[byte] += 1 schreiben.for byte in data: geht die Bytes durch, als Zahlen.counts.get(byte, 0) liefert 0, wenn es das Byte noch nicht gibt. Damit kannst du gleich counts[byte] = counts.get(byte, 0) + 1 schreiben.Schreib frequencies in huffman.rb.
Mit counts = Hash.new(0) liefert counts[byte] für jedes neue Byte 0, und counts[byte] += 1 zählt.
Schreib frequencies in huffman.py.
Mit counts[byte] = counts.get(byte, 0) + 1 zählst du, auch wenn es das Byte noch nicht gibt.
Schreib build_tree nach den drei Schritten von oben. Ein Blatt ist das Byte selbst, eine Zahl; ein Knoten ist ein Array aus seinen beiden Kindern. Für »ABRACADABRA« könnte der Baum so aussehen: [65, [[67, 68], [66, 82]]].
Schreib build_tree nach den drei Schritten von oben. Ein Blatt ist das Byte selbst, eine Zahl; ein Knoten ist ein Tupel aus seinen beiden Kindern. Für »ABRACADABRA« könnte der Baum so aussehen: (65, ((67, 68), (66, 82))).
Als Bild: Jede Klammer ist ein Knoten mit zwei Kindern, links das erste, rechts das zweite, und unter jedem Blatt steht sein Byte als Zahl.
[weight, tree], am Anfang eines für jedes Byte.sort_by! { |weight, _| weight } sortiert die Liste nach dem Gewicht, shift nimmt das erste Element heraus. Zweimal shift nach dem Sortieren gibt dir die beiden leichtesten.(weight, tree), am Anfang eines für jedes Byte.trees.sort(key=lambda pair: pair[0]) sortiert die Liste nach dem Gewicht, trees.pop(0) nimmt das erste Element heraus. Zweimal pop(0) nach dem Sortieren gibt dir die beiden leichtesten.Dann code_table: Es geht den Baum von oben durch und merkt sich den Weg. Am einfachsten ist das mit einer Methode, die sich selbst aufruft, für das linke Kind mit einer 0 mehr im Weg, für das rechte mit einer 1. Kommt sie an ein Blatt, also an eine Zahl (tree.is_a?(Integer)), ist der Weg bis dorthin der Code dieses Bytes. Eine Methode darf dafür weitere Parameter mit Standardwerten haben, etwa def code_table(tree, prefix = '', table = {}).
Dann code_table: Es geht den Baum von oben durch und merkt sich den Weg. Am einfachsten ist das mit einer Funktion, die sich selbst aufruft, für das linke Kind mit einer 0 mehr im Weg, für das rechte mit einer 1. Kommt sie an ein Blatt, also an eine Zahl (isinstance(tree, int)), ist der Weg bis dorthin der Code dieses Bytes. Eine Funktion darf dafür weitere Parameter mit Standardwerten haben, etwa def code_table(tree, prefix=''); table.update(…) nimmt die Einträge eines anderen dict dazu.
Ein Sonderfall: Besteht der Text aus einem einzigen Byte, immer wieder, ist der Baum nur ein Blatt, und der Weg dorthin ist leer. Gib diesem Byte dann den Code 0.
Schreib build_tree und code_table. Weil es bei Gleichstand mehrere
richtige Bäume gibt, prüft die Aufgabe nicht die Codes selbst, sondern
ob sie präfixfrei sind und ob der Text mit ihnen so wenige Bits braucht
wie möglich.
Mach es erst von Hand, wie in »Von Hand«: Am Anfang ist jedes Byte ein eigener kleiner Baum, mit seiner Anzahl als Gewicht. Was passiert in jedem Schritt mit den beiden leichtesten Bäumen, und wann bist du fertig?
Halte eine Liste von Paaren [Gewicht, Baum], am Anfang [count, byte]
für jedes Byte. Solange mehr als ein Paar darin ist: nach dem Gewicht
sortieren, die beiden leichtesten herausnehmen und ein neues Paar
zurücklegen, aus der Summe ihrer Gewichte und [linker Baum, rechter
Baum]. Für code_table gehst du durch den Baum: links kommt eine
0 an den Code, rechts eine 1, bis du an einem Blatt bist.
Ein Gerüst; was hinter # hier fehlt, schreibst du:
def build_tree(counts)
    trees = counts.map { |byte, count| [count, byte] }
    while trees.size > 1
        trees.sort_by! { |weight, _| weight }
        left = trees.shift
        right = trees.shift
        # hier: ein neues Paar zurück in trees
    end
    # hier: der Baum aus dem letzten Paar
end

def code_table(tree, prefix = '', table = {})
    if tree.is_a?(Integer)
        # hier: ein Blatt bekommt prefix als Code (ein einziges Blatt: '0')
    else
        # hier: links weiter mit prefix + '0', rechts mit prefix + '1'
    end
    table
end
Schreib build_tree und code_table. Weil es bei Gleichstand mehrere
richtige Bäume gibt, prüft die Aufgabe nicht die Codes selbst, sondern
ob sie präfixfrei sind und ob der Text mit ihnen so wenige Bits braucht
wie möglich.
Mach es erst von Hand, wie in »Von Hand«: Am Anfang ist jedes Byte ein eigener kleiner Baum, mit seiner Anzahl als Gewicht. Was passiert in jedem Schritt mit den beiden leichtesten Bäumen, und wann bist du fertig?
Halte eine Liste von Paaren (Gewicht, Baum), am Anfang (count, byte)
für jedes Byte. Solange mehr als ein Paar darin ist: nach dem Gewicht
sortieren, die beiden leichtesten herausnehmen und ein neues Paar
anhängen, aus der Summe ihrer Gewichte und (linker Baum, rechter
Baum). Für code_table gehst du durch den Baum: links kommt eine
0 an den Code, rechts eine 1, bis du an einem Blatt bist.
Ein Gerüst; was hinter # hier fehlt, schreibst du:
def build_tree(counts):
    trees = [(count, byte) for byte, count in counts.items()]
    while len(trees) > 1:
        trees.sort(key=lambda pair: pair[0])
        left = trees.pop(0)
        right = trees.pop(0)
        # hier: ein neues Paar an trees anhängen
    # hier: den Baum aus dem letzten Paar zurückgeben

def code_table(tree, prefix=''):
    if isinstance(tree, int):
        # hier: ein Blatt bekommt prefix als Code (ein einziges Blatt: '0')
        ...
    # hier: die Codes links mit prefix + '0' und rechts mit prefix + '1'
    # zusammen in ein dict
encode ist kurz: Für jedes Byte der Code aus der Tabelle, alle hintereinander. join hängt eine Liste von Strings aneinander.
encode ist kurz: Für jedes Byte der Code aus der Tabelle, alle hintereinander. ''.join(…) hängt Strings aneinander.
decode liest die Bits einzeln und geht dabei im Baum nach unten, bei 0 nach links (node[0]), bei 1 nach rechts (node[1]). Kommt es an ein Blatt, hat es ein Byte gefunden, merkt es sich und beginnt wieder oben. Wie bei LZW macht pack('C*') am Schluss aus den Zahlen einen String. Denk auch hier an den Baum, der nur ein Blatt ist.
decode liest die Bits einzeln und geht dabei im Baum nach unten, bei 0 nach links (node[0]), bei 1 nach rechts (node[1]). Kommt es an ein Blatt, hat es ein Byte gefunden, merkt es sich und beginnt wieder oben. Wie bei LZW macht bytes(…) am Schluss aus den Zahlen Bytes. Denk auch hier an den Baum, der nur ein Blatt ist.
Schreib encode und decode.
encode hängt für jedes Byte seinen Code aus table aneinander. Für
decode probier es erst von Hand: Wo im Baum [65, [[67, 68], [66, 82]]]
landest du nach den Bits 1, 1, 0, wenn 0 links heißt und 1
rechts?
Merk dir, wo du im Baum gerade bist: node = tree am Anfang, dann für
jedes Bit node = node[0] oder node = node[1]. Ist node eine Zahl,
ist ein Byte fertig: Merk es dir und fang wieder oben an. Ein Baum,
der nur ein Blatt ist, braucht einen Sonderfall: Dort steht jede 0
für dieses Byte.
Ein Gerüst für decode:
def decode(bits, tree)
    # hier: der Sonderfall, tree ist nur ein Blatt
    out = []
    node = tree
    bits.each_char do |bit|
        # hier: node einen Schritt nach links oder rechts
        if node.is_a?(Integer)
            # hier: ein Byte fertig
        end
    end
    out.pack('C*')
end
Schreib encode und decode.
encode hängt für jedes Byte seinen Code aus table aneinander. Für
decode probier es erst von Hand: Wo im Baum (65, ((67, 68), (66, 82)))
landest du nach den Bits 1, 1, 0, wenn 0 links heißt und 1
rechts?
Merk dir, wo du im Baum gerade bist: node = tree am Anfang, dann für
jedes Bit node = node[0] oder node = node[1]. Ist node eine Zahl,
ist ein Byte fertig: Merk es dir und fang wieder oben an. Ein Baum,
der nur ein Blatt ist, braucht einen Sonderfall: Dort steht jede 0
für dieses Byte.
Ein Gerüst für decode:
def decode(bits, tree):
    # hier: der Sonderfall, tree ist nur ein Blatt
    out = []
    node = tree
    for bit in bits:
        # hier: node einen Schritt nach links oder rechts
        if isinstance(node, int):
            # hier: ein Byte fertig
            ...
    return bytes(out)
data = 'Fischers Fritz fischt frische Fische, frische Fische fischt Fischers Fritz.', mit tree = build_tree(frequencies(data)) und bits = encode(data, code_table(tree)). Dreh dann ein Bit um, mit bits[100] = bits[100] == '0' ? '1' : '0', und gib decode(bits, tree) aus. Ist nur ein Zeichen falsch oder alles danach? Probier auch andere Stellen als 100: Findet decode wieder in den Text zurück, und warum?
data = b'Fischers Fritz fischt frische Fische, frische Fische fischt Fischers Fritz.', mit tree = build_tree(frequencies(data)) und bits = encode(data, code_table(tree)). Dreh dann ein Bit um, mit bits = bits[:100] + ('1' if bits[100] == '0' else '0') + bits[101:], und gib decode(bits, tree) aus. Ist nur ein Zeichen falsch oder alles danach? Probier auch andere Stellen als 100: Findet decode wieder in den Text zurück, und warum?
Lade die Spezifikation von GIF in den Ordner, einen Text von 1990 mit 83.003 Bytes, und ein Foto als JPEG:
wget https://workspace.hackschule.de/lzw/spec-gif89a.txt
wget https://workspace.hackschule.de/jpeg/44-baseline.jpg
File.binread('spec-gif89a.txt') liest sie Byte für Byte. Lass dein Programm ausgeben, wie viele Bits encode daraus macht, und probier gleich, ob decode die Datei wieder genau herausgibt.
open('spec-gif89a.txt', 'rb').read() liest sie als Bytes; das b in 'rb' ist wichtig. Lass dein Programm ausgeben, wie viele Bits encode daraus macht, und probier gleich, ob decode die Datei wieder genau herausgibt.
Wie viele Bytes braucht spec-gif89a.txt mit Huffman, also die Zahl
der Bits durch 8, aufgerundet?
encode(data, table).length ist die Zahl der Bits.
Wie viele Bytes braucht spec-gif89a.txt mit Huffman, also die Zahl
der Bits durch 8, aufgerundet?
len(encode(data, table)) ist die Zahl der Bits.
table.sort_by { |byte, code| code.length }.first(5).each { |byte, code| p [byte.chr, code] } gibt die fünf Bytes mit den kürzesten Codes aus. Welche sind es, und überrascht dich das erste? Mit last(5) statt first(5) siehst du die längsten: Wie oft kommen diese Bytes wohl im Text vor?
for byte, code in sorted(table.items(), key=lambda item: len(item[1]))[:5]: print(repr(chr(byte)), code) gibt die fünf Bytes mit den kürzesten Codes aus. Welche sind es, und überrascht dich das erste? Mit [-5:] statt [:5] siehst du die längsten: Wie oft kommen diese Bytes wohl im Text vor?
spec-gif89a.txt |
Bytes |
|---|---|
| Original | 83.003 |
| Huffman | dein Ergebnis |
| LZW, mit wachsender Breite der Codes | 28.813 |
gzip -9 |
20.271 |
Huffman sieht jedes Byte einzeln an: Es weiß, dass »e« häufig ist, aber nicht, dass nach »sc« fast immer ein »h« kommt. LZW findet genau solche Folgen und schlägt Huffman bei diesem Text deutlich. Am besten ist, beides zu verbinden: gzip sucht erst Wiederholungen, mit LZ77, einem Verwandten von LZW, und codiert das Ergebnis dann mit Huffman. JPEG macht es ähnlich: Erst werden die Zahlen eines Bildes so umgerechnet, dass viele Nullen entstehen, dann codiert Huffman, was übrig bleibt.
Codiere auch 44-baseline.jpg mit deinem Huffman. Er spart dort nur
gut 50 von 143.206 Bytes. Warum?
Wer decodieren will, braucht die Codes. Anders als bei LZW lassen sie sich nicht beim Lesen erraten; die Tabelle muss mit in die Datei. Den ganzen Baum zu speichern, wäre aufwendig. Es geht mit viel weniger: Es genügt, für jedes Byte die Länge seines Codes zu speichern, wenn beide Seiten die Codes nach derselben festen Regel daraus berechnen. Solche Codes heißen kanonisch:
Aus den Längen A: 2, B: 2, C: 2, D: 3, E: 3 werden so die Codes A = 00, B = 01, C = 10, D = 110 (10 + 1 = 11, mit einer Null dahinter), E = 111. Die Längen sind dieselben wie vorher, also braucht der Text genauso viele Bits, nur die Codes selbst haben sich geändert.
Genau so speichert JPEG seine Huffman-Tabellen im DHT-Segment, in zwei Arrays mit den Namen aus der JPEG-Norm: bits mit 16 Zahlen, wie viele Codes es mit 1, 2, … 16 Bits gibt, und huffval mit den Symbolen in der Reihenfolge von Schritt 1. Für das Beispiel oben:
bits    = [0, 3, 2, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0]
huffval = [A, B, C, D, E]
Keine Codes mit einem Bit, drei mit zwei Bits (A, B, C), zwei mit drei Bits (D, E). Daraus berechnet der Decoder die Codes, mit derselben Regel. Ein Code darf bei JPEG höchstens 16 Bits haben; ein Encoder, dessen Baum tiefer wird, muss ihn so umbauen, dass kein Code länger ist.
Schreib canonical(lengths): Es bekommt einen Hash mit der Länge jedes Bytes und gibt einen Hash mit den kanonischen Codes zurück, als Strings aus 0 und 1. code.to_s(2) schreibt eine Zahl als Binärzahl, rjust(length, '0') füllt vorn mit Nullen auf, und << schiebt eine Zahl nach links, hängt also hinten Nullen an: 0b10 << 1 ist 0b100.
Schreib canonical(lengths): Es bekommt ein dict mit der Länge jedes Bytes und gibt ein dict mit den kanonischen Codes zurück, als Strings aus 0 und 1. format(code, 'b') schreibt eine Zahl als Binärzahl, rjust(length, '0') füllt vorn mit Nullen auf, und << schiebt eine Zahl nach links, hängt also hinten Nullen an: 0b10 << 1 ist 0b100. sorted(lengths.items(), key=lambda item: (item[1], item[0])) sortiert nach Länge und dann nach Byte.
Schreib canonical(lengths). Es bekommt einen Hash mit der Länge des
Codes für jedes Byte und gibt die kanonischen Codes zurück.
Rechne das erste Beispiel von Hand: A hat die Länge 1, B und C die
Länge 2. A bekommt 0. Welcher Code mit zwei Stellen ist der kleinste,
der nicht mit 0 anfängt? Und der nächste danach?
Sortiere die Bytes nach der Länge, bei gleicher Länge nach dem Byte.
Der Code ist eine Zahl: Der erste ist 0, jeder nächste ist der vorige
plus 1. Wird die Länge größer, kommen hinten Nullen dazu, eine für
jede Stelle mehr; das ist <<. Als Bits geschrieben, mit führenden
Nullen bis zur Länge, ist die Zahl der Code.
Ein Gerüst:
def canonical(lengths)
    table = {}
    code = 0
    previous = 0
    lengths.sort_by { |byte, length| [length, byte] }.each do |byte, length|
        # hier: hinten Nullen anhängen, wenn length größer als previous ist
        table[byte] = code.to_s(2).rjust(length, '0')
        # hier: der nächste Code, und previous merken
    end
    table
end
Schreib canonical(lengths). Es bekommt einen Hash mit der Länge des
Codes für jedes Byte und gibt die kanonischen Codes zurück.
Rechne das erste Beispiel von Hand: A hat die Länge 1, B und C die
Länge 2. A bekommt 0. Welcher Code mit zwei Stellen ist der kleinste,
der nicht mit 0 anfängt? Und der nächste danach?
Sortiere die Bytes nach der Länge, bei gleicher Länge nach dem Byte.
Der Code ist eine Zahl: Der erste ist 0, jeder nächste ist der vorige
plus 1. Wird die Länge größer, kommen hinten Nullen dazu, eine für
jede Stelle mehr; das ist <<. Als Bits geschrieben, mit führenden
Nullen bis zur Länge, ist die Zahl der Code.
Ein Gerüst:
def canonical(lengths):
    table = {}
    code = 0
    previous = 0
    for byte, length in sorted(lengths.items(), key=lambda item: (item[1], item[0])):
        # hier: hinten Nullen anhängen, wenn length größer als previous ist
        table[byte] = format(code, 'b').rjust(length, '0')
        # hier: der nächste Code, und previous merken
    return table
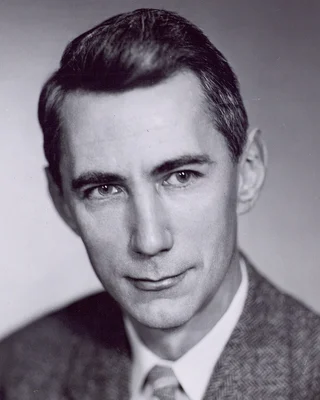
Claude Shannon (1916–2001). Wie viele Bits eine Nachricht mindestens braucht, rechnete er 1948 aus und gründete damit die Informationstheorie; das Wort Bit machte er bekannt. Er fuhr Einrad, jonglierte und baute die Maus Theseus, die selbst lernte, durch ein Labyrinth zu finden.
Schon als Student am MIT zeigte er 1937 in seiner Masterarbeit, dass sich Schaltungen aus Relais mit der Algebra von George Boole beschreiben und vereinfachen lassen, mit 1 und 0 für einen Kontakt, der geschlossen oder offen ist. Damit begann die Theorie der digitalen Schaltungen.
Einen Code mit so wenigen Bits wie möglich suchten er und Robert Fano fast gleichzeitig, jeder für sich. Der Shannon-Fano-Code kam nah heran, aber nicht immer ganz.
In derselben Arbeit von 1948 ließ er englische Texte Wort für Wort entstehen, jedes Wort nach dem vorigen aus einem Buch gezogen: ein winziges Sprachmodell, von Hand.
1949 bewies er einen Satz, den Nachrichtentechniker schon kannten: Schwingt ein Signal höchstens W-mal in der Sekunde, ist es ganz festgehalten, wenn man es 2W-mal in der Sekunde misst. Nach diesem Abtasttheorem richtet sich, wie oft ein Computer Ton misst.
Foto: Tekniska museet, CC BY 2.0, zugeschnitten (Wikimedia Commons)
encode so um, dass es echte Bytes liefert, mit [bits].pack('B*'), und decode passend dazu. Wie erkennt decode, wo die Bits zu Ende sind, wenn das letzte Byte nicht voll ist?encode so um, dass es echte Bytes liefert, mit int(bits[i:i + 8].ljust(8, '0'), 2) für je 8 Bits, und decode passend dazu. Wie erkennt decode, wo die Bits zu Ende sind, wenn das letzte Byte nicht voll ist?