powered by 
Was in jeder Datei und jedem Speicher steckt, zum Nachschlagen: Zahlen binär und hexadezimal, wie viel in ein Byte passt, wie man einen Hexdump liest, Text als Bytes, Zahlen aus mehreren Bytes, negative Zahlen und die Operationen auf einzelnen Bits, in C, Python, Ruby und JavaScript. Gebraucht wird das in Dateien und Verzeichnisse, GIF, JPEG, Geheime Botschaften in Bildern, Einmalcodes und Vom Byte zum 3D-Labyrinth.
Eine Zahl ist dieselbe, egal wie man sie aufschreibt. Binär hat jede Stelle den doppelten Wert der Stelle rechts von ihr (1, 2, 4, 8, 16 …), hexadezimal den 16-fachen, mit den Ziffern 0–9 und a–f für 10 bis 15:
$$101010_2 = 32 + 8 + 2 = 42$$
$$2a_{16} = 2 \cdot 16 + 10 = 42$$
| dezimal | binär | hex |
|---|---|---|
| 0 | 0000 |
0 |
| 1 | 0001 |
1 |
| 2 | 0010 |
2 |
| 3 | 0011 |
3 |
| 4 | 0100 |
4 |
| 5 | 0101 |
5 |
| 6 | 0110 |
6 |
| 7 | 0111 |
7 |
| 8 | 1000 |
8 |
| 9 | 1001 |
9 |
| 10 | 1010 |
a |
| 11 | 1011 |
b |
| 12 | 1100 |
c |
| 13 | 1101 |
d |
| 14 | 1110 |
e |
| 15 | 1111 |
f |
Eine Hex-Ziffer steht für genau vier Bits. Deshalb geht das Umrechnen zwischen binär und hexadezimal ohne Rechnen, Ziffer für Ziffer: 0010 1010 ist 2a, 1111 0000 ist f0. Ein Byte sind immer zwei Hex-Ziffern, von 00 bis ff.
| C | Python | Ruby | JavaScript | |
|---|---|---|---|---|
| im Code |
0x2a; binär erst ab C23 |
0x2a, 0b101010, mit Unterstrich 0b0010_1010
|
0x2a, 0b101010, 0b0010_1010
|
0x2a, 0b101010, 0b0010_1010
|
| als Text binär | – |
format(42, '08b') → '00101010'
|
42.to_s(2), '%08b' % 42
|
(42).toString(2) |
| als Text hex | printf("%02x", 42) |
format(42, '02x'), hex(42) → '0x2a'
|
42.to_s(16), '%02x' % 42
|
(42).toString(16) |
| aus Text | strtol("2a", NULL, 16) |
int('2a', 16), int('101010', 2)
|
'2a'.to_i(16), '101010'.to_i(2)
|
parseInt('2a', 16) |
Mit 08b oder rjust(8, '0') füllst du vorn mit Nullen auf, damit ein Byte immer acht Stellen hat.
Ein Bit ist 0 oder 1, ein Byte sind 8 Bits. Mit \(n\) Bits gibt es \(2^n\) verschiedene Werte:
| Bits | Werte | ohne Vorzeichen | mit Vorzeichen |
|---|---|---|---|
| 4 | 16 | 0 bis 15 | −8 bis 7 |
| 8 (ein Byte) | 256 | 0 bis 255 | −128 bis 127 |
| 16 | 65 536 | 0 bis 65 535 | −32 768 bis 32 767 |
| 32 | etwa 4,3 Milliarden | 0 bis 4 294 967 295 | etwa ±2,1 Milliarden |
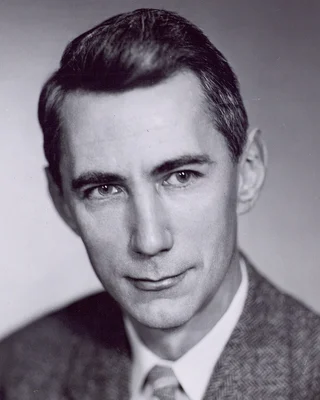
Claude Shannon (1916–2001). Wie viele Bits eine Nachricht mindestens braucht, rechnete er 1948 aus und gründete damit die Informationstheorie; das Wort Bit machte er bekannt. Er fuhr Einrad, jonglierte und baute die Maus Theseus, die selbst lernte, durch ein Labyrinth zu finden.
Einen Code mit so wenigen Bits wie möglich suchten er und Robert Fano fast gleichzeitig, jeder für sich. Der Shannon-Fano-Code kam nah heran, aber nicht immer ganz.
Foto: Tekniska museet, CC BY 2.0, zugeschnitten (Wikimedia Commons)
Wie viele Bits braucht man für eine Zahl \(x\)? So viele, dass \(2^n > x\) ist: für 100 sieben, denn \(2^7 = 128\).
Bei Dateigrößen ist kB eigentlich 1000 Bytes und KiB 1024 (\(2^{10}\)), ebenso MB und MiB (\(2^{20}\) = 1 048 576). ls -lh und du -h rechnen mit 1024, schreiben aber nur K und M.
hd (»hexdump«) und xxd zeigen die Bytes einer Datei. Eine Datei mit dem Text Grüße, Welt! und einem Zeilenende:
hd gruss.txt
00000000  47 72 c3 bc c3 9f 65 2c  20 57 65 6c 74 21 0a     |Gr....e, Welt!.|
0000000f
0f = 15 Bytes.0x0a ist also das dritte nach der Lücke, hier 65.ü und ß sind je zwei solche Bytes.| Befehl | Was er zeigt |
|---|---|
hd datei | less |
die ganze Datei, seitenweise |
hd -n 64 datei |
nur die ersten 64 Bytes |
hd -s 0x0a -n 16 datei |
16 Bytes ab Offset 10 |
xxd datei | head |
dasselbe in der Form von xxd: 00000000: 4772 c3bc …, je zwei Bytes zusammen, die Zeichen ohne Striche |
xxd -b -l 4 datei |
die ersten 4 Bytes binär |
Ein Hexdump interpretiert nichts: Ob zwei Bytes eine Zahl, zwei Zeichen oder ein Stück Bild sind, weiß nur, wer das Format der Datei kennt.
In ASCII hat jedes Zeichen eine Nummer von 0 bis 127, ein Byte:
| Zeichen | hex | dezimal | |
|---|---|---|---|
Zeilenende (LF, \n) |
0a |
10 | Tab (\t) ist 09
|
| Leerzeichen | 20 |
32 | |
0 bis 9
|
30 bis 39
|
48 bis 57 | die Ziffer ist das Byte minus 48 |
A bis Z
|
41 bis 5a
|
65 bis 90 | |
a bis z
|
61 bis 7a
|
97 bis 122 | 32 (0x20) mehr als der Großbuchstabe |
Alles andere, Umlaute, €, Emojis, schreibt UTF-8 mit zwei bis vier Bytes, die alle größer als 127 sind: ä ist c3 a4, ß ist c3 9f, € ist e2 82 ac. Ein Text aus reinem ASCII ist deshalb auch gültiges UTF-8. Zeichen und Bytes zu zählen, gibt verschiedene Ergebnisse:
| Zeichen | Bytes | |
|---|---|---|
| Python |
len('Grüße') → 5, ord('A') → 65 |
'Grüße'.encode() → b'Gr\xc3\xbc\xc3\x9fe', 7 Bytes; zurück mit .decode()
|
| Ruby |
'Grüße'.length → 5, 'A'.ord → 65 |
'Grüße'.bytes → [71, 114, 195, 188, 195, 159, 101], bytesize → 7 |
| Terminal | wc -m datei |
wc -c datei |
Wer Bytes als Text liest, muss wissen, wie sie kodiert sind. Steht statt Grüße plötzlich Grüße da, wurden UTF-8-Bytes einzeln als Zeichen gelesen.
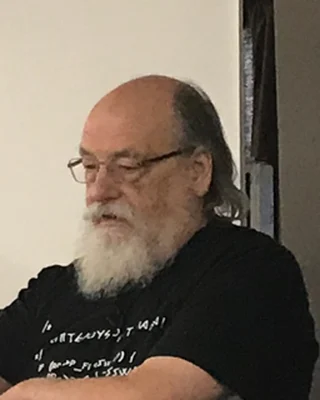
Ken Thompson (geboren 1943). Du suchst im Terminal mit grep? Das hat er 1973 geschrieben; der Name kommt aus seinem Texteditor, wo der Befehl g/re/p hieß: global, regular expression, print. Wie man aus einem regulären Ausdruck einen Automaten baut, hatte er schon 1968 beschrieben: die Thompson-Konstruktion.
Das Terminal selbst läuft unter Linux, und Linux funktioniert wie Unix, das er ab 1969 mit Dennis Ritchie schrieb. Unten rechts in VS Code steht UTF-8: Die Kodierung hat er 1992 mit Rob Pike auf ein Tischset in einem Diner gezeichnet. Und die Sprache Go hat er mit erfunden.
Foto: A. C. Diller, 2019, CC BY-SA 4.0, zugeschnitten (Wikimedia Commons)
Eine Zahl, die nicht in ein Byte passt, steht in mehreren, und jedes Format legt fest, in welcher Reihenfolge. 0x1234 = 4660 in zwei Bytes:
| Reihenfolge | im Hexdump | wo |
|---|---|---|
| Little Endian: das niedrige Byte zuerst | 34 12 |
GIF, BMP, WAV, der Speicher von PCs (x86, ARM) |
| Big Endian: das hohe Byte zuerst | 12 34 |
JPEG, PNG, Zahlen in Netzwerkprotokollen |
| zwei Bytes lesen | eine Zahl als Bytes | |
|---|---|---|
| C |
low | (high << 8), (high << 8) | low
|
x & 0xff, (x >> 8) & 0xff
|
| Python |
int.from_bytes(data[i:i + 2], 'little'), 'big'
|
x.to_bytes(2, 'little'), 'big'
|
| Ruby |
data.byteslice(i, 2).unpack1('v'), 'n' für Big Endian |
[x].pack('v'), [x].pack('n')
|
Bei Ruby lesen v und V (nach dem alten Rechner VAX) Little Endian, n und N (wie network) Big Endian; die kleinen Buchstaben 16 Bit, die großen 32 Bit. Liest du eine Zahl in der falschen Reihenfolge, wird sie fast immer viel zu groß: 34 12 als Big Endian ist 13 330 statt 4660.
Im Zweierkomplement zählt das oberste Bit negativ: Bei einem Byte ist es −128 statt +128. Dieselben acht Bits bedeuten so je nachdem, ob sie mit oder ohne Vorzeichen gelesen werden, etwas anderes:
| Bits | hex | ohne Vorzeichen | mit Vorzeichen |
|---|---|---|---|
0111 1111 |
7f |
127 | 127 |
1000 0000 |
80 |
128 | −128 |
1111 1011 |
fb |
251 | −5 |
1111 1111 |
ff |
255 | −1 |
Eine Zahl negieren: alle Bits umdrehen und 1 addieren. Aus 5 = 0000 0101 wird 1111 1010, plus 1 1111 1011. Dass dabei −5 herauskommt, sieht man an 251 = 256 − 5: Mit 8 Bits ist −x dasselbe Muster wie 256 − x. Das ist der Grund für dieses Verfahren: Addieren und Subtrahieren funktionieren für beide Lesarten mit denselben Schaltungen.
Wird ein Ergebnis zu groß, läuft es über: Was nicht mehr in die Bits passt, fällt weg. Ein Byte ohne Vorzeichen geht von 255 plus 1 auf 0, eins mit Vorzeichen von 127 plus 1 auf −128.
| Was gilt | |
|---|---|
| C | feste Größen: uint8_t von 0 bis 255 läuft über (255 + 1 ergibt 0), (int8_t) 200 ist −56; bei int ist ein Überlauf nicht erlaubt, das Programm darf dann alles tun |
| Python, Ruby | ganze Zahlen werden einfach größer und laufen nie über; ein Byte daraus macht x & 0xff (−5 wird 251), zurück int.from_bytes(b, 'big', signed=True) oder in Ruby [b].pack('C').unpack1('c')
|
| JavaScript | die Bit-Operationen rechnen mit 32 Bit und Vorzeichen: 1 << 31 ist −2 147 483 648; x >>> 0 liest dieselben Bits ohne Vorzeichen |
Die Operationen arbeiten auf jedem Bit für sich und heißen in C, Python, Ruby und JavaScript gleich. Mit a = 1100 und b = 1010:
| Operation | Ergebnis | ein Bit ist 1, wenn … |
|---|---|---|
a & b (UND) |
1000 |
es in beiden 1 ist |
a | b (ODER) |
1110 |
es in mindestens einem 1 ist |
a ^ b (XOR, exklusives ODER) |
0110 |
es in genau einem 1 ist; zweimal dasselbe ^ b ergibt wieder a
|
~a (NICHT) |
…0011 |
es in a 0 ist; alle Bits davor werden auch 1, siehe unten |
a << 1 |
11000 |
schiebt nach links, hinten kommen Nullen dazu: mal 2 |
a >> 2 |
0011 |
schiebt nach rechts, die untersten Bits fallen weg: durch 4, ohne Rest |
Die Bits zählt man von rechts, beim untersten mit 0: Bit \(k\) hat den Wert \(2^k\), und 1 << k ist eine Zahl, in der nur dieses Bit gesetzt ist. Eine solche Zahl heißt Maske:
| Was | Wie |
|---|---|
Bit k lesen (0 oder 1) |
(x >> k) & 1 |
Bit k setzen, löschen, umdrehen |
x | (1 << k), x & ~(1 << k), x ^ (1 << k)
|
die untersten n Bits |
x & ((1 << n) - 1), für vier Bits x & 0x0f
|
| die obere Hälfte eines Bytes | x >> 4 |
Rot, Grün, Blau aus 0xRRGGBB
|
(c >> 16) & 0xff, (c >> 8) & 0xff, c & 0xff
|
| und wieder zusammen | (r << 16) | (g << 8) | b |
Zwei Stellen, an denen die Sprachen sich unterscheiden:
~ dreht in Python und Ruby unendlich viele Bits um, das Ergebnis ist negativ: ~5 ist −6. Für ein Byte schreib ~x & 0xff (250).& schwächer als ==: x & 1 == 0 heißt dort x & (1 == 0) und ist immer 0. In Python und Ruby ist es (x & 1) == 0. Schieben bindet überall schwächer als +: 1 << n + 1 ist 1 << (n + 1). Klammern schaden nie.int.to_bytes und int.from_bytes weiter unten auf derselben Seite, auf Englisch.pack und unpack, auf Englisch.