powered by 
Sechsmal Weiß, dreimal Schwarz, viermal Weiß: Statt jedes Pixel einzeln aufzuschreiben, sagt man, wie lang jeder Lauf gleicher Pixel ist. So schickten Faxgeräte ihre Seiten durch die Telefonleitung, so speicherten frühe Bildformate ihre Bilder, und so packt JPEG die vielen Nullen eines Fotos zusammen. Du schreibst es selbst, in Ruby oder Python, und findest heraus, welche Dateien damit kleiner werden, und welche doppelt so groß.
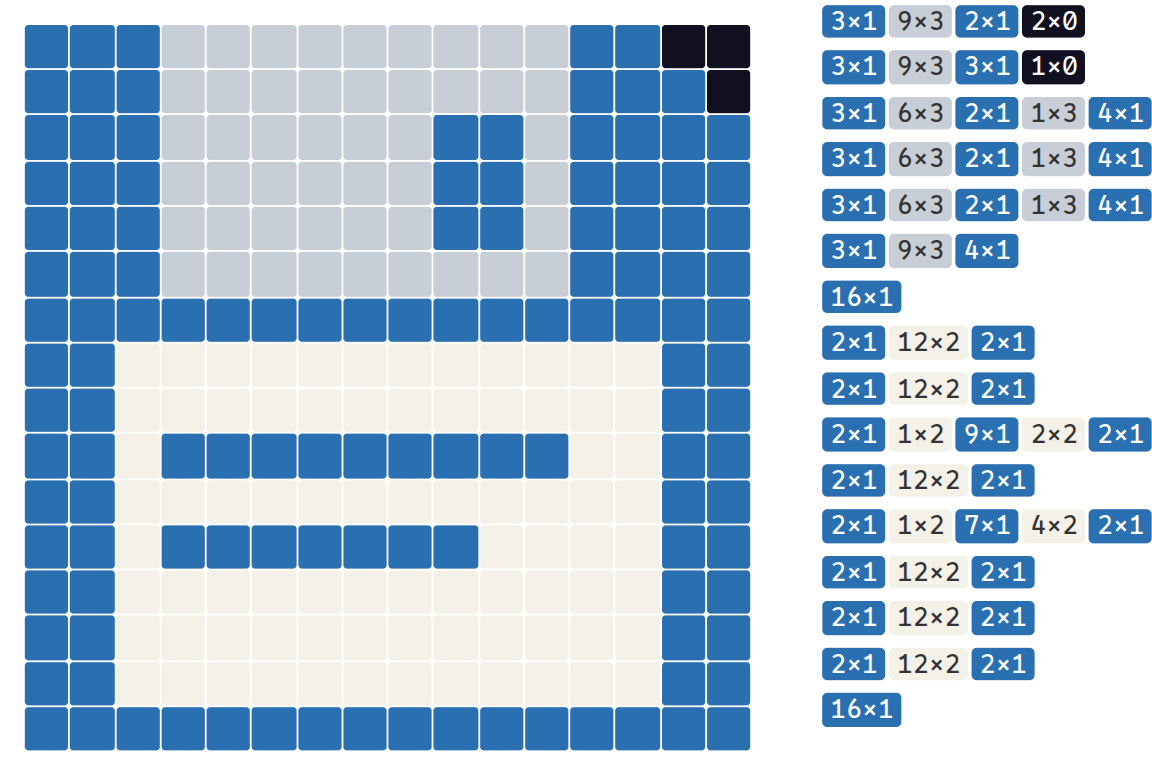
Eine Zeile eines Bildes aus wenigen Farben besteht meist aus langen Stücken derselben Farbe: links Hintergrund, dann ein Rand, dann eine Fläche. So ein Stück heißt Lauf, und statt »Weiß, Weiß, Weiß, Weiß, Weiß, Weiß« genügt »6 × Weiß«. Diese Lauflängencodierung (englisch Run-Length Encoding, RLE) ist das einfachste Verfahren zum Komprimieren, und sie ist verlustfrei: Aus den Läufen kommt genau die Zeile zurück.
Hier ist die Diskette aus dem GIF-Labor, 16 × 16 Pixel in 4 Farben. Neben jeder Zeile stehen ihre Läufe. Wähl eine Farbe und klick in das Bild, oder zieh mit gedrückter Maustaste: Die Läufe und die Größe ändern sich mit.
Jeder Lauf braucht zwei Bytes, eins für die Länge und eins für die Farbe. Mal etwas anderes hinein, etwa ein Schachbrett oder breite Streifen, und achte darauf, wie viele Läufe eine Zeile hat und wie sich die Größe unter dem Bild ändert.
Wie sieht AAAABBBCCD als Lauflängen aus, mit der Zahl vor jedem
Zeichen?
Das Bild im Editor hat 256 Pixel, also 256 Bytes. Wann braucht es mit Lauflängen weniger?
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
Die Diskette hat lange, ruhige Zeilen und wird viel kleiner. Ein Schachbrett wird größer als das Bild selbst: Jedes Pixel ist dann ein eigener Lauf und braucht zwei Bytes statt einem. Kleiner wird ein Bild also nur, wenn seine Läufe im Mittel länger als zwei Pixel sind, denn jeder Lauf kostet zwei Bytes.
Lege im Terminal (StrgJ) einen Ordner an und öffne ihn mit StrgK StrgO:
mkdir /workspace/rle
Lege darin die Datei rle.rb an:
# Lauflängen: statt »AAAA« steht »4A« da.

# Als Text: 'WWWWWWBBBWWWW' wird '6W3B4W'
def rle(text)
end

def unrle(code)
end

# Als Bytes: immer zwei Zahlen, die Länge (1 bis 255) und das Byte
def rle_bytes(data)
end

def unrle_bytes(bytes)
end

puts rle('WWWWWWBBBWWWW')
Lege darin die Datei rle.py an:
# Lauflängen: statt »AAAA« steht »4A« da.


def rle(text):
    """Als Text: 'WWWWWWBBBWWWW' wird '6W3B4W'"""
    return ''


def unrle(code):
    return ''


def rle_bytes(data):
    """Als Bytes: immer zwei Zahlen, die Länge (1 bis 255) und das Byte"""
    return []


def unrle_bytes(numbers):
    return b''


print(rle('WWWWWWBBBWWWW'))
Schreib rle. Es geht den Text Zeichen für Zeichen durch, zählt, wie oft dasselbe Zeichen hintereinander kommt, und schreibt für jeden Lauf die Zahl und das Zeichen hin.
text.each_char { |char| … } geht die Zeichen durch."#{count}#{char}" an das Ergebnis und beginne einen neuen Lauf.for char in text: geht die Zeichen durch.f'{count}{char}' an das Ergebnis und beginne einen neuen Lauf.Schreib rle in rle.rb.
Geh WWWBBW Zeichen für Zeichen durch und schreib nach jedem auf, was dein
Programm weiß: welches Zeichen der Lauf hat und wie lang er bisher ist. Wann
ist ein Lauf zu Ende, und was kommt dann ins Ergebnis? Was passiert mit dem
letzten Lauf, nach dem kein anderes Zeichen mehr kommt?
Merk dir das Zeichen des aktuellen Laufs und zähle. Kommt ein anderes
Zeichen, hängst du "#{count}#{char}" an und beginnst neu. Nach der Schleife
fehlt noch der letzte Lauf, aber nur, wenn es überhaupt einen gab.
Ein Gerüst:
def rle(text)
    result = ''
    char = nil
    count = 0
    text.each_char do |c|
        if c == char
            … # der Lauf wird länger
        else
            … # den Lauf davor anhängen, wenn es einen gab
            char = c
            count = 1
        end
    end
    … # der letzte Lauf
    result
end
Schreib rle in rle.py.
Geh WWWBBW Zeichen für Zeichen durch und schreib nach jedem auf, was dein
Programm weiß: welches Zeichen der Lauf hat und wie lang er bisher ist. Wann
ist ein Lauf zu Ende, und was kommt dann ins Ergebnis? Was passiert mit dem
letzten Lauf, nach dem kein anderes Zeichen mehr kommt?
Merk dir das Zeichen des aktuellen Laufs und zähle. Kommt ein anderes
Zeichen, hängst du f'{count}{char}' an und beginnst neu. Nach der Schleife
fehlt noch der letzte Lauf, aber nur, wenn es überhaupt einen gab.
Ein Gerüst:
def rle(text):
    result = ''
    char = None
    count = 0
    for c in text:
        if c == char:
            ...  # der Lauf wird länger
        else:
            ...  # den Lauf davor anhängen, wenn es einen gab
            char = c
            count = 1
    ...  # der letzte Lauf
    return result
Dann unrle, andersherum: aus '6W3B4W' wieder 'WWWWWWBBBWWWW'. Eine Zahl kann mehrere Ziffern haben, '12A' sind zwölf A.
code.scan(/(\d+)(\D)/) findet jede Zahl mit dem Zeichen dahinter, als Paare von Strings, etwa [['6', 'W'], ['3', 'B'], ['4', 'W']].'W' * 6 ist 'WWWWWW', und to_i macht aus '6' eine Zahl.import re findet re.findall(r'(\d+)(\D)', code) jede Zahl mit dem Zeichen dahinter, als Paare von Strings, etwa [('6', 'W'), ('3', 'B'), ('4', 'W')].'W' * 6 ist 'WWWWWW', int('6') macht aus '6' eine Zahl, und ''.join(parts) hängt eine Liste von Strings aneinander.Schreib unrle.
Zerleg 12A3B von Hand in Paare aus Länge und Zeichen. Woran erkennst du, wo
eine Länge aufhört? Warum reicht es nicht, immer genau eine Ziffer zu lesen?
code.scan(/(\d+)(\D)/) liefert Paare wie ['6', 'W']: so viele Ziffern
wie möglich, dann ein Zeichen, das keine Ziffer ist. 'W' * 6 ist
'WWWWWW', '6'.to_i ist 6, und join hängt alles aneinander.
Schreib unrle.
Zerleg 12A3B von Hand in Paare aus Länge und Zeichen. Woran erkennst du, wo
eine Länge aufhört? Warum reicht es nicht, immer genau eine Ziffer zu lesen?
re.findall(r'(\d+)(\D)', code) liefert Paare wie ('6', 'W'): so viele
Ziffern wie möglich, dann ein Zeichen, das keine Ziffer ist. 'W' * 6 ist
'WWWWWW', int('6') ist 6, und ''.join(...) hängt alles aneinander. Für
re brauchst du oben import re.
rle('2021') ergibt '12101211'. Was macht unrle daraus?
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
Als Text geht es nur, solange der Text selbst keine Ziffern enthält: Sonst weiß niemand, welche Ziffern Längen sind und welche zum Text gehören. Echte Programme schreiben deshalb immer genau zwei Bytes für jeden Lauf, eins mit der Länge und eins mit dem Byte, das sich wiederholt. Dann ist klar, was was ist, egal was in der Datei steht. Weil ein Byte höchstens 255 sein kann, wird ein längerer Lauf geteilt: 300-mal A sind [255, 65, 45, 65].
Schreib rle_bytes, das ein Array von Zahlen zurückgibt, und unrle_bytes, das daraus wieder den String macht.
data.each_byte liefert die Bytes als Zahlen.bytes.each_slice(2) { |count, byte| … } geht das Array paarweise durch.[65] * 3 ist [65, 65, 65], und [65, 65, 65].pack('C*') macht daraus den String 'AAA'.Schreib rle_bytes, das eine Liste von Zahlen zurückgibt, und unrle_bytes, das daraus wieder Bytes macht.
b'AAAB' sind Bytes, keine Zeichen, und for byte in data: liefert sie als Zahlen: 65, 65, 65, 66.zip(numbers[0::2], numbers[1::2]) geht eine Liste paarweise durch: die Zahlen an geraden und an ungeraden Indizes.[65] * 3 ist [65, 65, 65], und bytes([65, 65, 65]) macht daraus b'AAA'.Schreib rle_bytes und unrle_bytes. Ein Lauf ist immer zwei Zahlen,
die Länge von 1 bis 255 und das Byte; längere Läufe werden geteilt.
Was soll rle_bytes('A' * 300) ergeben? Warum passt 300 nicht als Länge, und
wie teilst du den Lauf auf? Und welche Paare stecken in
unrle_bytes([3, 65, 1, 66])?
Wie bei rle, nur mit Zahlen statt Text: data.each_byte liefert die
Bytes. Ein neuer Lauf beginnt, wenn ein anderes Byte kommt oder der Lauf schon
255 lang ist. Zurück geht es mit bytes.each_slice(2) { |count, byte| … },
[byte] * count wiederholt ein Byte, und pack('C*') macht aus den Zahlen
wieder einen String.
Ein Gerüst für rle_bytes; die Bedingung schreibst du:
def rle_bytes(data)
    result = []
    data.each_byte do |byte|
        if … # dasselbe Byte wie im Lauf davor, und der Lauf ist kürzer als 255
            result[-2] += 1
        else
            result.push(1, byte)
        end
    end
    result
end
result[-2] ist die Länge des letzten Laufs, result[-1] sein Byte.
Schreib rle_bytes und unrle_bytes. Ein Lauf ist immer zwei Zahlen,
die Länge von 1 bis 255 und das Byte; längere Läufe werden geteilt.
Was soll rle_bytes(b'A' * 300) ergeben? Warum passt 300 nicht als Länge, und
wie teilst du den Lauf auf? Und welche Paare stecken in
unrle_bytes([3, 65, 1, 66])?
Wie bei rle, nur mit Zahlen statt Text: for byte in data liefert die
Bytes. Ein neuer Lauf beginnt, wenn ein anderes Byte kommt oder der Lauf schon
255 lang ist. Zurück geht es paarweise mit
zip(numbers[0::2], numbers[1::2]), [byte] * count wiederholt ein Byte, und
bytes(...) macht aus den Zahlen wieder Bytes.
Ein Gerüst für rle_bytes; die Bedingung schreibst du:
def rle_bytes(data):
    result = []
    for byte in data:
        if ...:  # dasselbe Byte wie im Lauf davor, und der Lauf ist kürzer als 255
            result[-2] += 1
        else:
            result += [1, byte]
    return result
result[-2] ist die Länge des letzten Laufs, result[-1] sein Byte.
Lade drei Dateien zum Ausprobieren in den Ordner: die Diskette, achtfach vergrößert, als rohe Pixel (128 × 128 Bytes, jedes die Nummer einer Farbe), die Spezifikation von GIF als Text, und ein Foto als JPEG.
wget https://workspace.hackschule.de/rle/diskette.raw
wget https://workspace.hackschule.de/lzw/spec-gif89a.txt
wget https://workspace.hackschule.de/jpeg/44-baseline.jpg
File.binread('diskette.raw') liest eine Datei Byte für Byte.
open('diskette.raw', 'rb').read() liest eine Datei als Bytes; das b in 'rb' ist wichtig, sonst bekommst du Text.
Lass dein Programm für jede ausgeben, wie groß sie ist und wie viele Zahlen rle_bytes daraus macht, und prüf dabei, ob unrle_bytes wieder genau die Datei ergibt.
Wie viele Zahlen macht rle_bytes aus diskette.raw mit seinen 16.384
Bytes?
rle_bytes(File.binread('diskette.raw')).size
Wie viele Zahlen macht rle_bytes aus diskette.raw mit seinen 16.384
Bytes?
len(rle_bytes(open('diskette.raw', 'rb').read()))
Was passiert mit spec-gif89a.txt (83.003 Bytes), wenn du rle_bytes
darauf anwendest? Rate erst, dann probier es aus.
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
| Datei | Bytes | mit RLE |
|---|---|---|
diskette.raw |
16.384 | dein Ergebnis |
spec-gif89a.txt |
83.003 | 125.796 |
44-baseline.jpg |
143.206 | 284.916 |
In einem Text sind Läufe selten: Außer Leerzeichen und Linien aus - und = kommt kaum ein Zeichen zweimal hintereinander, und jedes einzelne kostet jetzt zwei Bytes. Im JPEG ist fast jedes Byte ein Lauf der Länge 1.
rle_bytes ein zweites Mal an, auf das, was es aus der Diskette gemacht hat. Mit data = File.binread('diskette.raw') ist das rle_bytes(rle_bytes(data).pack('C*')).size. Wird die Diskette noch einmal kleiner? Sieh dir mit p rle_bytes(data).first(20) an, was da steht: Wie viele Läufe findest du darin?
rle_bytes ein zweites Mal an, auf das, was es aus der Diskette gemacht hat. Mit data = open('diskette.raw', 'rb').read() ist das len(rle_bytes(bytes(rle_bytes(data)))). Wird die Diskette noch einmal kleiner? Sieh dir mit print(rle_bytes(data)[:20]) an, was da steht: Wie viele Läufe findest du darin?
Ein Faxgerät tastet eine Seite Zeile für Zeile ab, jede Zeile 1728 Pixel breit, und jedes Pixel ist weiß oder schwarz. Eine Zeile Text besteht dann aus langen weißen Läufen mit kurzen schwarzen dazwischen. Das Fax schickt nur die Längen der Läufe, abwechselnd weiß und schwarz, sodass es die Farbe gar nicht mitschicken muss, und codiert diese Längen mit festen Huffman-Codes: Häufige Längen bekommen kurze Codes.
JPEG macht etwas Ähnliches mit den Nullen. Nach der Quantisierung sind die meisten der 64 Zahlen eines Blocks 0. Jedes Symbol in der AC-Tabelle sagt deshalb zweierlei: wie viele Nullen vor der nächsten Zahl stehen, also einen Lauf, und wie viele Bits diese Zahl hat. Wie das genau aussieht, steht in Eine JPEG-Datei decodieren.
packbits und unpackbits und vergleich mit rle_bytes.diskette.raw spaltenweise statt zeilenweise. Wird es kleiner oder größer? Warum?diskette.raw vorkommen, und überleg, wie viele Bits sie mit Huffman bräuchten.