powered by 
Verschlüsselung macht eine Nachricht unlesbar, aber jeder sieht, dass es sie gibt. Steganographie versteckt die Nachricht selbst: in einem Foto, das aussieht wie jedes andere. Du liest ein Bild als Liste von Zahlen, versteckst Text in den untersten Bits, findest heraus, wie man so etwas entdeckt, und baust zum Schluss ein Verfahren, das mit Farbklassen und einer Zahl mit wechselnder Basis genau so viel versteckt, wie du willst, nicht nur ganze Bits.
In Kryptographie im Terminal hast du Nachrichten verschlüsselt. Wer die verschlüsselte Datei abfängt, kann sie nicht lesen, aber er weiß, dass da etwas Geheimes ist. Manchmal ist schon das zu viel.
Steganographie (griechisch für »verdecktes Schreiben«) versteckt, dass es eine Nachricht gibt. Früher war das unsichtbare Tinte oder ein winziger Mikropunkt auf einem Brief. Heute ist es oft ein Bild: Ein Foto hat Hunderttausende Pixel, und an jedem kann man ein wenig ändern, ohne dass es jemand sieht. Die Kunst ist, genau so wenig zu ändern, dass niemand Verdacht schöpft, weder ein Mensch noch ein Programm, das danach sucht.
Beides lässt sich kombinieren: erst verschlüsseln, dann verstecken. Dann muss jemand die Nachricht erst finden und kann sie danach noch immer nicht lesen.
Lege einen Ordner an und öffne ihn mit StrgK StrgO:
mkdir /workspace/stego
Hol dir die Bilder dieser Seite: zwei Fotos und ein Fundstück, in dem schon etwas versteckt ist.
wget https://workspace.hackschule.de/steganography/fundstueck.png
wget https://workspace.hackschule.de/steganography/strandhaeuser.png
wget https://workspace.hackschule.de/steganography/moewen.png
Die Fotos der Strandhäuser und der Möwen mit freundlicher Genehmigung von Ian Kobylanski · https://koby.photography/
PNG-Dateien sind komprimiert, aber ohne Verlust: Jedes Pixel kommt genau so wieder heraus, wie es hineingesteckt wurde. Das ist wichtig, denn eine versteckte Botschaft lebt in den kleinsten Unterschieden. Ein JPEG würde sie beim Speichern zerstören. Das Lesen und Schreiben übernimmt eine Bibliothek:
gem install chunky_png
ChunkyPNG liest und schreibt PNG-Dateien in Ruby. ChunkyPNG::Image.from_file('fundstueck.png') liest ein Bild, image.save('neu.png') schreibt es.
pip install pillow
Pillow liest und schreibt Bilder in Python. Image.open('fundstueck.png') liest ein Bild, image.save('neu.png') schreibt es.
Jedes Pixel hat drei Kanäle, Rot, Grün und Blau, jeder eine Zahl von 0 bis 255. Ein Bild mit 480 × 320 Pixeln ist also nichts anderes als 480 · 320 · 3 = 460.800 Zahlen. Das Gerüst unten holt sie in eine einzige Liste, Zeile für Zeile, und macht aus so einer Liste wieder ein Bild.
Lege die Datei stego.rb an:
require 'chunky_png'

# Rot, Grün und Blau jedes Pixels, Zeile für Zeile, in einem Array:
# [r0, g0, b0, r1, g1, b1, ...]
def channels(image)
    image.pixels.flat_map { |c| [ChunkyPNG::Color.r(c), ChunkyPNG::Color.g(c), ChunkyPNG::Color.b(c)] }
end

# Das Bild zu einem solchen Array
def from_channels(width, height, values)
    ChunkyPNG::Image.new(width, height, values.each_slice(3).map { |r, g, b| ChunkyPNG::Color.rgb(r, g, b) })
end

# Ein Bild aus einem einzigen Bit jedes Kanals: 255, wo es gesetzt ist, sonst 0
def bit_plane(image, bit = 0)
end

image = ChunkyPNG::Image.from_file('fundstueck.png')
p [image.width, image.height]
p channels(image)[0, 6]
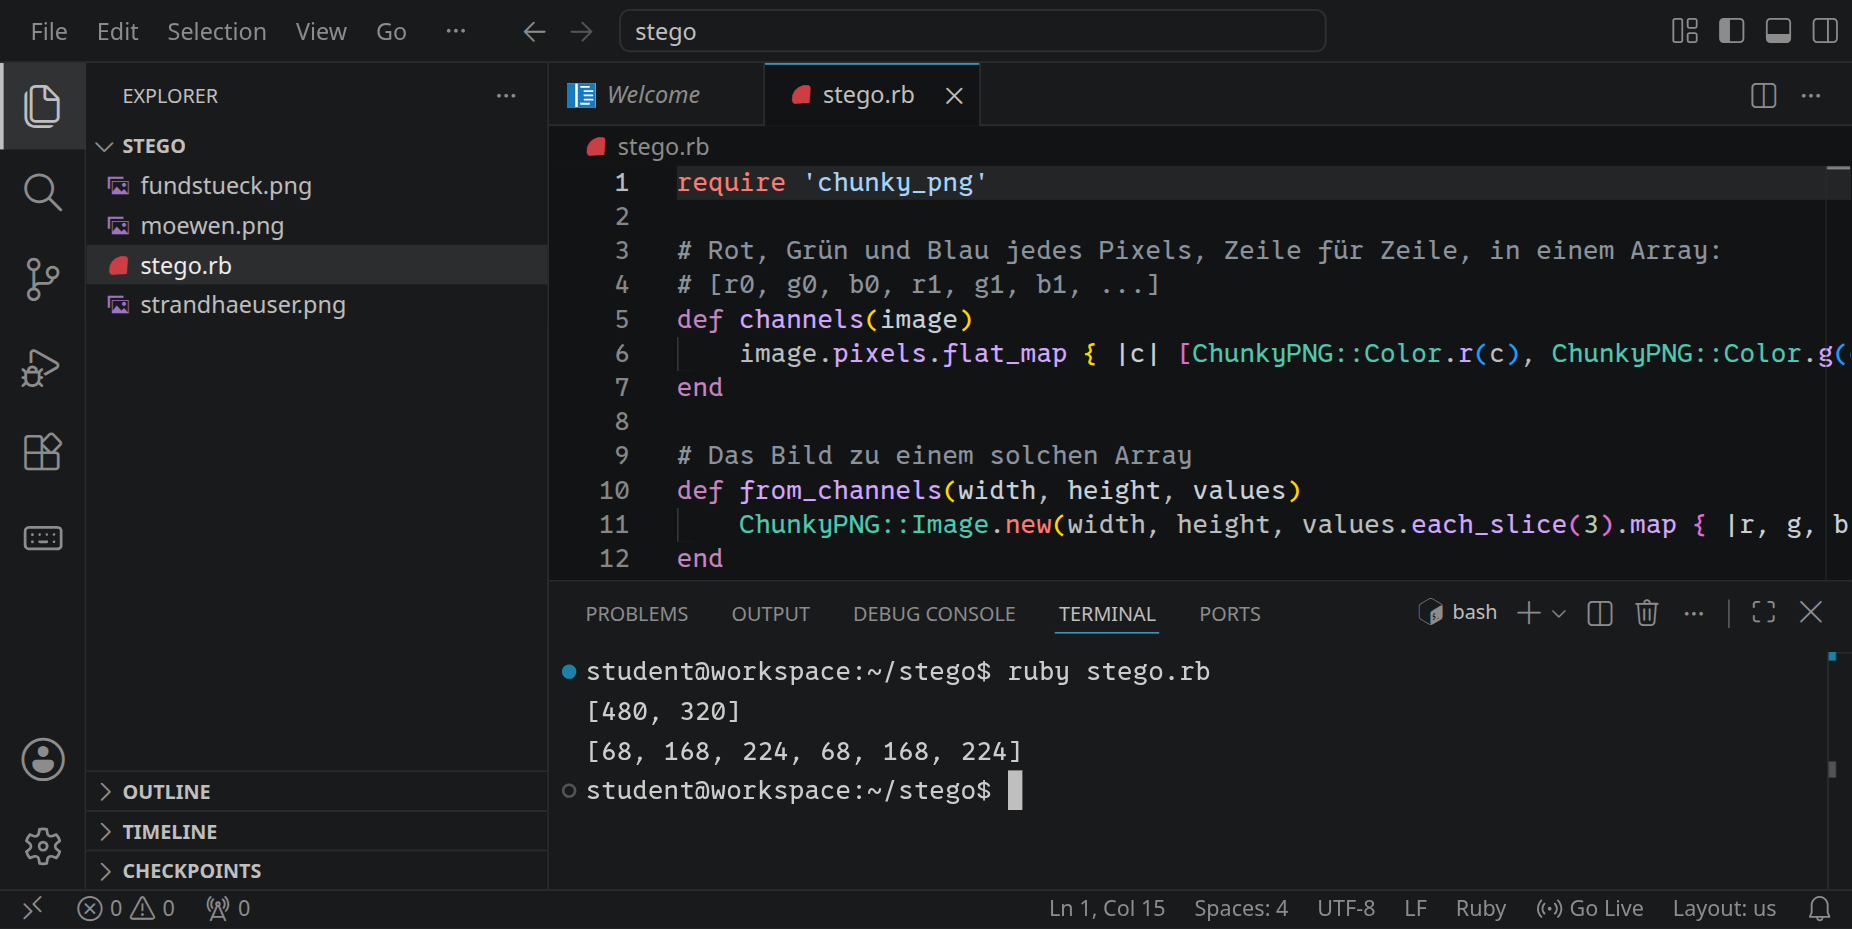
Starte es mit ruby stego.rb.
Lege die Datei stego.py an:
from PIL import Image


# Rot, Grün und Blau jedes Pixels, Zeile für Zeile, in einer Liste:
# [r0, g0, b0, r1, g1, b1, ...]
def channels(image):
    return list(image.convert('RGB').tobytes())


# Das Bild zu einer solchen Liste
def from_channels(width, height, values):
    return Image.frombytes('RGB', (width, height), bytes(values))


# Ein Bild aus einem einzigen Bit jedes Kanals: 255, wo es gesetzt ist, sonst 0
def bit_plane(image, bit=0):
    pass


image = Image.open('fundstueck.png')
print(image.size)
print(channels(image)[:6])
Starte es mit python3 stego.py.
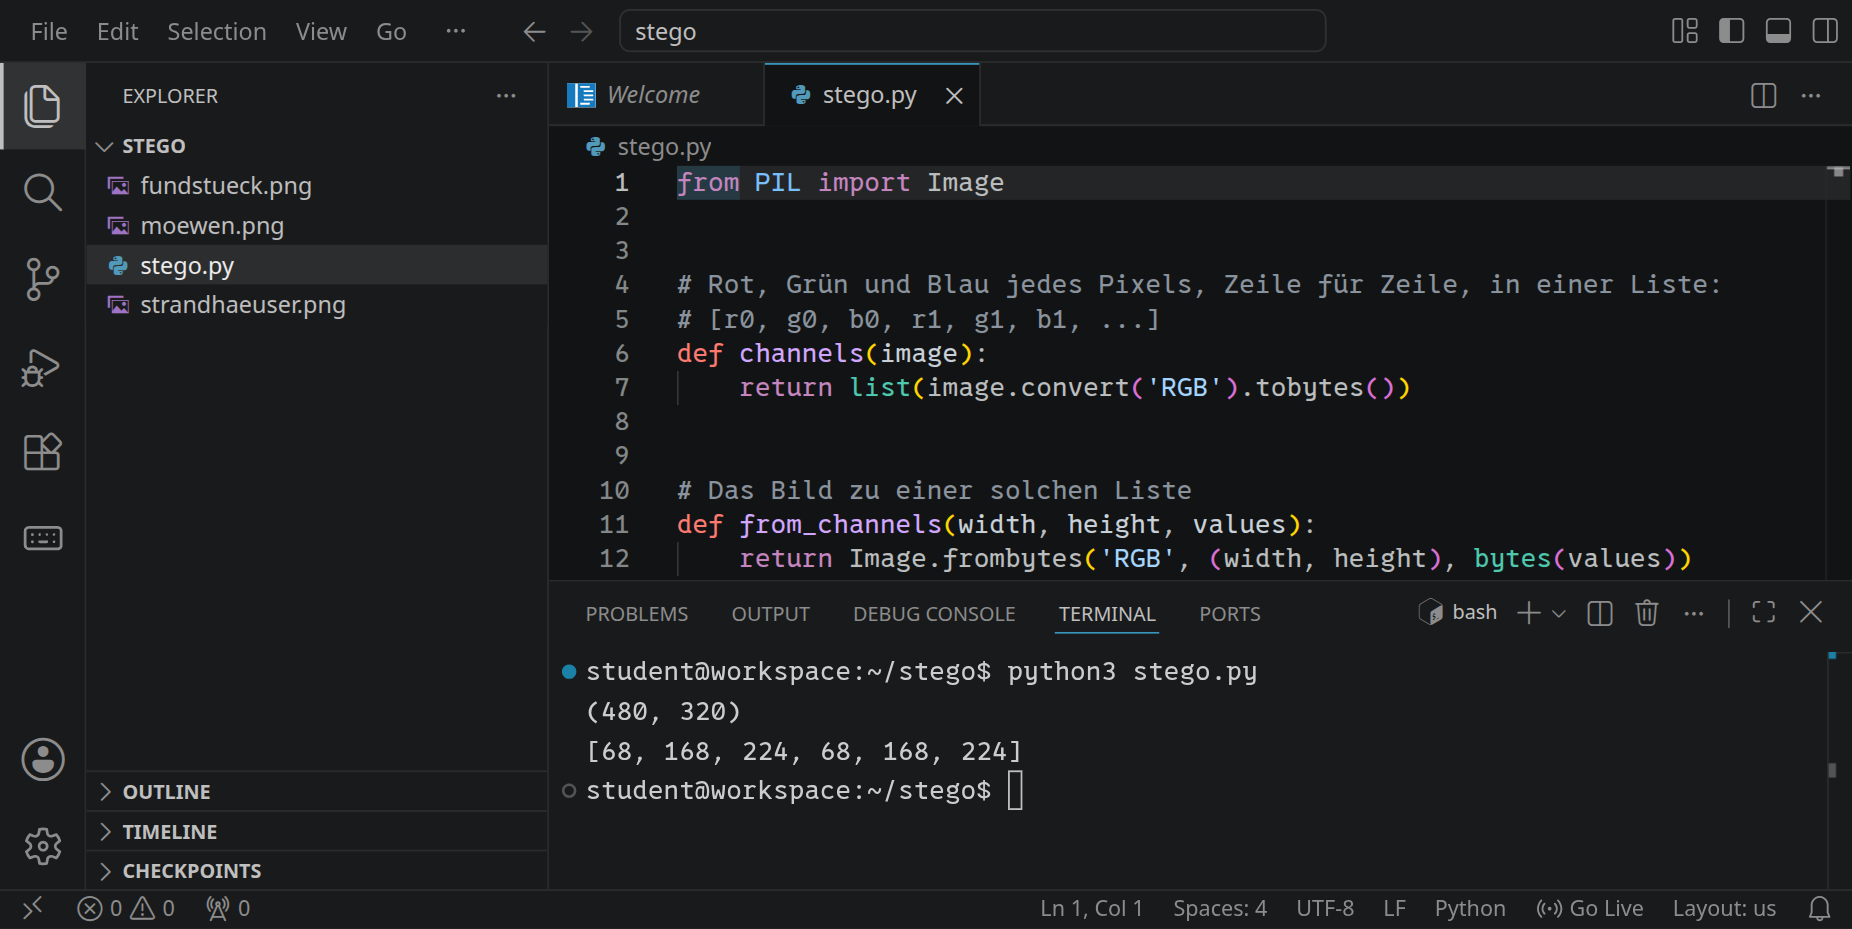
Die ersten sechs Zahlen sind die ersten beiden Pixel oben links, ein helles Himmelblau: 68, 168, 224 und noch einmal dasselbe.
Jede dieser Zahlen ist im Computer acht Bits, eine Zahl im Zweiersystem. 208 ist 11010000: 128 + 64 + 16. Das Bit ganz rechts, das unterste Bit, zählt nur 1. Ändert man es, wird aus 208 die 209, ein Blau, das kein Mensch von 208 unterscheiden kann. Das oberste Bit dagegen zählt 128: Aus 208 würde 80, ein ganz anderes Blau.
In Ruby liefert v[0] das unterste Bit einer Zahl v, v[1] das nächste und so weiter: 208[0] ist 0, 209[0] ist 1.
In Python schiebt v >> bit die Zahl um bit Stellen nach rechts, und & 1 behält nur das unterste Bit: (208 >> 0) & 1 ist 0, (209 >> 0) & 1 ist 1, (208 >> 4) & 1 ist 1.
Schreib bit_plane(image, bit): Es macht aus jedem Kanal 255, wenn sein Bit Nummer bit gesetzt ist, und sonst 0, und gibt das als neues Bild zurück, mit from_channels. Man nennt so ein Bild eine Bitebene. Die Bitebene 7 zeigt grob das Bild selbst; je tiefer das Bit, desto mehr sieht es nach Rauschen aus.
Schreib bit_plane(image, bit) in stego.rb: Jeder Kanal wird 255, wenn
sein Bit Nummer bit gesetzt ist, sonst 0. Speichere.
Schreib bit_plane(image, bit) in stego.py: Jeder Kanal wird 255,
wenn sein Bit Nummer bit gesetzt ist, sonst 0. Speichere.
Sieh dir die Bitebenen 0 und 1 des Fundstücks an. Speichere sie dafür als Bilder und öffne sie in Visual Studio Code:
image = ChunkyPNG::Image.from_file('fundstueck.png')
bit_plane(image, 0).save('ebene-0.png')
bit_plane(image, 1).save('ebene-1.png')
image = Image.open('fundstueck.png')
bit_plane(image, 0).save('ebene-0.png')
bit_plane(image, 1).save('ebene-1.png')
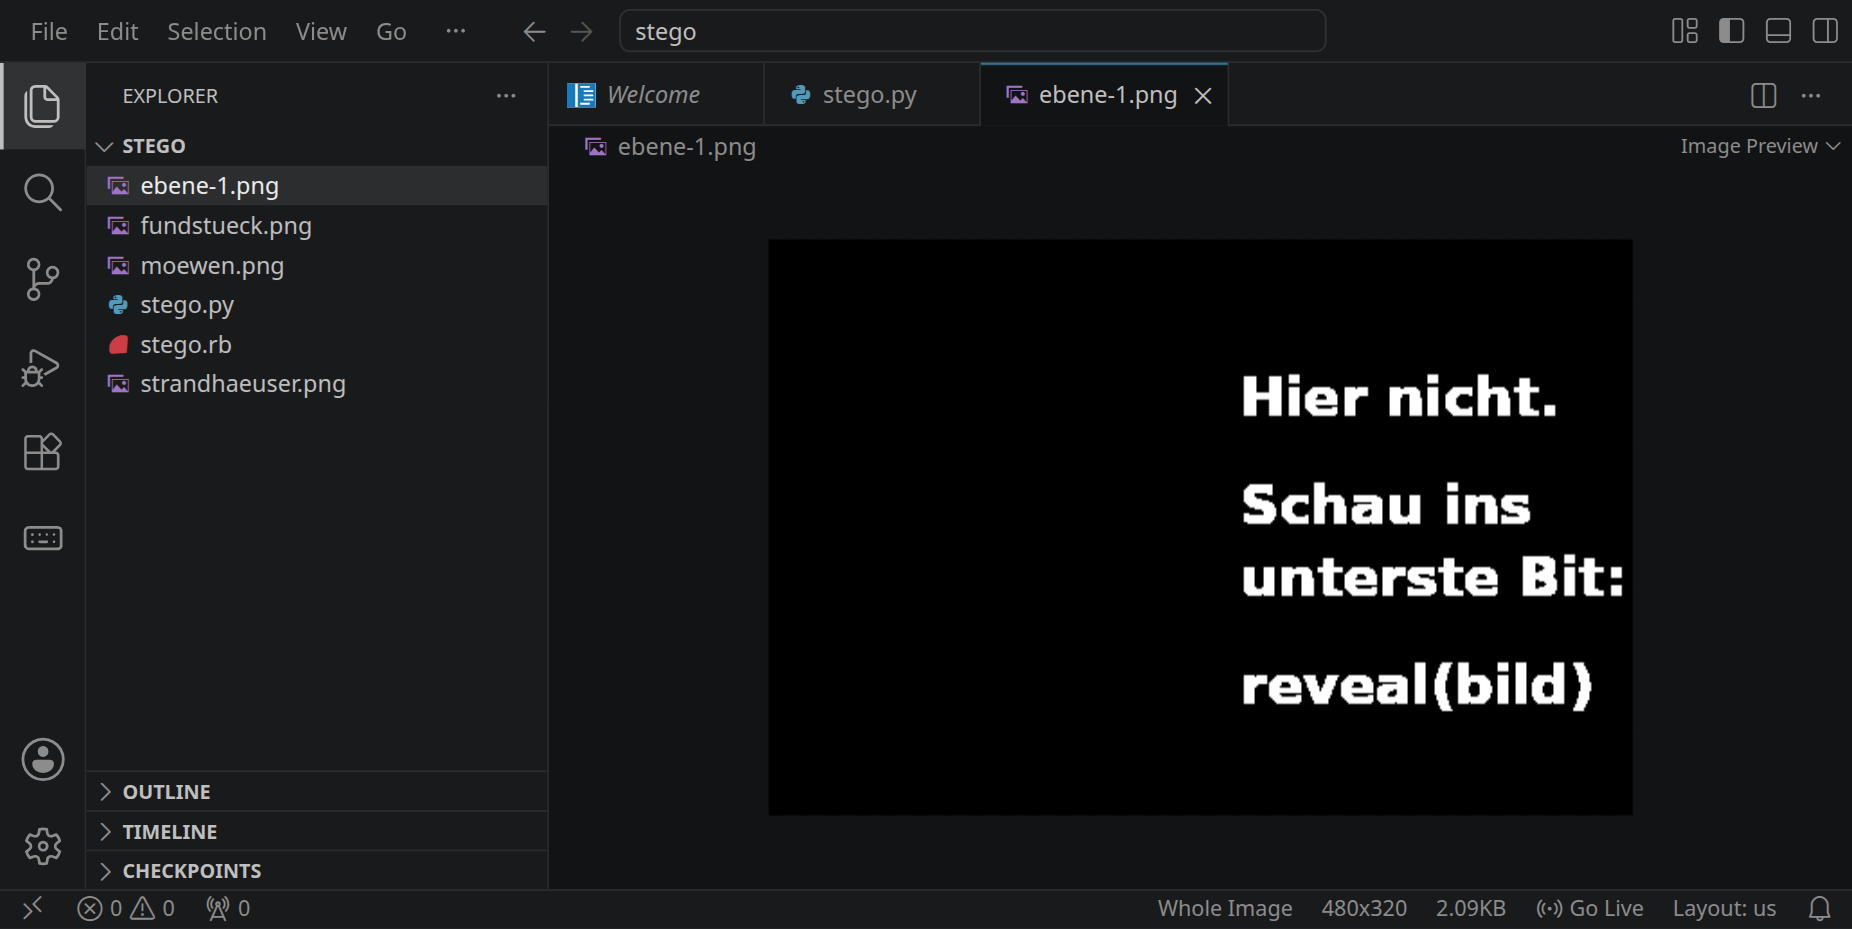
In Bitebene 1 steht ein Hinweis, mitten in einem Foto, das ganz normal aussieht. Bitebene 0 sieht dagegen nach Rauschen aus, wie bei jedem Foto, nur dass in ihr diesmal etwas steckt.
Das Verfahren heißt Least Significant Bit, kurz LSB: Jedes unterste Bit jedes Kanals wird durch ein Bit der Botschaft ersetzt. Damit ein Programm die Botschaft wieder herausholen kann, müssen beide Seiten dieselben Regeln benutzen. Hier sind sie:
01000001.channels.Schreib hide(image, message): Es gibt ein neues Bild zurück, in dem die Botschaft steckt, und meldet einen Fehler, wenn sie nicht hineinpasst. Und schreib reveal(image): Es liest zuerst 32 Bits und daraus die Länge, dann so viele Bytes, und macht wieder Text daraus.
message.b.bytes sind die Bytes eines Textes, [länge].pack('N').bytes die vier Bytes einer Zahl mit 32 Bit.(v & ~1) | bit setzt das unterste Bit von v auf bit und lässt die übrigen, wie sie sind.bytes.pack('C*').force_encoding('UTF-8') aus einem Array von Bytes wieder Text, auch mit Umlauten.message.encode() sind die Bytes eines Textes, len(data).to_bytes(4, 'big') die vier Bytes einer Zahl mit 32 Bit.(v & ~1) | bit setzt das unterste Bit von v auf bit und lässt die übrigen, wie sie sind.bytes(liste).decode() aus einer Liste von Bytes wieder Text, auch mit Umlauten.Schreib hide(image, message) und reveal(image) nach den drei Regeln
oben: erst die Länge mit 32 Bit, dann jedes Byte, das höchste Bit zuerst,
Rot, Grün und Blau der Reihe nach. Speichere.
Schreib hide(image, message) und reveal(image) nach den drei Regeln
oben: erst die Länge mit 32 Bit, dann jedes Byte, das höchste Bit
zuerst, Rot, Grün und Blau der Reihe nach. Speichere.
Jetzt kannst du lesen, was im Fundstück steckt:
puts reveal(ChunkyPNG::Image.from_file('fundstueck.png'))
print(reveal(Image.open('fundstueck.png')))
Lies mit reveal die Botschaft aus fundstueck.png. Wie heißt das
Codewort darin?
Versteck eine eigene Botschaft in strandhaeuser.png, speichere das Ergebnis als geheim.png und öffne beide nebeneinander. Findest du einen Unterschied?
Ein Bild mit 480 × 320 Pixeln hat 460.800 Kanäle und damit 460.800 unterste Bits: 57.600 Bytes, davon 4 für die Länge. Das ist eine ganze Menge Text, etwa 30 Seiten eines Buchs.
Die Spezifikation des GIF-Formats ist größer, 83.003 Bytes. Hol sie dir und versuch, sie in strandhaeuser.png zu verstecken:
wget https://workspace.hackschule.de/lzw/spec-gif89a.txt
File.binread('spec-gif89a.txt') liest die Datei als Bytes. hide sollte sich jetzt mit einer Fehlermeldung weigern.
open('spec-gif89a.txt', 'rb').read() liest die Datei als Bytes. Damit hide auch Bytes nimmt, nicht nur Text, mach aus message.encode() ein message.encode() if isinstance(message, str) else message. hide sollte sich jetzt mit einer Fehlermeldung weigern.
Wie viele Bytes darf eine Botschaft höchstens haben, die hide mit einem
Bit pro Kanal in strandhaeuser.png (480 × 320 Pixel) versteckt?
Mehr passt hinein, wenn man mehr als ein Bit pro Kanal ersetzt. Gib hide und reveal einen weiteren Parameter depth, wie viele der untersten Bits jeder Kanal trägt, zum Beispiel hide(image, message, 2). Mit 2 Bits passt die Spezifikation hinein. Nur: Mit jedem Bit mehr wird der Unterschied größer. Ein Kanal kann sich mit 1 Bit um höchstens 1 ändern, mit 2 Bits um 3, mit 4 Bits um 15.
Du füllst den Himmel aus moewen.png ganz mit Daten. Ab wie vielen Bits
pro Kanal siehst du es? Überleg erst, dann probier es mit hide(image,
message, depth) aus.
So sieht der Himmel aus moewen.png aus, wenn alle untersten Bits voller Daten sind:
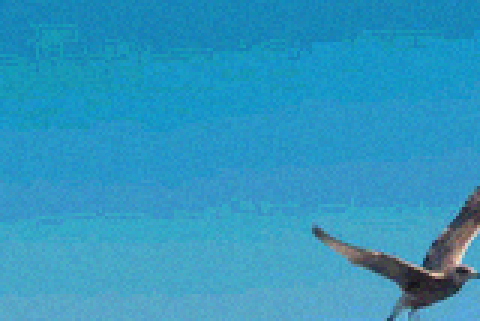
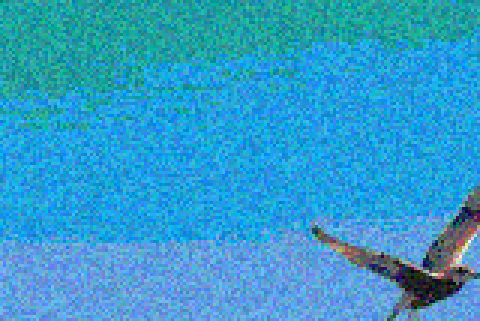
Mit 1 und 2 Bits sieht man nichts. Mit 4 Bits sieht man Rauschen und Streifen: Im glatten Verlauf des Himmels behält jeder Kanal nur noch seine oberen 4 Bits, also 16 Stufen statt 256, und der Verlauf zerfällt in Bänder. Gerade glatte Flächen verraten zu viele versteckte Daten; in Laub, Wellen oder Stoff fällt dasselbe Rauschen kaum auf.
Wer nach versteckten Botschaften sucht, hat das Bild ohne Botschaft nicht zum Vergleich. Trotzdem gibt es Spuren.
Hier sind die Strandhäuser und daneben ihre Bitebene 0: so, wie sie sind, mit der GIF-Spezifikation als Text im untersten Bit (so viel davon hineinpasst), und mit derselben Spezifikation, aber vorher komprimiert:
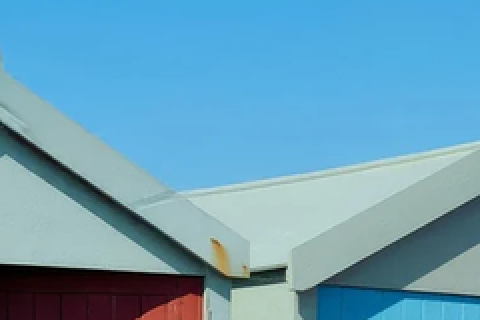
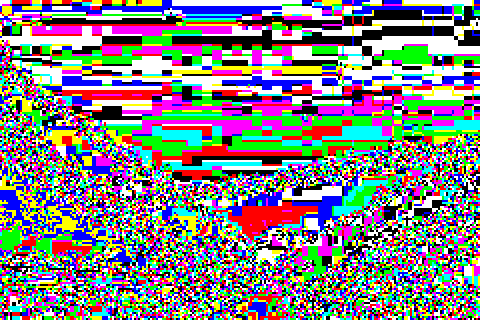
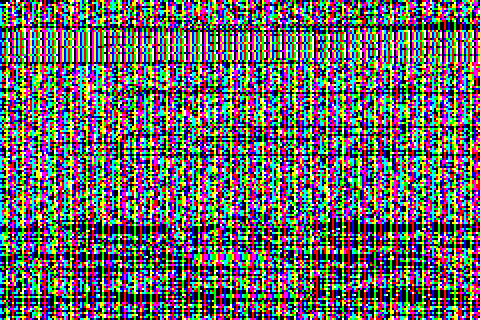
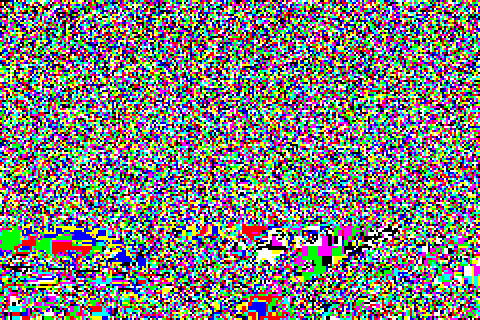
Text verrät sich: In UTF-8 ist bei den meisten Zeichen das oberste Bit jedes Bytes 0, und Buchstaben, Leerzeichen und Zeilenenden wiederholen sich. Jedes achte Bit ist fast immer gleich, und das ergibt die Streifen. Komprimierte Daten dagegen sehen aus wie Zufall: Ein guter Kompressor nimmt jede Wiederholung heraus, und übrig bleiben Bits, die so oft 0 wie 1 sind. Die Bitebene sieht dann aus wie bei einem gewöhnlichen Foto. Verschlüsselte Daten sehen genauso aus.
Komprimiere eine Botschaft vor dem Verstecken:
require 'zlib'
packed = Zlib::Deflate.deflate(File.binread('spec-gif89a.txt'), 9)
Aus 83.003 Bytes werden gut 20.000. Zurück geht es mit Zlib::Inflate.inflate. Damit reveal dafür Bytes liefert statt Text, gib ihm raw: true.
import zlib
packed = zlib.compress(open('spec-gif89a.txt', 'rb').read(), 9)
Aus 83.003 Bytes werden gut 20.000. Zurück geht es mit zlib.decompress. Damit reveal dafür Bytes liefert statt Text, gib ihm raw=True.
Ist die Botschaft damit unauffindbar? Nein, und gerade weil ihre Bits so gleichmäßig sind. Andreas Westfeld und Andreas Pfitzmann haben 1999 gezeigt, wie man das merkt.
Ersetzt man das unterste Bit, wird aus einer 208 entweder 208 oder 209, aus einer 209 ebenso. Die Werte 208 und 209 bilden ein Paar, und dasselbe gilt für 0 und 1, 2 und 3, bis 254 und 255. Sind die versteckten Bits zufällig, landet jeder Wert eines Paares mit gleicher Wahrscheinlichkeit auf dem einen oder dem anderen. Nach dem Verstecken kommen deshalb beide Werte eines Paares gleich oft vor. In einem gewöhnlichen Foto ist das nicht so: Dort ist 208 vielleicht 300-mal da und 209 nur 250-mal.
Der Chi-Quadrat-Test misst, wie weit die Paare von »gleich oft« entfernt sind, verglichen mit dem, was der Zufall allein ergäbe. Für jedes Paar zählst du, wie oft seine beiden Werte vorkommen, a und b. Gleich oft hieße: jeder \( e = \frac{a+b}{2} \)-mal. Dann rechnest du
$$\chi^2 = \sum_{\text{Paare}} \left( \frac{(a-e)^2}{e} + \frac{(b-e)^2}{e} \right)$$
und teilst durch die Zahl der Paare. Paare mit \( e < 5 \) lässt du weg, sie sind zu selten, um etwas zu sagen. Kommt etwa 1 heraus, sind die Paare genau so gleich, wie es zufällige unterste Bits machen: verdächtig. Ein Foto ohne Botschaft liegt weit darüber.
Schreib chi_square(image, top, bottom): Es rechnet den Test für die Zeilen top bis bottom des Bildes. Mit Pillow schneidet image.crop((0, top, image.width, bottom)) diese Zeilen aus, mit ChunkyPNG image.crop(0, top, image.width, bottom - top).
Schreib chi_square(image, top, bottom): der Test für die Zeilen top
bis bottom, durch die Zahl der Paare geteilt, ohne Paare mit
\( e < 5 \). Speichere.
Schreib chi_square(image, top, bottom): der Test für die Zeilen
top bis bottom, durch die Zahl der Paare geteilt, ohne Paare mit
\( e < 5 \). Speichere.
Rechne den Test für die Strandhäuser ohne Botschaft und mit der komprimierten Spezifikation, jeweils für die Zeilen 0 bis 40, 40 bis 80, 80 bis 120 und 120 bis 160. Die Botschaft füllt nur die obersten gut 110 Zeilen.
Die komprimierte Spezifikation sieht in der Bitebene aus wie Rauschen. Warum findet der Chi-Quadrat-Test sie trotzdem?
Der Test findet die Botschaft und sogar, wo sie aufhört: Dort, wo sie steckt, liegt das Ergebnis nahe bei 1, darunter ist es so groß wie ohne Botschaft. Am deutlichsten ist es im Himmel, wo das Foto ohne Botschaft weit über 100 ergibt. Rechne zum Vergleich auch die Zeilen 200 bis 240, die Türen mit ihrer feinen Maserung: Dort ist der Test schon ohne Botschaft klein, denn das Rauschen des Fotos ist dort selbst fast so gleichmäßig wie eine Botschaft. Eine Botschaft in solchen Flächen fällt viel weniger auf. Was hilft noch?
Das LSB-Verfahren lässt sich auch anders beschreiben. Alle Farben, die sich nur im untersten Bit jedes Kanals unterscheiden, bilden eine Farbklasse: zum Beispiel die 8 Farben mit Rot 208 oder 209, Grün 148 oder 149 und Blau 36 oder 37. Innerhalb einer Klasse sieht keine Farbe anders aus als die anderen. Ein Pixel darf also jede Farbe seiner Klasse annehmen, und welche es annimmt, trägt die Botschaft: 8 Möglichkeiten sind 3 Bits.
Im RGB-Würfel mit 256 × 256 × 256 Farben sind diese Klassen kleine Würfel mit der Kantenlänge 2. Warum nicht 3? Dann hat eine Klasse 3 · 3 · 3 = 27 Farben, und jedes Pixel kann eine von 27 Möglichkeiten tragen. Das sind \( \log_2 27 \approx 4{,}75 \) Bits, keine ganze Zahl. Ersetzen kann man da nichts mehr. Man braucht eine andere Idee.
Du kennst diese Idee von der Uhr. 3725 Sekunden sind 1 Stunde, 2 Minuten und 5 Sekunden: 3725 durch 60 ist 62, Rest 5; 62 durch 60 ist 1, Rest 2; übrig bleibt 1. Die Sekunden und Minuten haben die Basis 60, die Stunden 24. Jede Stelle hat ihre eigene Basis.
Genauso wird die Botschaft eine einzige große Zahl \( P \), und jedes Pixel eine Stelle. Seine Basis ist die Größe \( s \) seiner Klasse:
Zum Lesen geht man rückwärts, vom letzten benutzten Pixel bis zum ersten: \( P \) beginnt bei 0, und für jedes Pixel wird \( P = P \cdot s + \text{Nummer seiner Farbe} \). Das ist dasselbe wie »1 Stunde ist 60 Minuten, plus 2 Minuten, mal 60, plus 5 Sekunden«. Dafür muss der Leser wissen, wie viele Pixel benutzt wurden; diese Zahl steht vorher in den untersten Bits der ersten 11 Pixel, 33 Bits.
Drei Pixel haben Klassen der Größe 5, 3 und 4. Welche Ziffern bekommen sie für die Zahl 37? Schreib sie in der Reihenfolge der Pixel, mit Leerzeichen dazwischen.
Ruby und Python rechnen mit beliebig großen ganzen Zahlen, ohne Bibliothek: Eine Botschaft mit 20.000 Bytes ist eine Zahl mit 160.000 Bits, und % und // (in Ruby divmod) funktionieren genauso wie mit kleinen Zahlen. Je größer die Zahl, desto länger dauert jede Division; für ein paar Sätze merkst du davon nichts.
Schreib eine Klasse BoxClasses mit BoxClasses.new(width) für Würfel mit width Werten pro Kanal:
cell(color) gibt zu einer Farbe 0xRRGGBB ihre Klasse, etwa [r / width, g / width, b / width].members(cell) gibt alle Farben dieser Klasse als Array, aufsteigend sortiert. Am Rand des Würfels ist eine Klasse kleiner: 256 ist nicht durch 3 teilbar.Dann embed(image, message, classes) und extract(image, classes) nach den Regeln oben, mit den Farben jedes Pixels als 0xRRGGBB (image.pixels.map { |c| c >> 8 }). Die Botschaft wird zur Zahl mit ("\x01".b + message.b).unpack1('H*').to_i(16); die 1 davor sorgt dafür, dass Nullen am Anfang nicht verloren gehen. Und capacity(image, classes) zählt zusammen, wie viele Bits passen: für jedes Pixel ab dem zwölften Math.log2 der Größe seiner Klasse.
Schreib eine Klasse BoxClasses mit BoxClasses(width) für Würfel mit width Werten pro Kanal:
cell(color) gibt zu einer Farbe 0xRRGGBB ihre Klasse, etwa (r // width, g // width, b // width).members(cell) gibt alle Farben dieser Klasse als Liste, aufsteigend sortiert. Am Rand des Würfels ist eine Klasse kleiner: 256 ist nicht durch 3 teilbar.Dann embed(image, message, classes) und extract(image, classes) nach den Regeln oben, mit den Farben jedes Pixels als 0xRRGGBB. Die Botschaft wird zur Zahl mit int.from_bytes(b'\x01' + message.encode(), 'big'); die 1 davor sorgt dafür, dass Nullen am Anfang nicht verloren gehen. Zurück geht es mit number.to_bytes((number.bit_length() + 7) // 8, 'big')[1:]. Und capacity(image, classes) zählt zusammen, wie viele Bits passen: für jedes Pixel ab dem zwölften math.log2 der Größe seiner Klasse.
Mit BoxClasses(2) ist das wieder das LSB-Verfahren, 3 Bits pro Pixel. Mit 3 sind es 4,75 Bits, mit 5 schon fast 7. So lässt sich die Menge, die man versteckt, fein einstellen, nicht nur in Schritten von ganzen Bits.
Schreib BoxClasses, embed, extract und capacity in stego.rb.
Speichere.
Schreib BoxClasses, embed, extract und capacity in
stego.py. Speichere.
Mit Würfeln der Breite 2 ist das Verfahren wieder das LSB-Verfahren, und der Chi-Quadrat-Test findet es wie vorher. Mit der Breite 3 ändert sich etwas, das man nicht sofort sieht: Jetzt kann ein Kanal nicht mehr nur das unterste Bit wechseln, sondern einen von drei Werten annehmen. Was macht der Test daraus?
Du versteckst die ersten 20.000 Zeichen der GIF-Spezifikation mit
Würfeln der Breite 3 in strandhaeuser.png. Was ergibt chi_square
danach für die Zeilen 0 bis 40? Überleg erst, dann probier es aus.
image = ChunkyPNG::Image.from_file('strandhaeuser.png')
hidden = embed(image, File.read('spec-gif89a.txt')[0, 20000], BoxClasses.new(3))
puts chi_square(hidden, 0, 40)
image = Image.open('strandhaeuser.png')
hidden = embed(image, open('spec-gif89a.txt').read()[:20000], BoxClasses(3))
print(chi_square(hidden, 0, 40))
Die Botschaft füllt die obersten gut 70 Zeilen, und trotzdem schlägt der Test nicht an. Er vergleicht die Paare 2k und 2k+1, weil das LSB-Verfahren genau diese beiden Werte gleich häufig macht. Würfel der Breite 3 machen aber Gruppen von drei Werten gleich häufig: 0, 1 und 2, dann 3, 4 und 5. Die Paare des Tests liegen quer dazu, 2 und 3 etwa gehören zu verschiedenen Gruppen. So geht es mit jeder ungeraden Breite. Bei der Breite 4 dagegen liegt jedes Paar in einer Gruppe, und der Test findet die Botschaft wieder.
| Werte | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Paare des Tests | 0–1 | 2–3 | 4–5 | 6–7 | 8–9 | 10–11 | ||||||
| Würfel der Breite 3 | 0–2 | 3–5 | 6–8 | 9–11 | ||||||||
| Würfel der Breite 4 | 0–3 | 4–7 | 8–11 | |||||||||
Jede Farbe einer Gruppe kommt nach dem Verstecken gleich oft vor. Bei der Breite 4 liegen in jeder Gruppe zwei ganze Paare, also werden auch die Paare gleich. Bei der Breite 3 schneiden die Gruppen durch die Paare hindurch: 2 und 3, 8 und 9 liegen in verschiedenen Gruppen.
Der Test muss also wissen, wonach er sucht. Er lässt sich leicht verallgemeinern: Statt der Paare nimmt er Gruppen von width Werten, die Werte \( k \cdot w \) bis \( k \cdot w + w - 1 \). Für jede Gruppe ist \( e \) der Durchschnitt ihrer Zählungen, und sie trägt \( \sum (c - e)^2 / e \) bei, über ihre \( w \) Zählungen \( c \). Geteilt durch \( w - 1 \) ergibt eine Gruppe, die nur der Zufall gleichmacht, wieder etwa 1. Mit \( w = 2 \) ist das genau der Test von vorhin.
Gib chi_square einen vierten Parameter width mit dem Standardwert 2:
Gruppen von width Werten statt Paaren, jede Gruppe geteilt durch
width - 1. Speichere.
Gib chi_square einen vierten Parameter width mit dem Standardwert
2: Gruppen von width Werten statt Paaren, jede Gruppe geteilt durch
width - 1. Speichere.
Für den versteckten Text mit der Breite 3 ergibt der Test mit width 3 jetzt etwa 1. Wer etwas verstecken will, darf sich nicht darauf verlassen, dass der andere sein Verfahren nicht kennt; ein paar Breiten auszuprobieren dauert nur Sekunden. In der Kryptographie heißt das Prinzip von Kerckhoffs: Ein Verfahren muss sicher bleiben, auch wenn der Gegner alles darüber weiß außer dem Schlüssel.
Hol dir noch ein Bild:
wget https://workspace.hackschule.de/steganography/fundstueck-2.png
Darin steckt eine Botschaft, versteckt mit Würfeln, aber welche Breite sie haben, steht nirgends. Probier mit deinem Test die Breiten 2 bis 8 für die Zeilen 0 bis 40 aus:
image = ChunkyPNG::Image.from_file('fundstueck-2.png')
(2..8).each { |width| puts "#{width}: #{chi_square(image, 0, 40, width).round(1)}" }
Mit der richtigen Breite liest extract die Botschaft. Sie ist lang; gib nur den Anfang aus, etwa mit [0, 200].
image = Image.open('fundstueck-2.png')
for width in range(2, 9):
    print(width, round(chi_square(image, 0, 40, width), 1))
Mit der richtigen Breite liest extract die Botschaft. Sie ist lang; gib nur den Anfang aus, etwa mit [:200].
In fundstueck-2.png steckt eine Botschaft in Würfeln, aber welcher
Breite? Finde sie mit deinem Test und lies die Botschaft. Wie heißt das
Codewort?
Gib den Ordner stego ab: dein Programm und ein Bild, in dem du eine
eigene Botschaft versteckt hast. Schreib in eine Datei README.txt,
mit welchem Verfahren und welchen Einstellungen.
embed und extract brauchen von ihr nur cell und members.