powered by 
Du baust einen Routenplaner wie den in deinem Handy, mit echten Karten von OpenStreetMap: Dein Programm macht aus den Straßen und Wegen von Berlin einen Graphen und findet darin den kürzesten Weg, von deiner Schule zum Botanischen Garten oder quer durch die Stadt zum Brandenburger Tor. Erst in Steglitz-Zehlendorf, dann in jedem anderen Bezirk und in ganz Berlin, wo der schnelle Weg auch eine schnelle Suche braucht.
Für diese Anleitung brauchst du die Vorlage des Routenplaners:
Stelle zuerst sicher, dass du keinen Ordner geöffnet hast. Um sicherzugehen, drücke einfach den Shortcut für »Ordner schließen«: StrgK und dann F. Dein Workspace sollte jetzt ungefähr so aussehen:
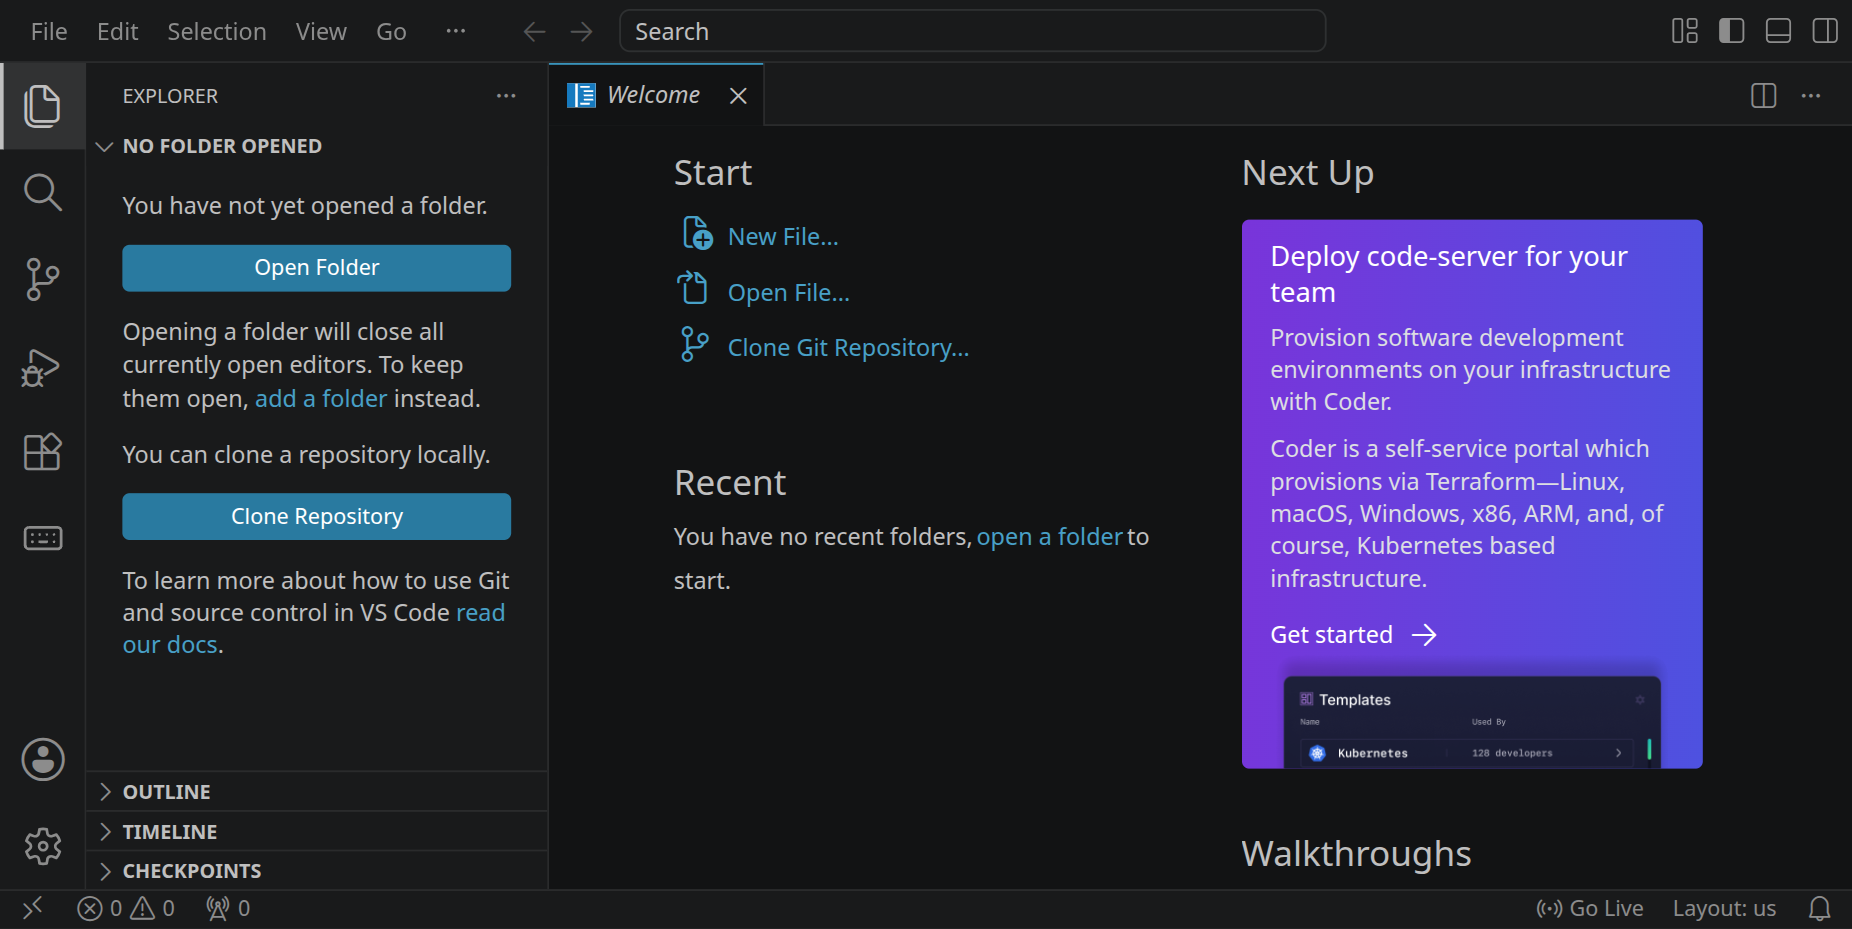
Klicke auf »Clone Repository« und füge die Adresse der Vorlage ein:
https://github.com/specht/routenplaner-starter.git
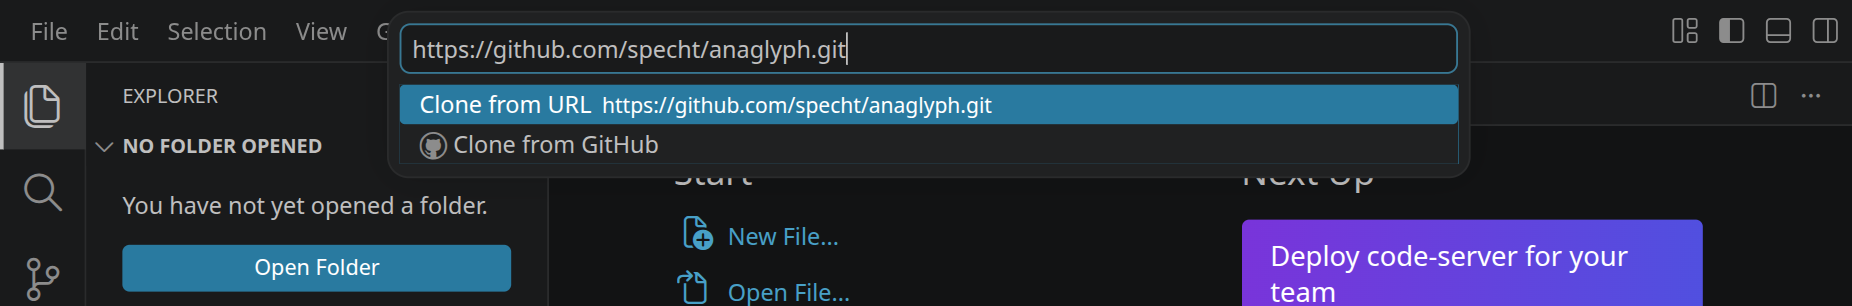
Bestätige mit Enter. Danach wählst du das Verzeichnis, in dem das Repository gespeichert werden soll: den Ordner /workspace.
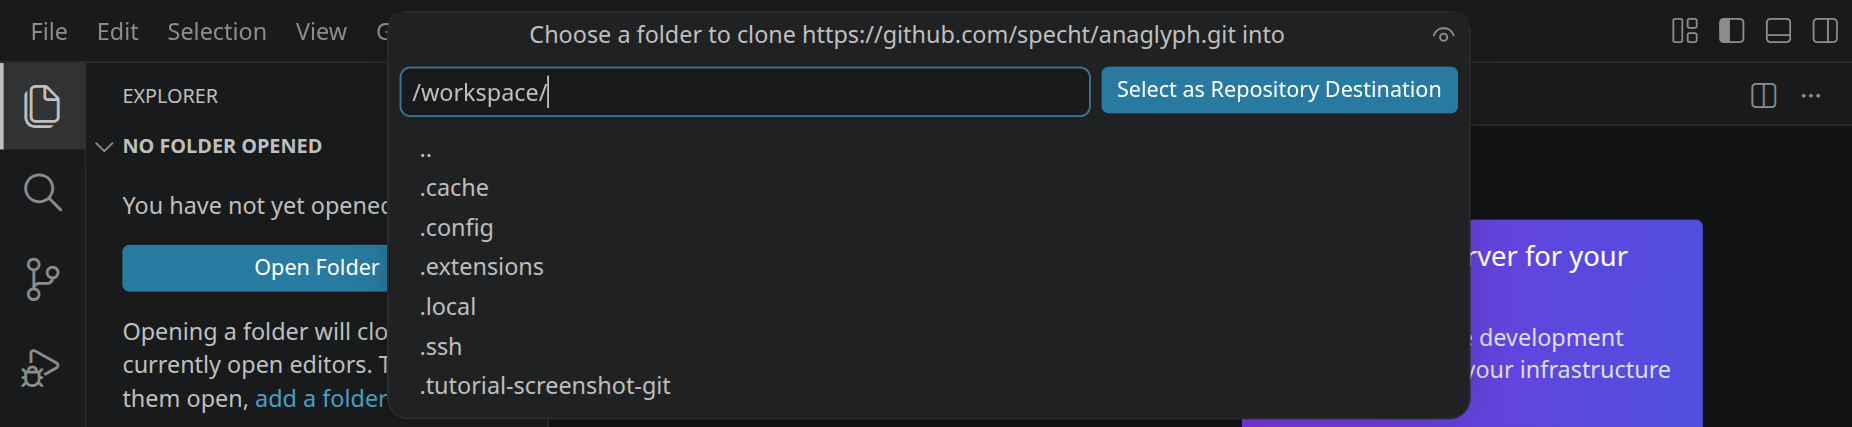
Das Repository wird jetzt in einen Unterordner von /workspace geklont, der so heißt wie das Repository. Beantworte die Frage, ob es jetzt geöffnet werden soll, mit »Open«:
Der Routenplaner läuft im Browser. Die Seite mit der Karte bekommt er von einem kleinen Server in Ruby, der mit Sinatra gebaut ist. Sinatra installierst du einmal, es bleibt in deinem Workspace:
gem install sinatra rackup puma
Dann startest du den Server:
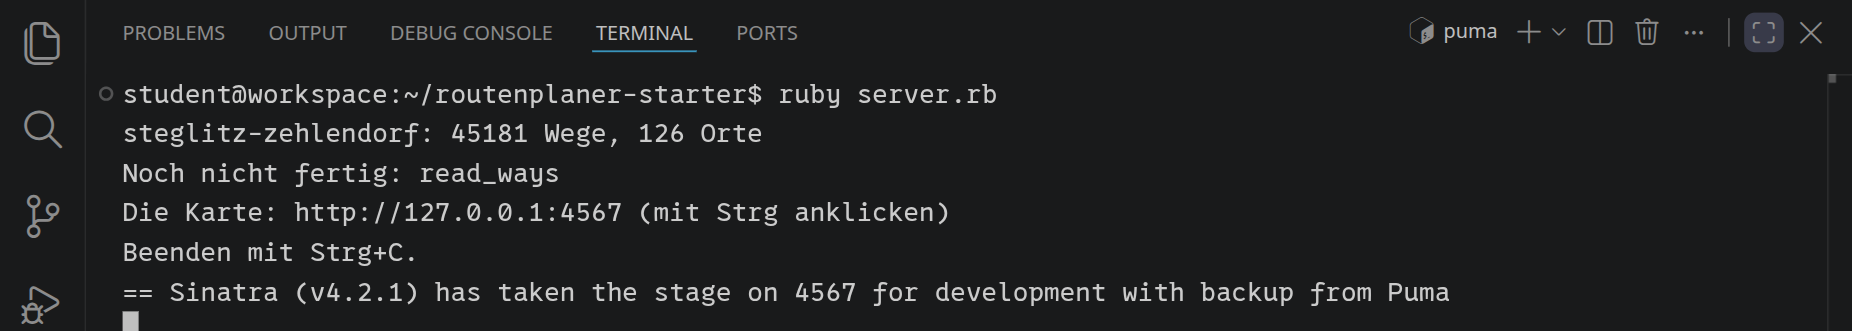
ruby server.rb
Der Routenplaner läuft im Browser. Die Seite mit der Karte bekommt er von einem kleinen Server in Python, der mit Flask gebaut ist. Flask installierst du einmal, es bleibt in deinem Workspace:
pip install flask
Dann startest du den Server:
python3 server.py
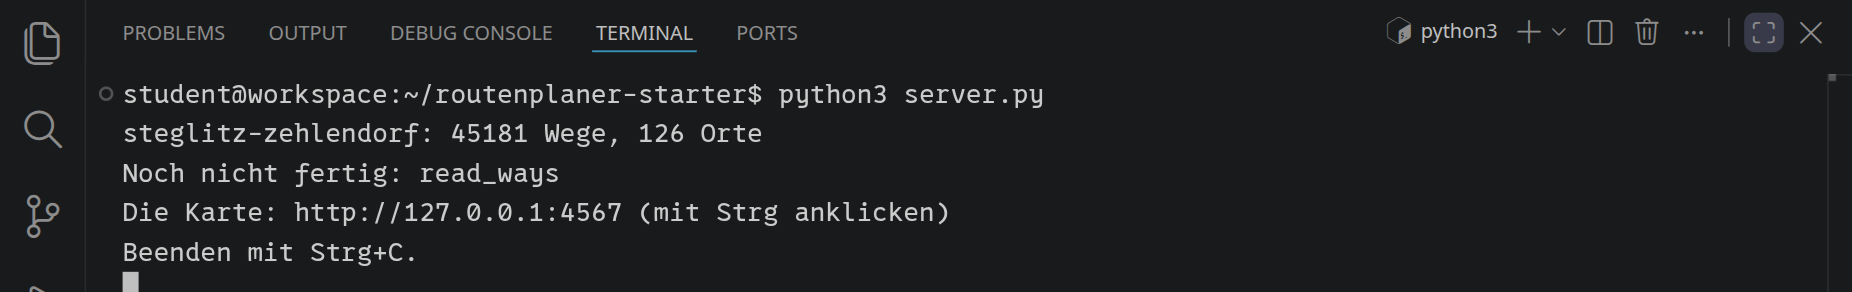
Der Server sagt, was er gefunden hat: 45 181 Wege in Steglitz-Zehlendorf und 126 Orte. Dass read_ways noch nicht fertig ist, stimmt: Das schreibst du gleich selbst. Der Server läuft so lange, bis du ihn mit StrgC anhältst.
Darunter steht die Adresse der Karte, http://127.0.0.1:4567. Klicke mit gedrückter Strg-Taste darauf: Visual Studio Code leitet den Port 4567 an eine Adresse weiter, die dein Browser erreicht, und öffnet sie.
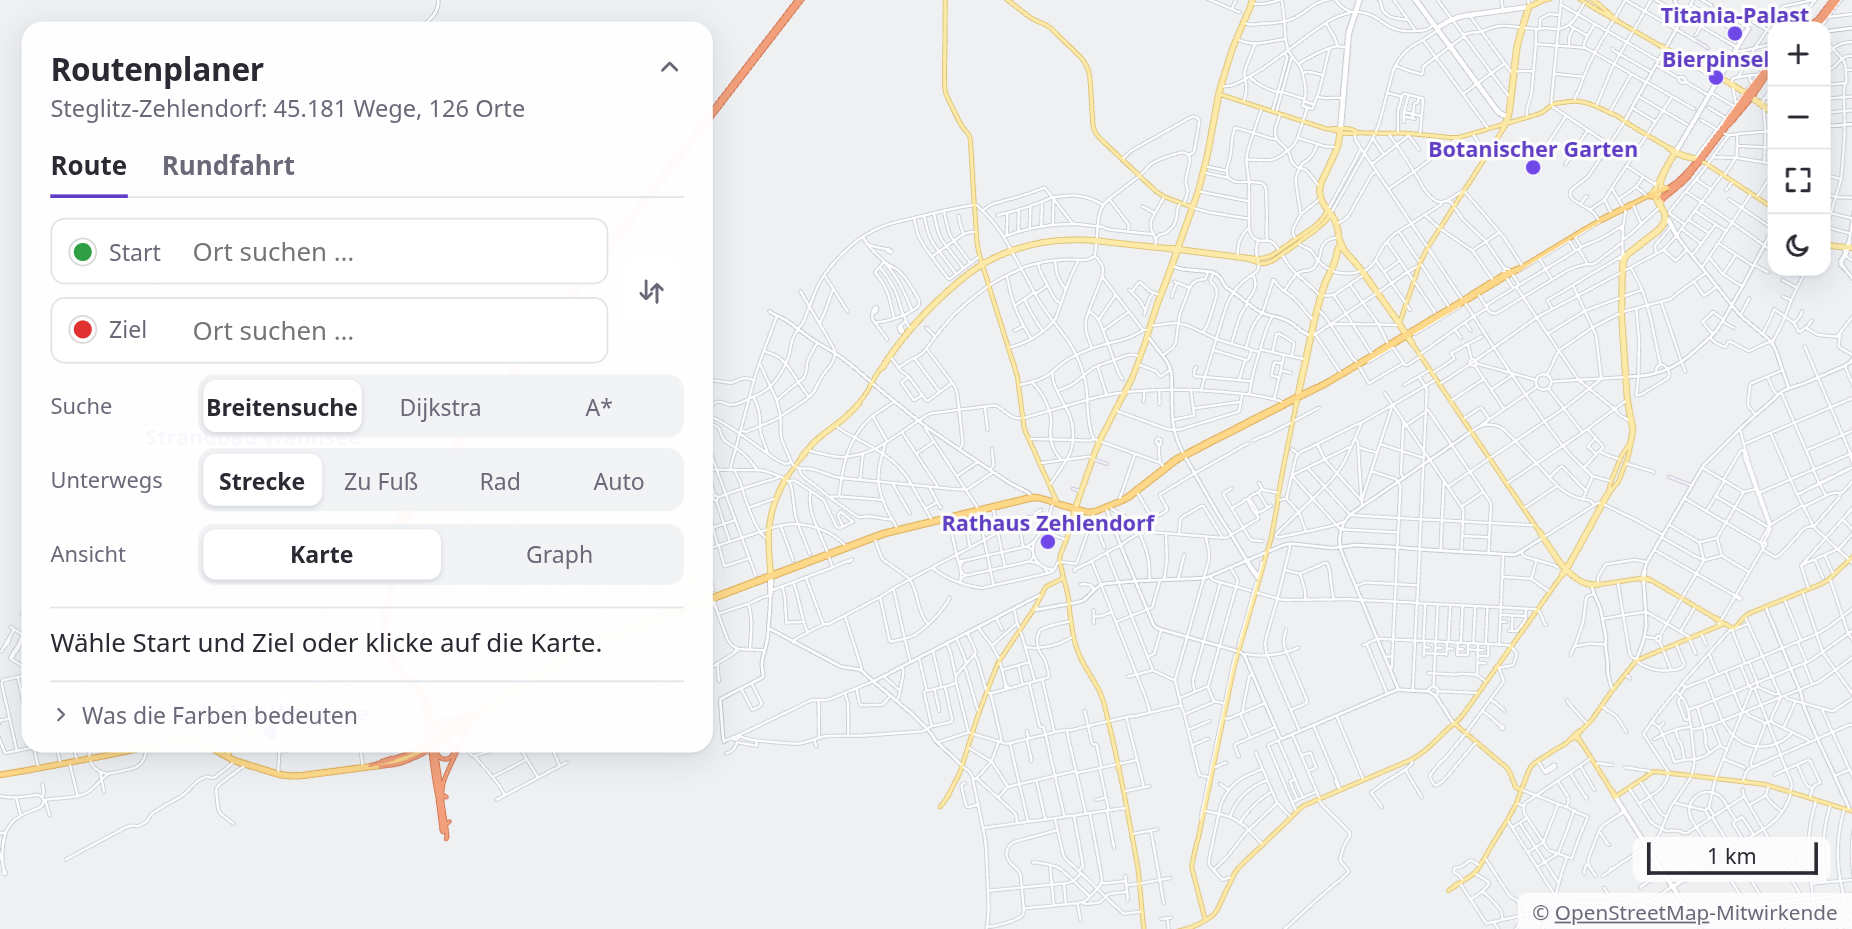
Ziehen verschiebt die Karte, das Mausrad und die Knöpfe rechts oben zoomen, ein Doppelklick holt eine Stelle heran. Oben links wählst du Start und Ziel: Tipp den Anfang eines Namens, und die Seite schlägt Sehenswürdigkeiten, Plätze und Schulen in Steglitz-Zehlendorf vor. Adressen gibt es mit Absicht nicht. Die »Legende« darunter sagt, welche Farbe welche Art von Weg ist. Einen Weg findet die Seite noch nicht; das bringst du ihr bei.
Die Vorlage hat die Karte von Steglitz-Zehlendorf. Jeden anderen Bezirk lädt der Server beim ersten Start selbst herunter, wenn du ihn so startest:
AREA=mitte ruby server.rb
Die Namen der Bezirke: charlottenburg-wilmersdorf, friedrichshain-kreuzberg, lichtenberg, marzahn-hellersdorf, mitte, neukoelln, pankow, reinickendorf, spandau, steglitz-zehlendorf, tempelhof-schoeneberg, treptow-koepenick. Ganz Berlin heißt berlin, aber damit warte lieber, bis deine Suche schnell ist.
Die Karte kommt von OpenStreetMap, einer Karte der ganzen Welt, an der alle mitzeichnen dürfen. Sie besteht aus Wegen: Jede Straße, jeder Fußweg, jede Treppe ist eine Folge von Punkten. Wo sich zwei Wege kreuzen, teilen sie sich einen Punkt.
Öffne data/steglitz.tsv. Jede Zeile ist ein Weg, die vier Teile trennt ein Tabulator:
residential Schloßstraße 26735834 13.326700,52.456700 26735901 13.325300,52.457700 …
| Teil | Bedeutung |
|---|---|
| Art | was für ein Weg: residential (Wohnstraße), primary (Hauptstraße), footway (Fußweg), cycleway (Radweg), steps (Treppe), … |
| Einbahnstraße |
yes, wenn man nur in Richtung der Punkte fahren darf, -1 nur dagegen, sonst leer |
| Name | der Name der Straße, oft leer |
| Punkte | je eine ID und die Lage als Länge und Breite in Grad, mit Komma dazwischen |
Die ID macht den Punkt eindeutig: Zwei Wege mit derselben ID an einem Punkt sind an dieser Stelle verbunden. Länge und Breite sind die Koordinaten, wie in jeder Karten-App: Steglitz liegt bei 13,3 Grad östlicher Länge und 52,45 Grad nördlicher Breite.
Wie viele Wege in data/steglitz-zehlendorf.tsv sind Fußwege, also von der Art footway?
grep -c zählt die Zeilen, auf die ein Muster passt: grep -c "^footway" data/steglitz-zehlendorf.tsv. Das ^ heißt »am Anfang der Zeile«.
Jetzt liest dein Programm die Datei. read_ways in routes.rb soll für jeden Weg einen Hash zurückgeben, mit der Art, der Einbahnstraße, dem Namen und den Punkten. Ein Punkt ist ein Array aus ID, Länge und Breite:
{ kind: 'residential', oneway: '', name: 'Schloßstraße',
  points: [['26735834', 13.3267, 52.4567], ['26735901', 13.3253, 52.4577]] }
File.readlines(path, chomp: true) gibt die Zeilen ohne Zeilenumbruch, split("\t") teilt eine Zeile an den Tabulatoren. Die Punkte teilst du an den Leerzeichen und nimmst je zwei Teile zusammen: each_slice(2). to_f macht aus '13.326700' die Zahl 13.3267.
Jetzt liest dein Programm die Datei. read_ways in routes.py soll für jeden Weg ein Dictionary zurückgeben, mit der Art, der Einbahnstraße, dem Namen und den Punkten. Ein Punkt ist eine Liste aus ID, Länge und Breite:
{'kind': 'residential', 'oneway': '', 'name': 'Schloßstraße',
 'points': [['26735834', 13.3267, 52.4567], ['26735901', 13.3253, 52.4577]]}
for line in open(path, encoding='utf-8') geht die Zeilen durch, line.rstrip('\n') nimmt den Zeilenumbruch weg, split('\t') teilt eine Zeile an den Tabulatoren. Die Punkte teilst du an den Leerzeichen; items[0::2] sind dann die IDs, items[1::2] die Lagen, und zip nimmt beide zusammen. float macht aus '13.326700' die Zahl 13.3267.
Ausprobieren kannst du read_ways mit der kleinen Testkarte data/test.tsv: drei Wege, fünf Punkte.
Schreib read_ways in routes.rb.
Schreib read_ways in routes.py.
Für den kürzesten Weg braucht dein Programm Abstände in Metern. Die Koordinaten sind aber in Grad. Die Erde hat einen Radius von etwa 6 371 km; ein Grad ist ein 360stel ihres Umfangs:
$$1° = \frac{2\pi \cdot 6\,371\,000\ \text{m}}{360} \approx 111\,195\ \text{m}$$
Das gilt für die Breite, nach Norden. Nach Osten stimmt es nur am Äquator: Die Längengrade laufen an den Polen zusammen, und je weiter nördlich man ist, desto näher liegen sie beieinander, um den Faktor \(\cos(\text{Breite})\). In Berlin ist ein Grad Länge nur gut 67 km lang.
Warum ist in Berlin ein Grad Länge (nach Osten) kürzer als ein Grad Breite (nach Norden)?
Auf den paar Kilometern einer Stadt ist die Erde fast flach. Du rechnest beide Unterschiede in Meter um und nimmst den Satz des Pythagoras:
$$d = \sqrt{(\Delta\text{Länge} \cdot \cos(\text{Breite}))^2 + (\Delta\text{Breite})^2} \cdot \frac{\pi}{180} \cdot 6\,371\,000\ \text{m}$$
Die Winkel sind dabei im Bogenmaß: Der Cosinus (Math.cos in Ruby, math.cos in Python) und die Umrechnung mit \(\pi / 180\) erwarten keine Grad. Als Breite nimmst du die Mitte zwischen den beiden Punkten.
Schreib distance in routes.rb.
Schreib distance in routes.py.
Ein Routenplaner sucht nicht in Wegen, sondern in einem Graphen: Punkte, die Knoten, und Verbindungen zwischen ihnen, die Kanten. Jede Kante hat eine Länge in Metern. Aus jedem Weg werden so viele Kanten, wie er Abschnitte hat: zwischen dem ersten und dem zweiten Punkt, dem zweiten und dem dritten und so weiter. Ein Fußweg, der zwei Straßen verbindet, wird zu Kanten, die über die gemeinsamen Punkte an beide anschließen.
build_graph bekommt die Wege und gibt zwei Hashes zurück: nodes mit der Lage jedes Punktes, edges mit seinen Nachbarn und dem Abstand zu jedem. Kanten gelten erst einmal in beide Richtungen; um Einbahnstraßen kümmerst du dich später:
{ nodes: { '2' => [13.301, 52.45], … },
  edges: { '2' => [['1', 67.8], ['3', 67.8], ['4', 111.2]], … } }
each_cons(2) gibt immer zwei aufeinanderfolgende Punkte eines Weges. Hash.new { |hash, id| hash[id] = [] } ist ein Hash, der für einen neuen Schlüssel von selbst ein leeres Array anlegt.
build_graph bekommt die Wege und gibt zwei Dictionaries zurück: 'nodes' mit der Lage jedes Punktes, 'edges' mit seinen Nachbarn und dem Abstand zu jedem. Kanten gelten erst einmal in beide Richtungen; um Einbahnstraßen kümmerst du dich später:
{'nodes': {'2': [13.301, 52.45], …},
 'edges': {'2': [['1', 67.8], ['3', 67.8], ['4', 111.2]], …}}
zip(points, points[1:]) gibt immer zwei aufeinanderfolgende Punkte eines Weges. edges.setdefault(id, []) gibt die Liste der Nachbarn von id und legt sie an, wenn es sie noch nicht gibt.
Schreib build_graph in routes.rb.
Schreib build_graph in routes.py.
Halte den Server mit StrgC an und starte ihn neu. Er baut jetzt mit deinen Funktionen den Graphen von Steglitz-Zehlendorf. Wähle auf der Seite unter »Ansicht« den »Graph«: Über der blassen Karte siehst du, was build_graph gebaut hat, jeden Knoten als Punkt und jede Kante als Linie. Klicke auf eine Kreuzung: Die Seite zeigt den Knoten dort und seine Nachbarn.
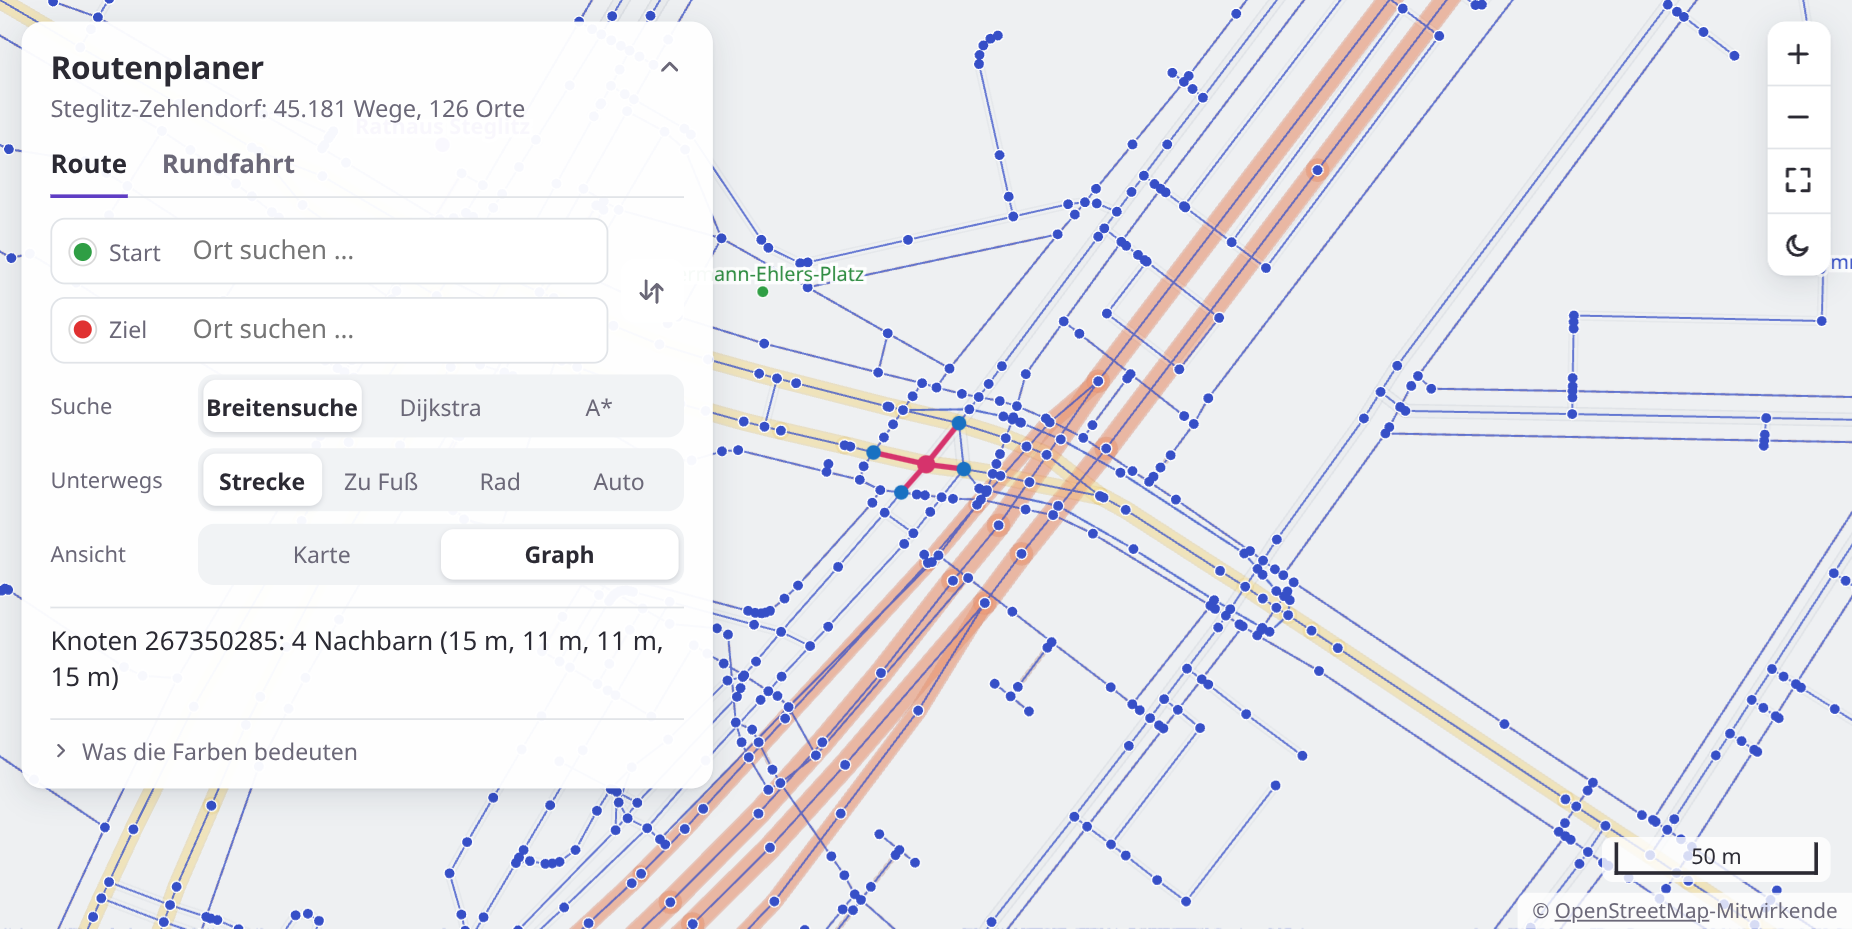
Eine Straße ist im Graphen mehr als ihre Kreuzungen: Wo sie eine Kurve macht, hat sie Punkte, die nur ihre Form zeichnen. Auch das sind Knoten, mit genau zwei Nachbarn.
Jetzt sucht dein Programm einen Weg. Die einfachste Suche geht vom Start aus wie eine Welle: erst zu allen Nachbarn des Starts, dann zu deren Nachbarn, dann zu den Nachbarn der Nachbarn. Das heißt Breitensuche. Die Knoten, die sie gefunden, aber noch nicht weiterverfolgt hat, stehen in einer Queue: Wer zuerst hineinkommt, ist zuerst wieder dran.
queue.shift nimmt den ersten Knoten heraus, queue << node stellt einen hinten an.
Damit die Suche am Ende den Weg kennt, merkt sie sich für jeden gefundenen Knoten, von welchem aus sie ihn gefunden hat: seinen Vorgänger. In previous steht für den Start nil, für jeden anderen gefundenen Knoten sein Vorgänger:
previous = { '11' => nil, '12' => '11', '21' => '11', '13' => '12', … }
queue.append(node) stellt einen Knoten hinten an. Vorne herausnehmen ginge mit queue.pop(0), aber das schiebt jedes Mal die ganze Liste nach vorne; schneller merkst du dir in first, welcher Knoten als Nächstes dran ist, und zählst weiter: node = queue[first], dann first += 1.
Damit die Suche am Ende den Weg kennt, merkt sie sich für jeden gefundenen Knoten, von welchem aus sie ihn gefunden hat: seinen Vorgänger. In previous steht für den Start None, für jeden anderen gefundenen Knoten sein Vorgänger:
previous = {'11': None, '12': '11', '21': '11', '13': '12', …}
So weiß die Suche auch, welche Knoten sie schon kennt: Ein Nachbar, der schon in previous steht, kommt nicht noch einmal in die Queue.
Ist die Suche am Ziel, geht der Weg vom Ziel aus rückwärts: zum Vorgänger des Ziels, zu dessen Vorgänger und so weiter, bis zum Start, der keinen Vorgänger hat. Das macht path_to. Weil du den Weg rückwärts findest, kommt jeder Knoten vorne dazu: path.unshift(node) in Ruby, path.insert(0, node) in Python.
Schreib path_to in routes.rb.
Schreib path_to in routes.py.
Die Breitensuche selbst, Schritt für Schritt:
previous der Start ohne Vorgänger.visited. Ist es das Ziel, bist du fertig.previous steht, bekommt den Knoten als Vorgänger und kommt hinten in die Queue.visited braucht die Suche selbst nicht: Die Seite zeigt damit, in welcher Reihenfolge die Suche die Knoten besucht hat. Zum Ausprobieren gibt es die Testkarte data/detour.tsv: Die Lindenstraße geht in fünf Kanten geradeaus vom Knoten 11 zum Knoten 16, der Eichenweg macht einen Bogen und braucht nur drei.
Schreib breadth_first in routes.rb.
Schreib breadth_first in routes.py.
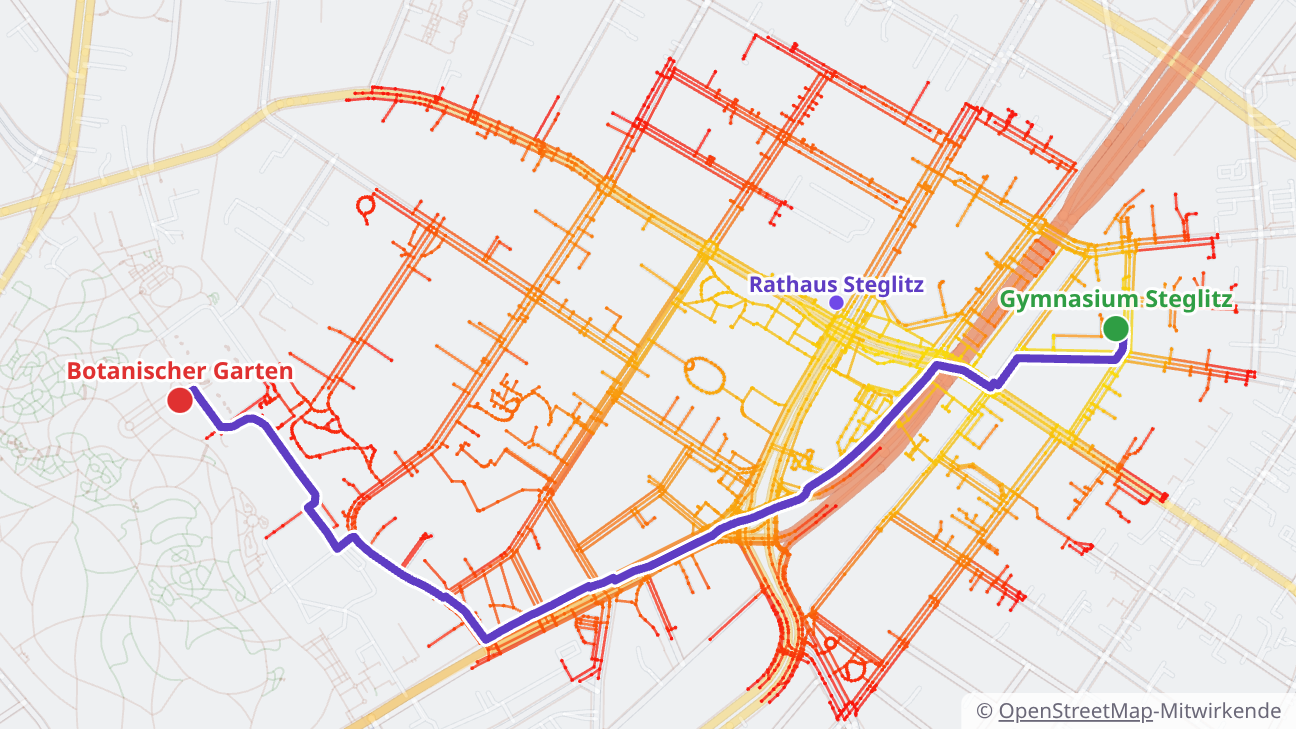
Starte den Server neu, wähle einen Start und ein Ziel und lass die Breitensuche suchen. Die Seite zeigt erst die Suche, jeden besuchten Knoten als Punkt, von Gelb (früh besucht) bis Rot (spät), und dann den Weg, den sie gefunden hat:
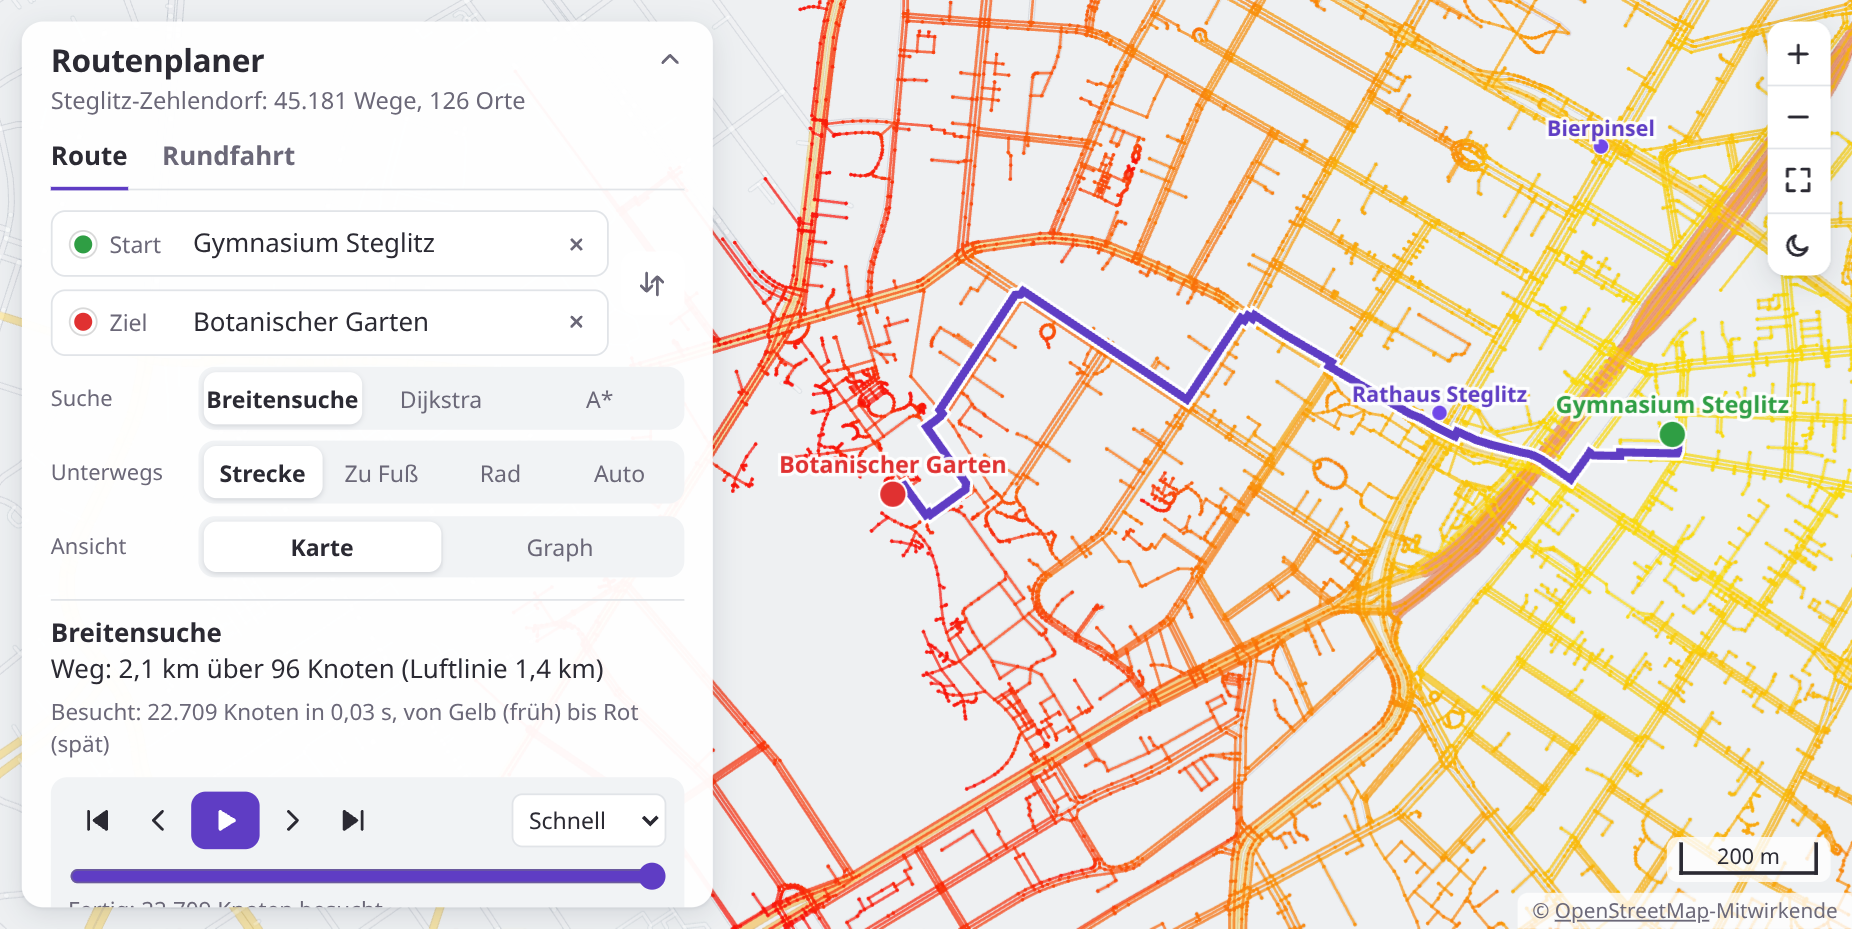
Die Welle breitet sich nach Kanten aus, nicht nach Metern: Im Botanischen Garten, wo die Wege viele kurze Kanten haben, kommt sie langsam voran, auf langen geraden Straßen schnell. Darum macht ihr Weg Zacken und Umwege.
Die Breitensuche findet den Weg mit den wenigsten Kanten. Warum ist das auf einer Karte oft nicht der kürzeste Weg?
Den kürzesten Weg in Metern findet die Suche von Edsger W. Dijkstra aus dem Jahr 1959. Sie nimmt als Nächstes nicht den Knoten, der am längsten wartet, sondern den, der vom Start aus am nächsten liegt. Dafür merkt sie sich für jeden gefundenen Knoten, wie weit es bis zu ihm ist, auf dem besten Weg, den sie bis jetzt kennt:
metres sagt, wie weit jeder gefundene Knoten vom Start weg ist, previous wieder seinen Vorgänger, frontier die Knoten, die gefunden, aber noch nicht dran waren, mit ihrem Abstand. Am Anfang steht in allen dreien nur der Start, mit 0 Metern und ohne Vorgänger.frontier den Knoten mit dem kleinsten Abstand und schreib ihn in visited. Ist es das Ziel, bist du fertig.frontier.frontier nicht leer ist.Warum stimmt der Abstand, wenn ein Knoten dran ist? Alle anderen in frontier sind weiter weg, und jeder Umweg über sie macht den Weg nur länger: Kanten sind nie kürzer als 0 Meter.
frontier.min_by { |_id, m| m } gibt den Knoten mit dem kleinsten Abstand, als Paar aus ID und Metern. frontier.delete(node) nimmt ihn heraus. Am Ende baut path_to den Weg, genau wie bei der Breitensuche.
min(frontier, key=frontier.get) gibt den Knoten mit dem kleinsten Abstand, frontier.pop(node) nimmt ihn heraus und gibt seinen Abstand. Am Ende baut path_to den Weg, genau wie bei der Breitensuche.
Schreib dijkstra in routes.rb.
Schreib dijkstra in routes.py.
Starte den Server neu und suche denselben Weg noch einmal, jetzt mit »Dijkstra«:
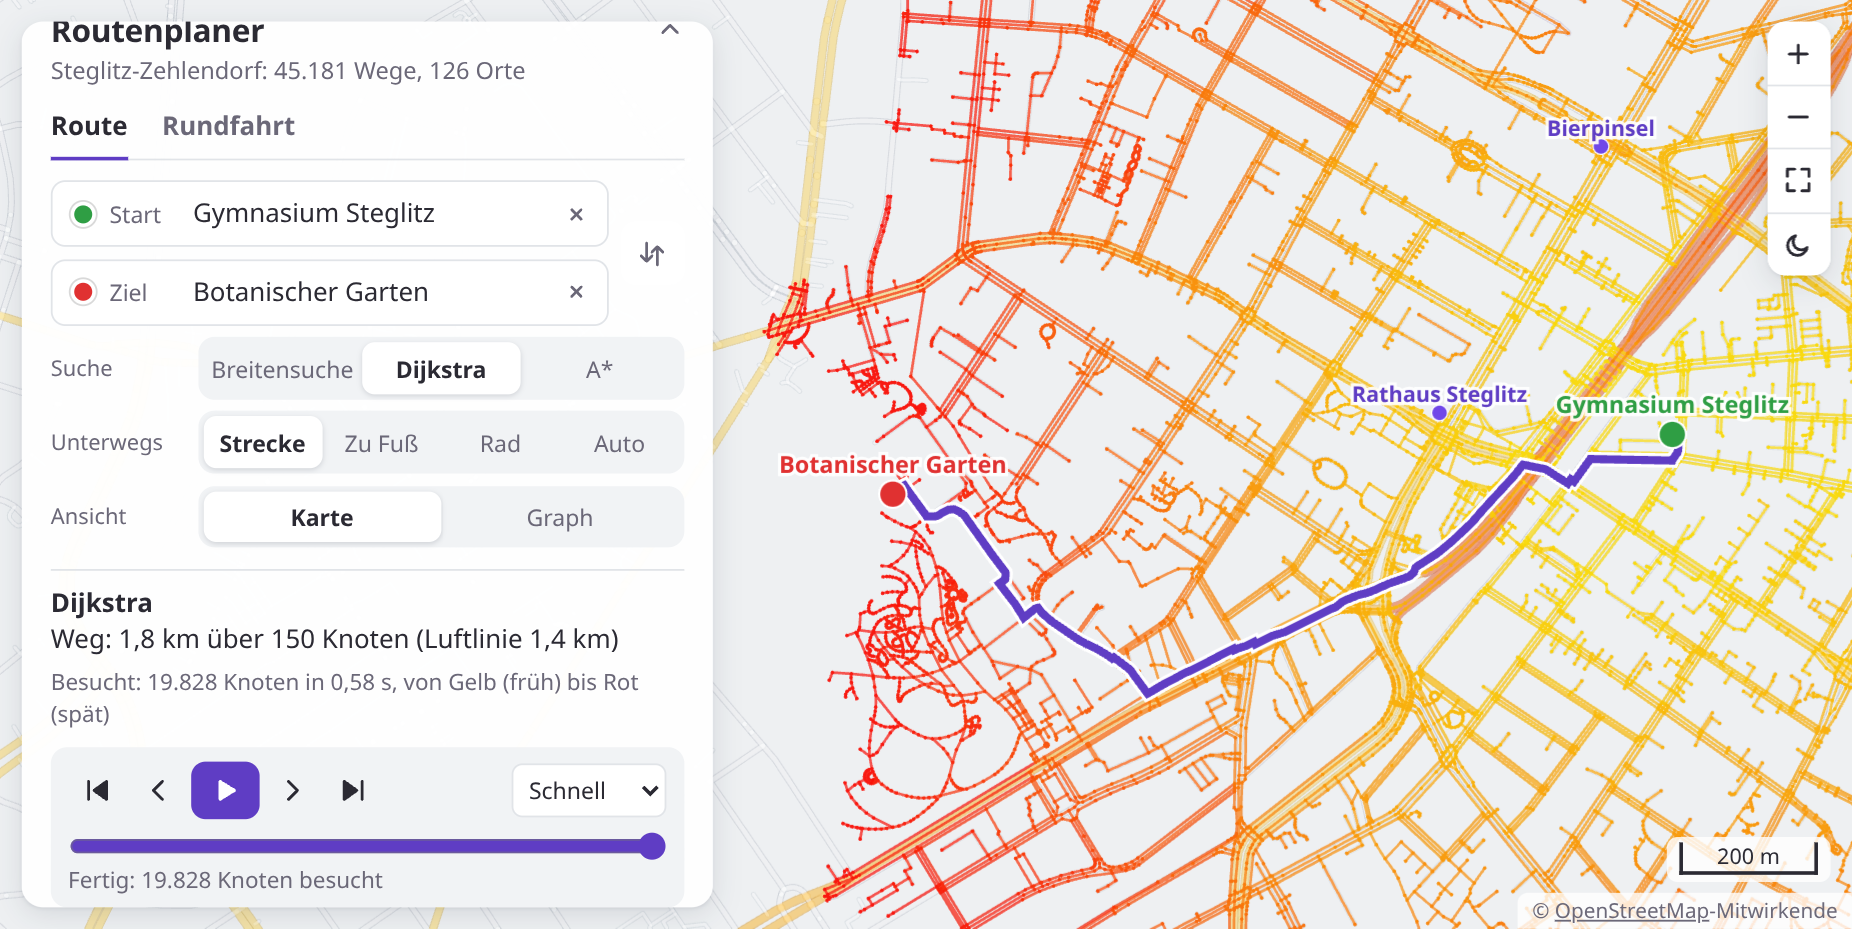
Jetzt breitet sich die Welle in Metern aus, wie Ringe um den Start. Der Weg ist 1,8 km lang statt 2,1 km: Er hat mehr Knoten, aber keine Zacken. Wie verschieden die beiden Wege sein können, zeigt erst ein weiter Weg.
Mit dem Schieber unter dem Ergebnis siehst du dir die Suche Schritt für Schritt an: ▶ spielt sie ab, ‹ und › gehen einen Knoten zurück und vor, das Tempo »Langsam« zeigt jeden einzelnen. Hast du angehalten, bleibt der Schritt stehen, wenn du die andere Suche wählst. So vergleichst du beide an derselben Stelle.
Probier einen weiten Weg, zur Pfaueninsel ganz im Westen. Dahin kommt man nur mit der Fähre, und auch die ist ein Weg der Karte:
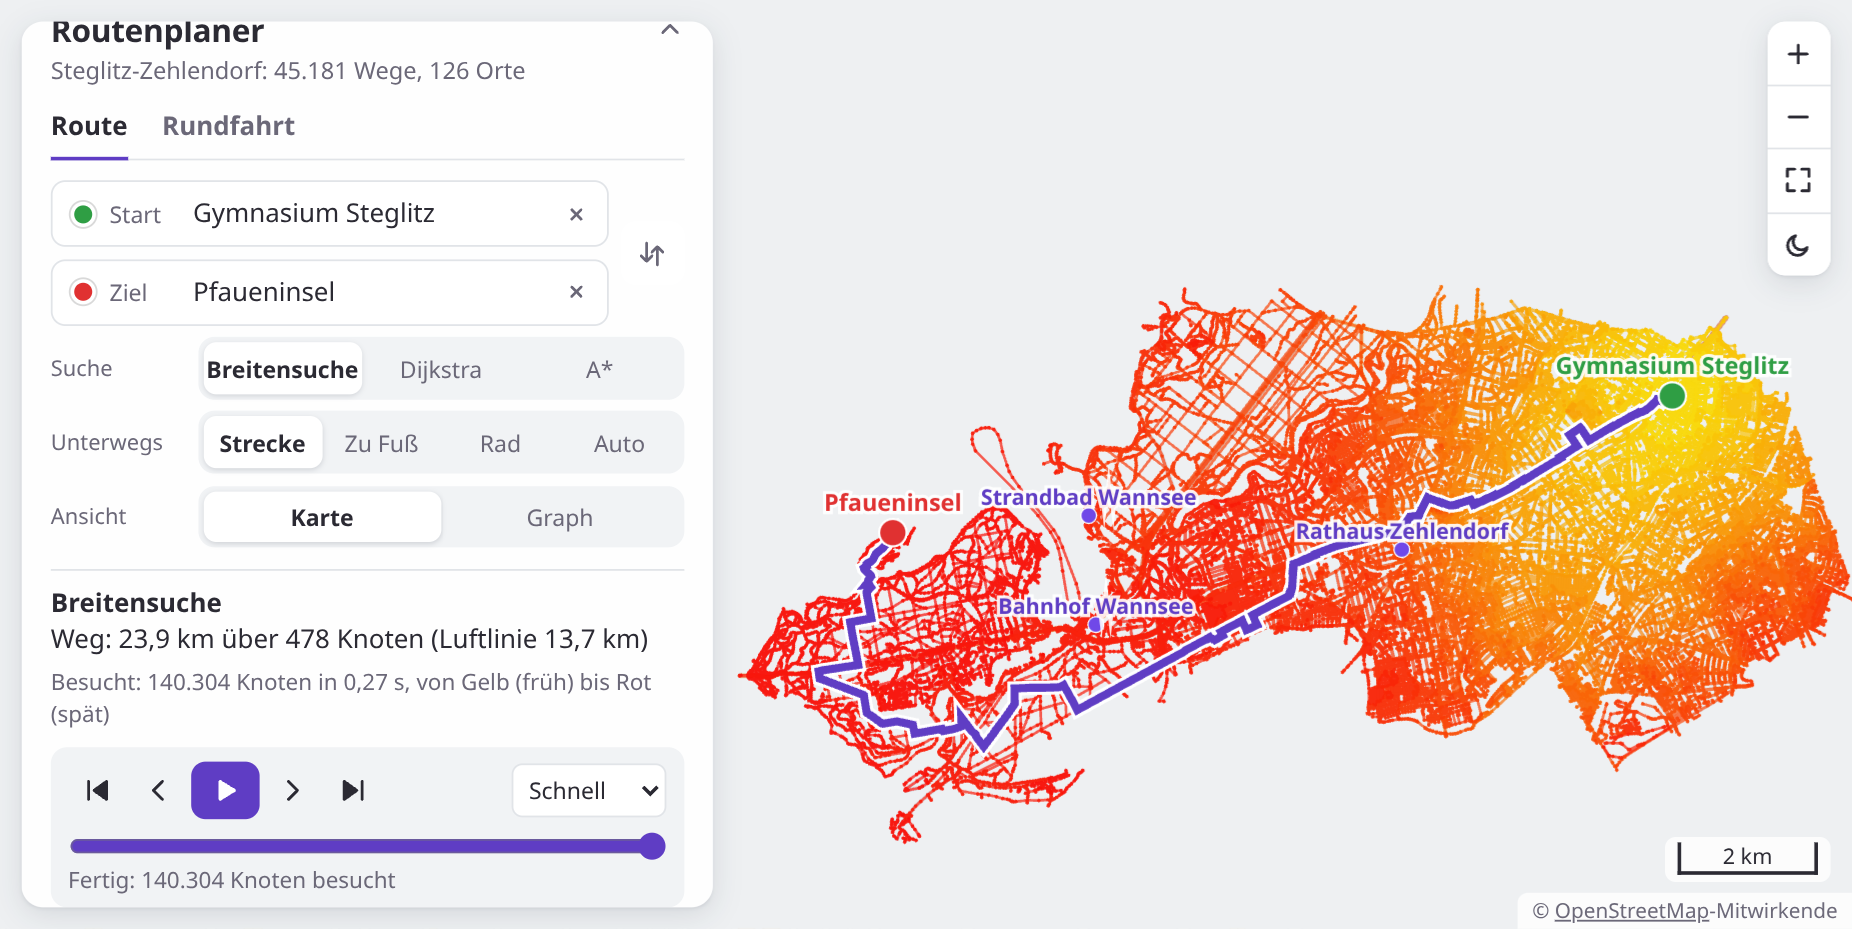
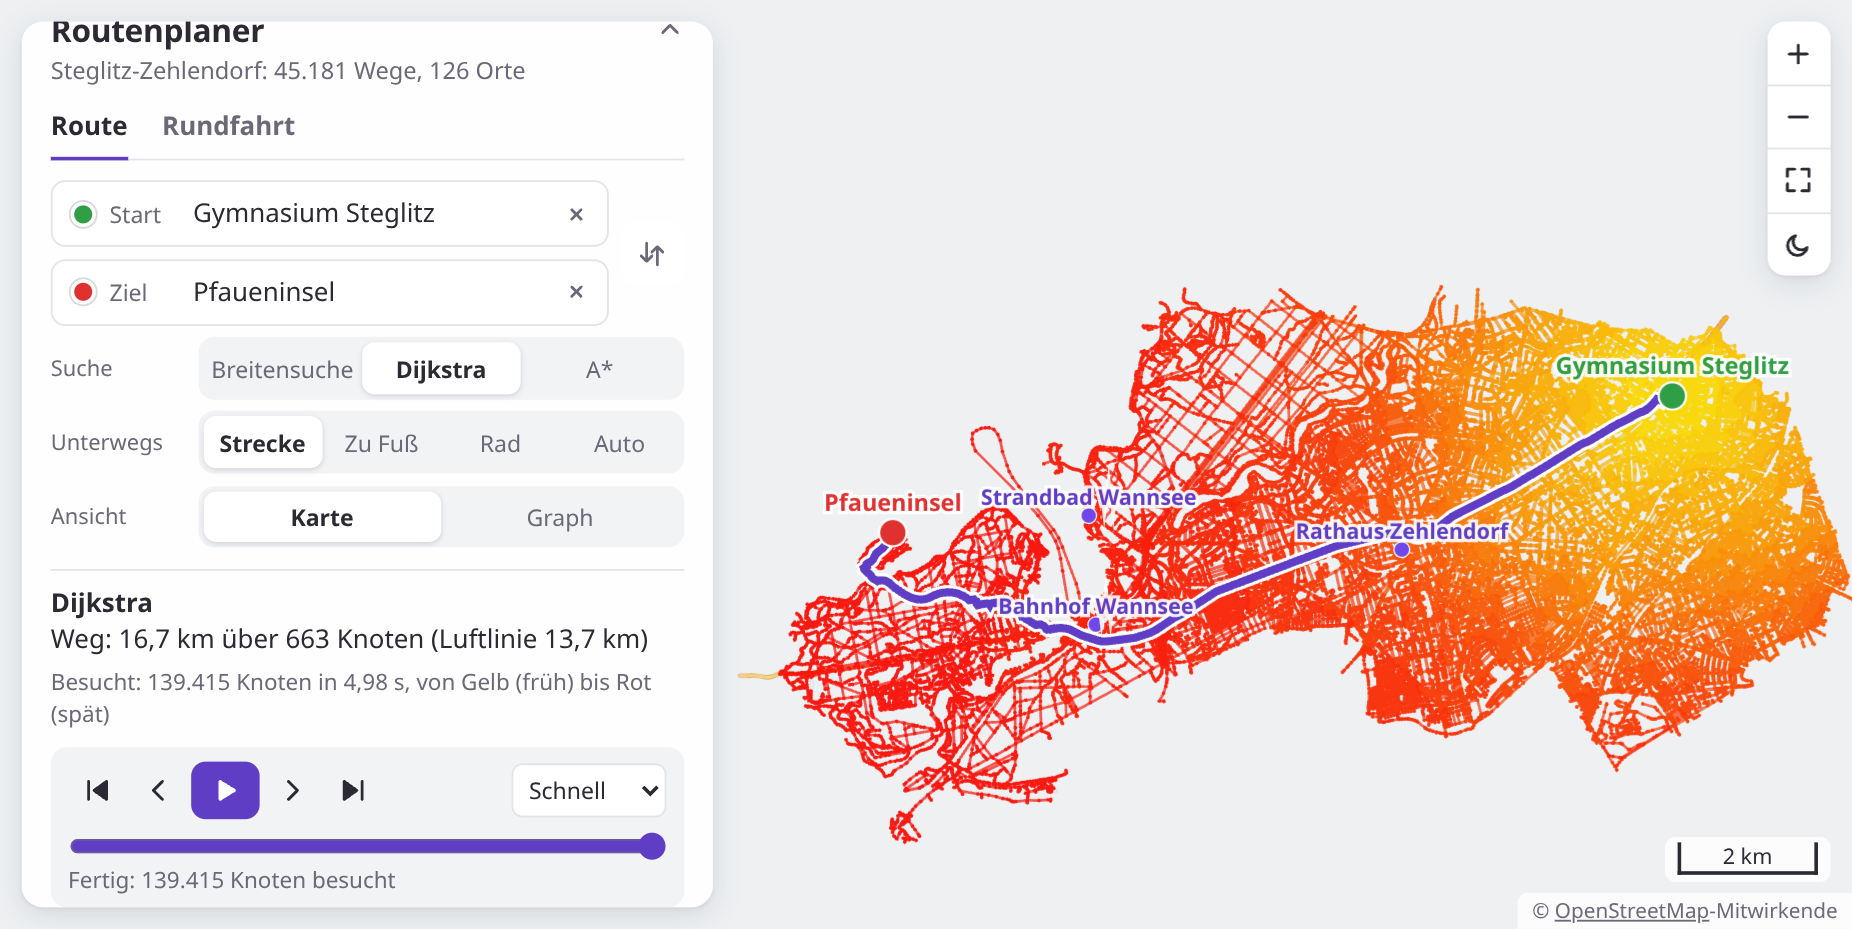
Die Breitensuche macht gut 7 Kilometer Umweg. Dijkstra findet den kürzesten Weg, aber schau auf die Zeit: ein paar Sekunden statt Bruchteilen davon. Beide besuchen fast den ganzen Bezirk, der Unterschied ist die Suche nach dem kleinsten Abstand: Sie geht bei jedem Schritt durch die ganze frontier, und die wird groß. Wie es schneller geht, kommt als Nächstes.
Dijkstra sucht bei jedem Schritt in der ganzen frontier nach dem kleinsten Abstand. Stehen dort tausend Knoten, sind das tausend Vergleiche, bei jedem der hunderttausend Schritte. Schneller geht es mit einer Priority Queue: Man legt Werte mit einer Priorität hinein und bekommt immer den mit der kleinsten heraus, ohne alle anzusehen.
Ein binärer Heap macht das so: Die Einträge stehen in einem Array, aber man denkt sie sich als Baum. Die Kinder des Eintrags an der Stelle i stehen an den Stellen 2 * i + 1 und 2 * i + 2, sein Elternteil an der Stelle (i - 1) / 2. Und es gilt immer: Kein Kind ist kleiner als sein Elternteil. Ganz oben, an der Stelle 0, steht deshalb das Kleinste.
Beides braucht nur so viele Schritte, wie der Baum hoch ist: bei hunderttausend Einträgen 17.
In routes.rb gibt es die Klasse MinHeap schon, mit dem Array @items für Paare aus Priorität und Wert. Es fehlen push und pop.
In routes.py gibt es die Klasse MinHeap schon, mit der Liste self.items für Paare aus Priorität und Wert. Es fehlen push und pop. Python hat für so etwas das Modul heapq; hier baust du den Heap selbst, damit du siehst, wie er arbeitet.
Schreib push und pop der Klasse MinHeap in routes.rb.
Schreib push und pop der Klasse MinHeap in routes.py.
Dann bekommt dijkstra den Heap statt frontier. Ein Knoten kann jetzt mehrmals im Heap stehen: Findet die Suche einen kürzeren Weg zu ihm, legt sie ihn mit dem neuen Abstand noch einmal hinein, statt den alten Eintrag zu suchen. Kommt später der alte Eintrag heraus, war der Knoten schon dran, und die Suche überspringt ihn. Dafür merkt sie sich in done, welche Knoten fertig sind:
until heap.empty?
    so_far, node = heap.pop
    next if done[node]

    done[node] = true
    visited << node
    break if node == goal

    graph[:edges][node].each do |neighbour, length|
        total = so_far + length
        next if costs.key?(neighbour) && costs[neighbour] <= total

        costs[neighbour] = total
        previous[neighbour] = node
        heap.push(total, neighbour)
    end
end
while not heap.empty():
    so_far, node = heap.pop()
    if node in done:
        continue
    done.add(node)
    visited.append(node)
    if node == goal:
        break
    for neighbour, length in graph['edges'].get(node, []):
        total = so_far + length
        if neighbour in costs and costs[neighbour] <= total:
            continue
        costs[neighbour] = total
        previous[neighbour] = node
        heap.push(total, neighbour)
Prüfe dijkstra mit dem Knopf oben noch einmal, starte den Server neu und such den Weg zur Pfaueninsel wieder mit Dijkstra. Derselbe Weg, dieselben besuchten Knoten, aber statt ein paar Sekunden noch knapp eine.
Dijkstra sucht in alle Richtungen gleich, auch weg vom Ziel. Dabei weiß die Karte, wo das Ziel liegt. A* (gesprochen »A-Stern«) nutzt das: Die Priorität eines Knotens ist nicht nur der Weg bis zu ihm, sondern der Weg bis zu ihm plus eine Schätzung für den Rest, die Luftlinie zum Ziel. Knoten in Richtung des Ziels kommen so früher dran, Knoten in der falschen Richtung später oder nie.
$$\text{Priorität} = \text{Weg vom Start bis zum Knoten} + \text{Luftlinie vom Knoten zum Ziel}$$
Der Weg bleibt der kürzeste, solange die Schätzung nie zu groß ist: Kein Weg auf der Straße ist kürzer als die Luftlinie. Sonst ist A* genau Dijkstra, mit dem Heap. Nur kommt beim Hineinlegen die Schätzung dazu, und der Abstand eines Knotens steht in costs, nicht in der Priorität:
heap.push(total + estimate.(neighbour), neighbour)
estimate ist eine kleine Funktion für die Luftlinie, mit deinem distance und der Lage des Ziels, graph[:nodes][goal]. In Ruby schreibst du sie als Lambda: estimate = ->(id) { … }, aufgerufen mit estimate.(id).
heap.push(total + estimate(neighbour), neighbour)
estimate ist eine kleine Funktion für die Luftlinie, mit deinem distance und der Lage des Ziels, graph['nodes'][goal]. Du kannst sie innerhalb von a_star mit def schreiben.
Schreib a_star in routes.rb.
Schreib a_star in routes.py.
Wie viel A* spart, zeigt ein Weg quer durch die Stadt, zum Brandenburger Tor. Dafür braucht der Server drei Bezirke: Steglitz-Zehlendorf, Tempelhof-Schöneberg und Mitte. Halte ihn an und starte ihn so:
AREA=steglitz-zehlendorf,tempelhof-schoeneberg,mitte ruby server.rb
AREA=steglitz-zehlendorf,tempelhof-schoeneberg,mitte python3 server.py
Die beiden anderen Bezirke lädt er beim ersten Mal herunter. Der Graph hat dann fast 400 000 Knoten; das Lesen dauert ein paar Sekunden länger.
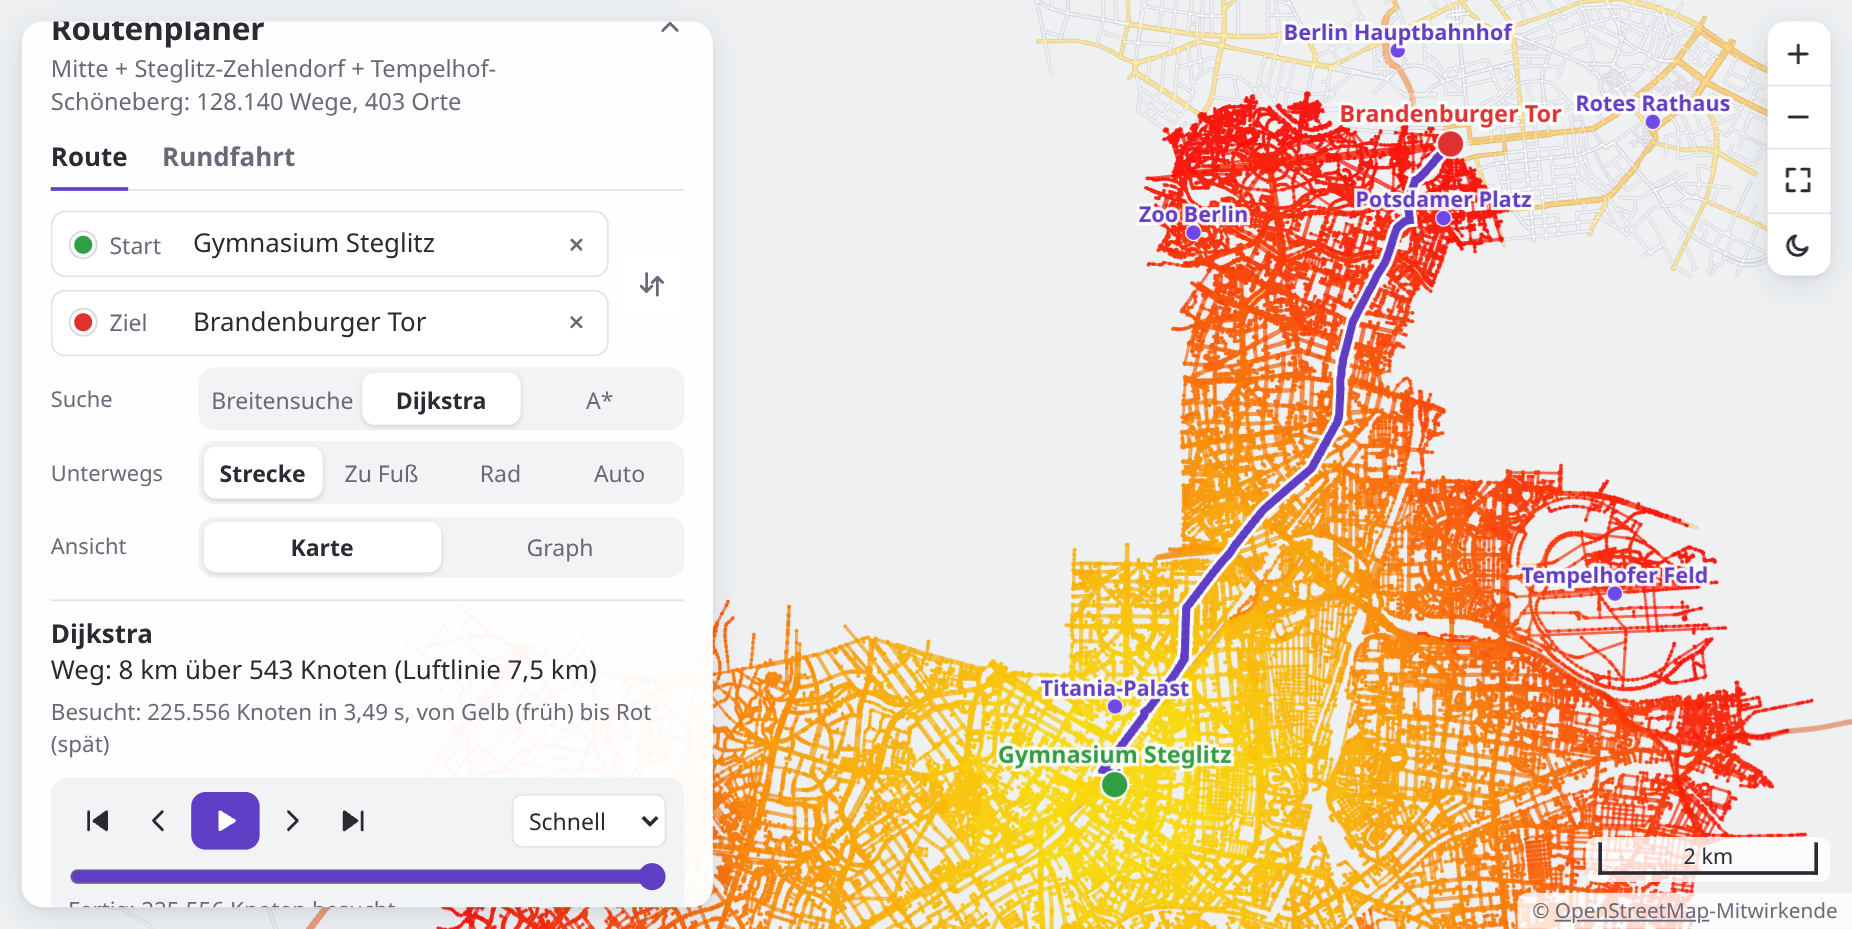
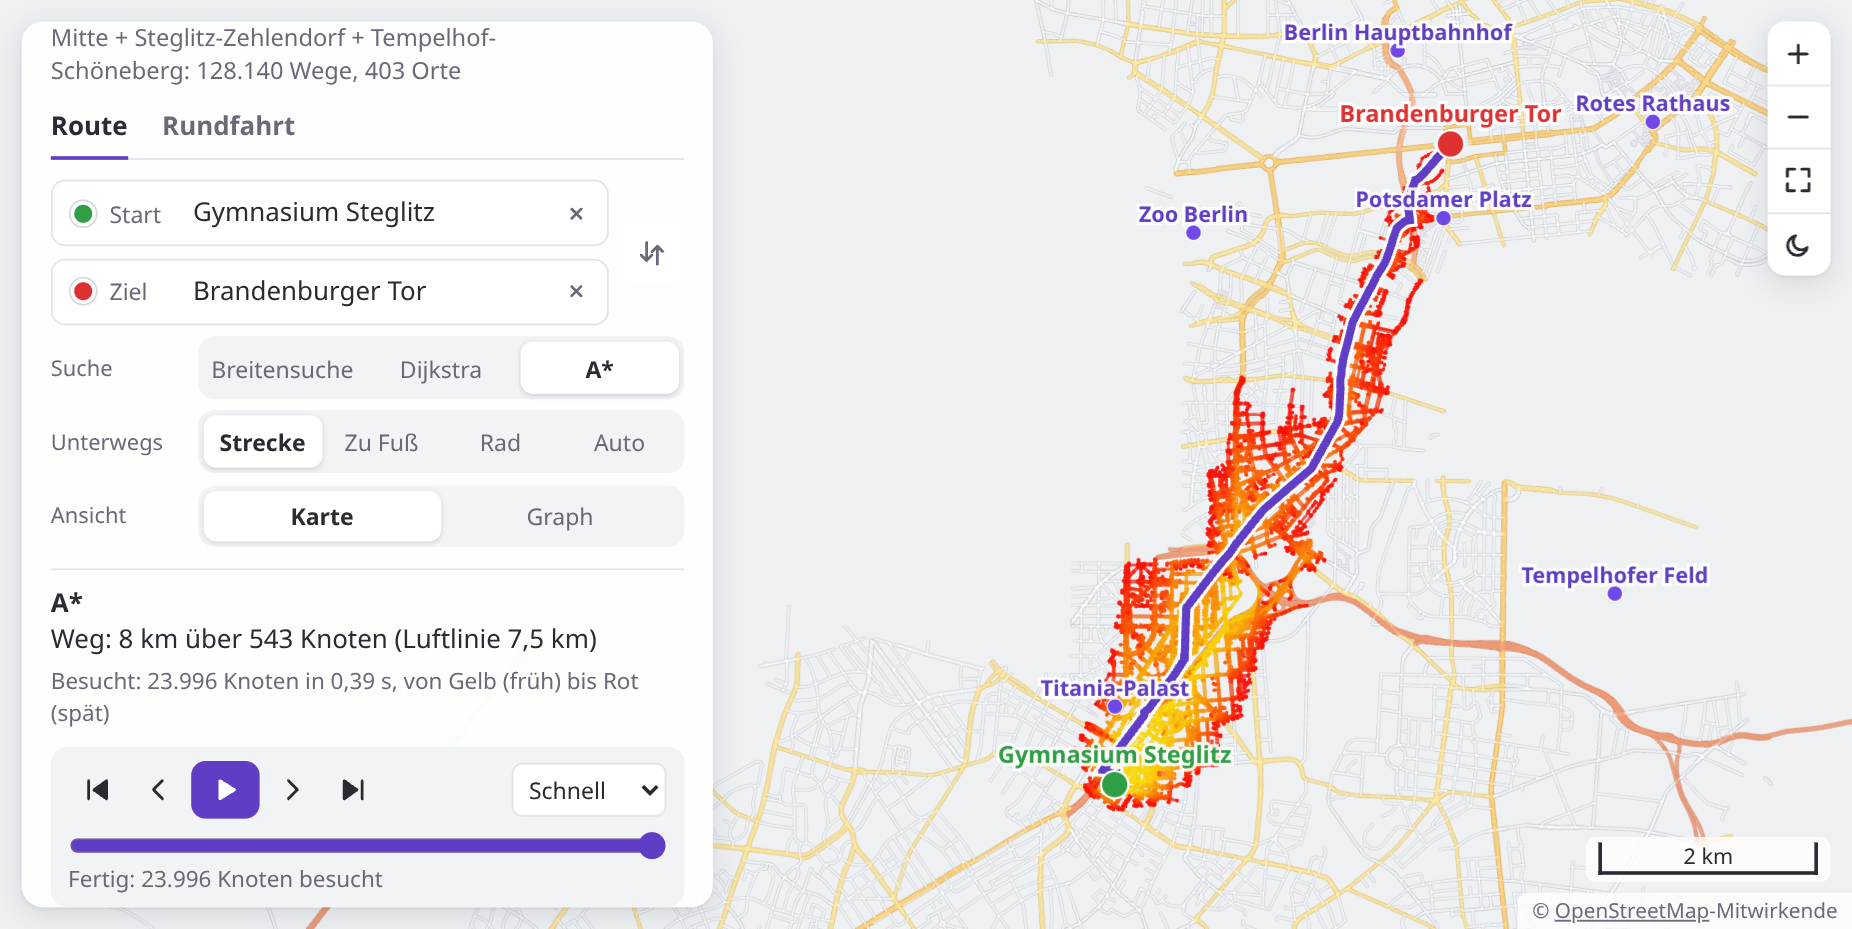
Derselbe Weg, 8 km, aber A* besucht nur ein Zehntel der Knoten: ein Band zum Ziel hin statt eines Kreises, und ist darum zehnmal so schnell fertig. Mit AREA=berlin hast du die ganze Stadt, 1,3 Millionen Knoten. Das Lesen dauert dann gut eine halbe Minute, aber A* findet auch dort einen Weg in Sekunden.
Bisher ist der kürzeste Weg gemeint, in Metern. Wer mit dem Auto fährt, will aber den schnellsten, und darf nicht überall fahren: nicht auf Fußwegen, nicht gegen Einbahnstraßen. Wer zu Fuß geht, kommt auf der Autobahn nicht weit. Dafür bekommt jede Art zu reisen ihren eigenen Graphen: nur mit den Wegen, die man so benutzen darf, und an jeder Kante, wie viele Sekunden man für sie braucht.
Wie schnell man wo vorankommt, steht in routes.rb in der Tabelle SPEEDS, in km/h: SPEEDS['car']['residential'] ist 25, in einer Wohnstraße fährt man mit dem Auto im Schnitt 25 km/h. Fehlt eine Art von Weg in der Tabelle, darf man ihn so nicht benutzen.
Wie schnell man wo vorankommt, steht in routes.py in der Tabelle SPEEDS, in km/h: SPEEDS['car']['residential'] ist 25, in einer Wohnstraße fährt man mit dem Auto im Schnitt 25 km/h. Fehlt eine Art von Weg in der Tabelle, darf man ihn so nicht benutzen.
build_travel_graph ist fast build_graph, mit drei Unterschieden:
SPEEDS[mode] fehlt, kommt nicht in den Graphen.yes gibt es nur die Kante in Richtung der Punkte, bei -1 nur die zurück. Zu Fuß und mit dem Rad gibt es beide.Dazu gehört in den Graphen noch fastest, das größte Tempo der Tabelle in Metern je Sekunde. A* braucht es: Die Luftlinie in Metern geteilt durch fastest ist eine Schätzung in Sekunden, die nie zu groß ist, denn schneller als mit dem größten Tempo kommt man nirgends voran. Teile darum in a_star die Luftlinie durch fastest, wenn der Graph es hat, und sonst durch 1.
Schreib build_travel_graph in routes.rb.
Schreib build_travel_graph in routes.py.
Dijkstra und A* musst du sonst nicht ändern: Sie zählen zusammen, was an den Kanten steht, ob Meter oder Sekunden. Starte den Server neu. Über den Suchen auf der Seite wählst du jetzt, wie gereist wird:
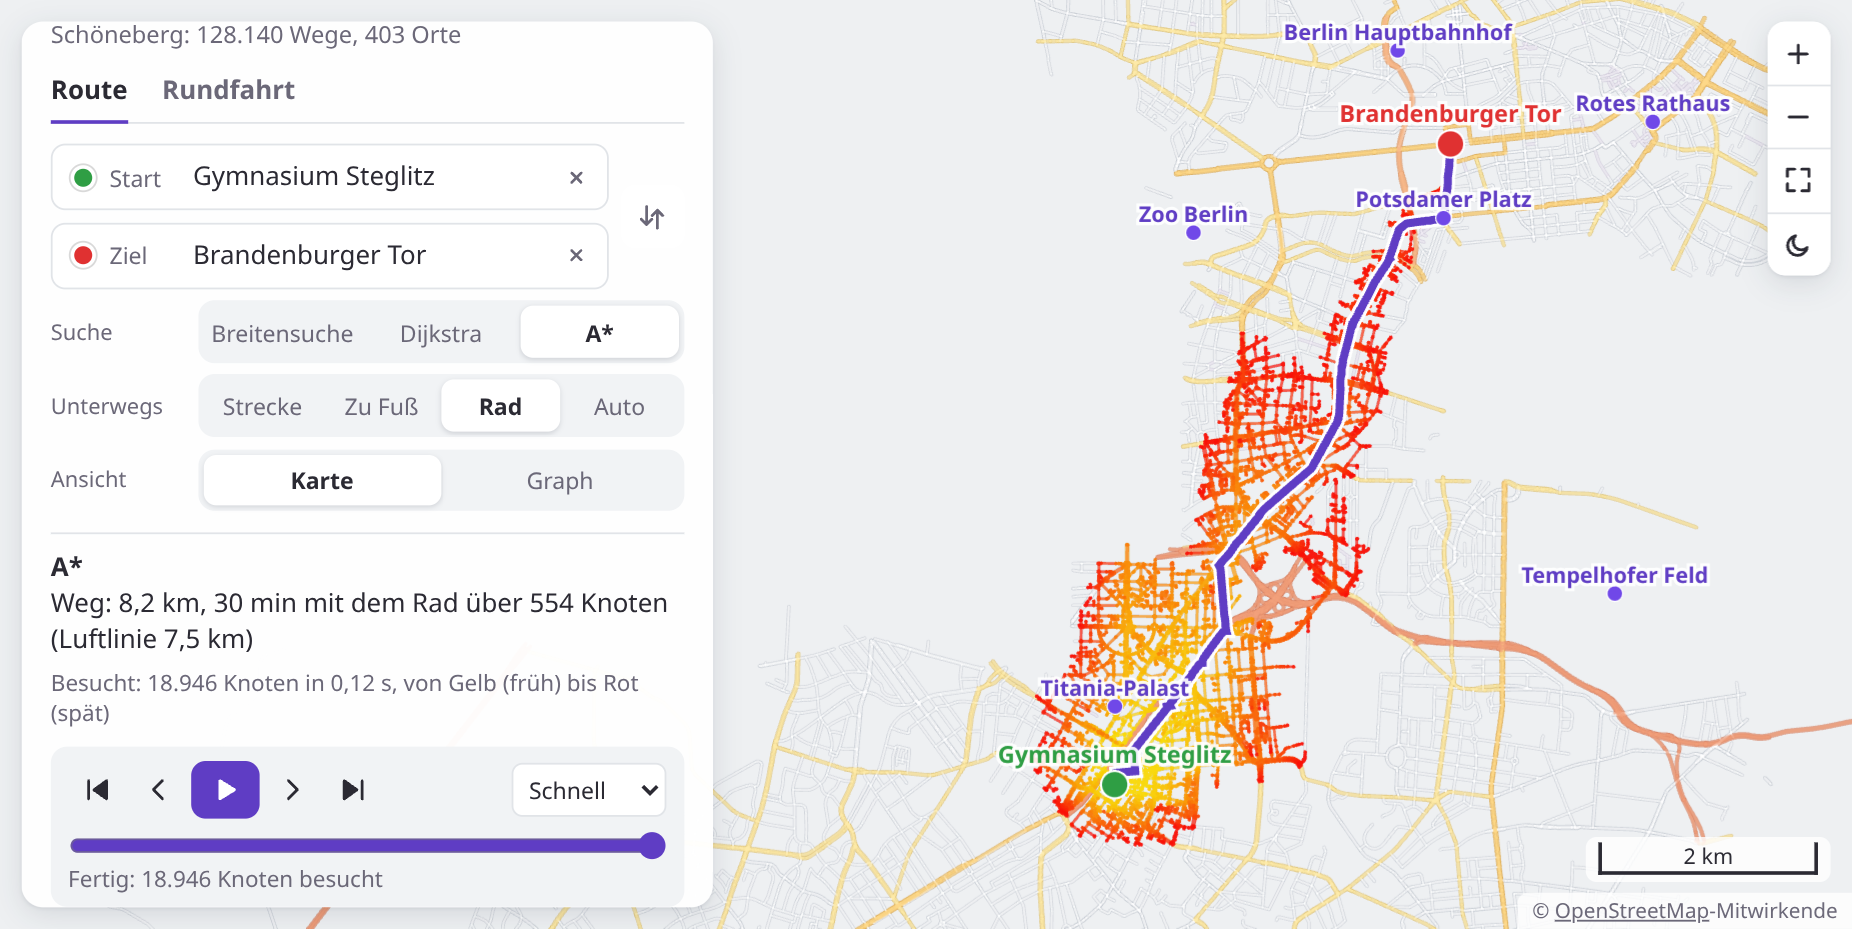
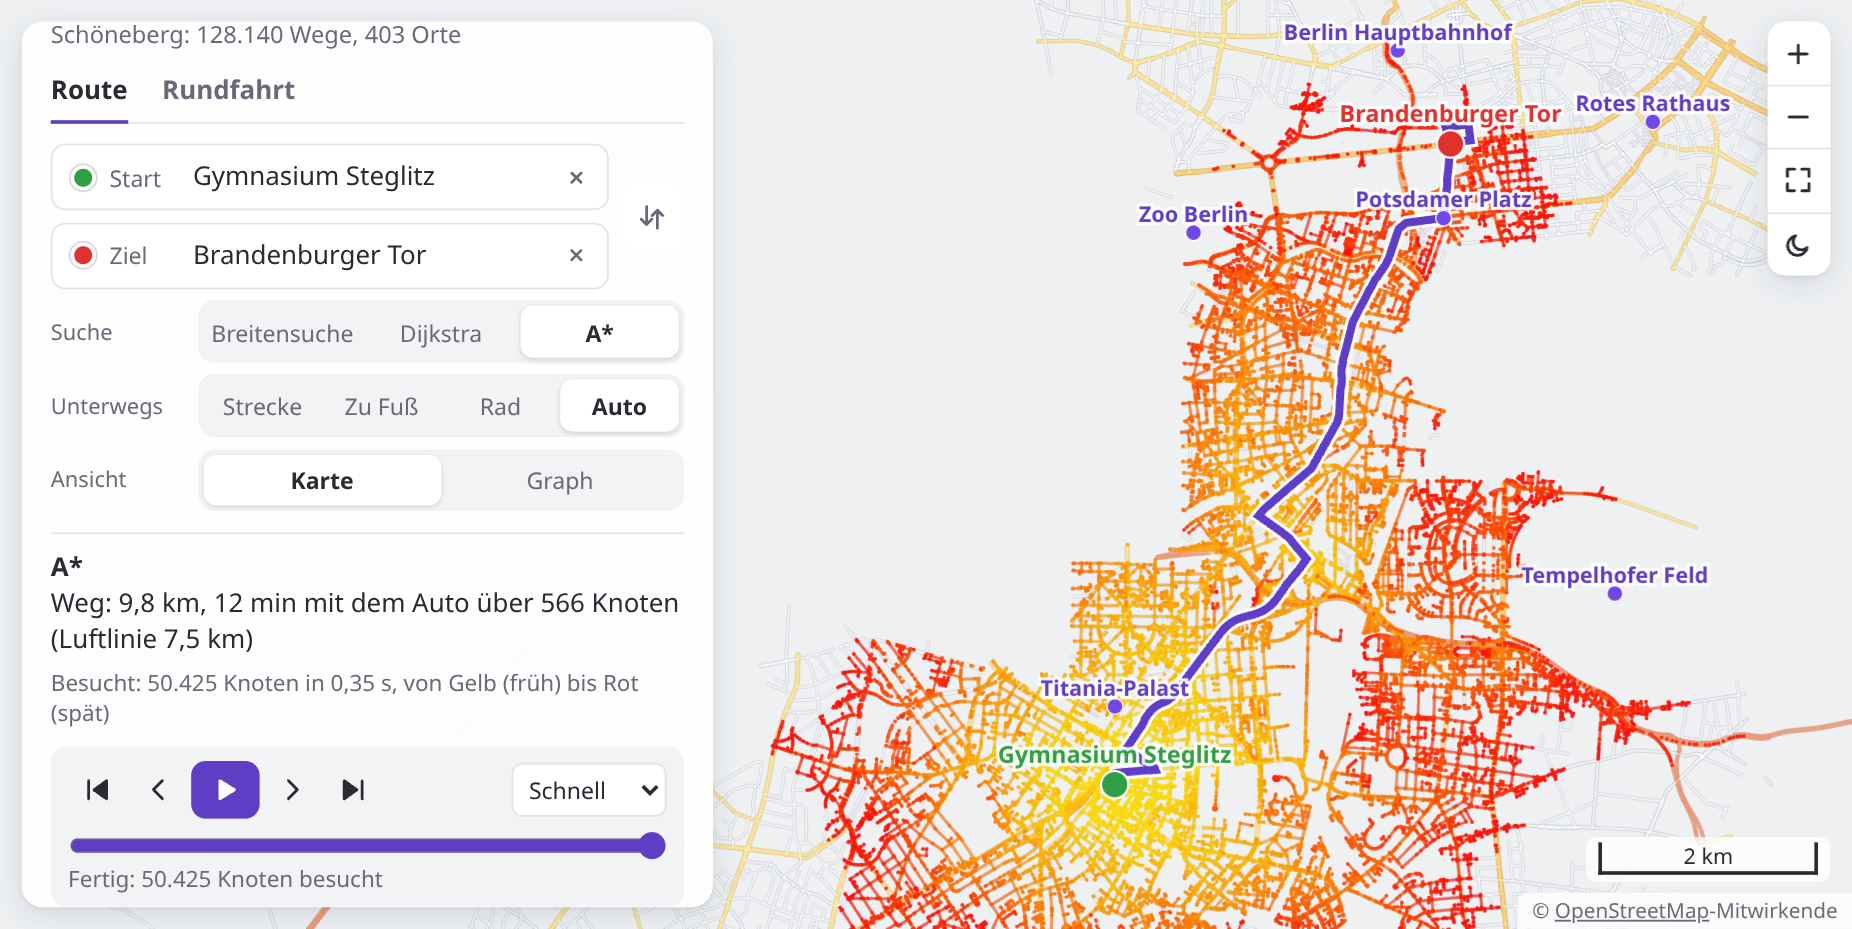
Schau dir an, wie viele Knoten A* mit dem Auto besucht: Zu Fuß ist es ein Zehntel dessen, was Dijkstra besucht, mit dem Auto fast die Hälfte. Die Schätzung rechnet mit 90 km/h, dem Tempo auf der Autobahn, aber in der Stadt kommt man viel langsamer voran. Je weiter die Schätzung unter dem wirklichen Weg liegt, desto weniger hilft sie.
Jetzt besuchst du mehrere Orte und kommst am Ende zurück: eine Stadtrundfahrt zu den Sehenswürdigkeiten in Mitte. In welcher Reihenfolge ist sie am kürzesten? Das ist das Problem des Handlungsreisenden, eines der berühmtesten der Informatik.
Die Seite rechnet erst mit deiner Suche aus, wie weit es von jedem Ort zu jedem anderen ist. Bei acht Orten sind das 56 Suchen. Heraus kommt eine Tabelle costs: costs[i][j] ist der Weg vom Ort i zum Ort j. Damit arbeiten deine Funktionen, die Karte brauchen sie nicht mehr. Eine Reihenfolge ist ein Array der Nummern der Orte, das mit 0 beginnt, dem Startort. Am Ende geht es zu ihm zurück.
costs = [[0, 10, 5, 2, 14],     Reihenfolge [0, 3, 2, 1, 4]:
         [10, 0, 9, 8, 4],      0 → 3 → 2 → 1 → 4 → 0
         [5, 9, 0, 7, 11],      2 + 7 + 9 + 4 + 14 = 36
         [2, 8, 7, 0, 12],
         [14, 4, 11, 12, 0]]
Schreib tour_length in routes.rb.
Schreib tour_length in routes.py.
Die sichere Art, die beste Reihenfolge zu finden: alle ausprobieren. Der Startort steht fest, die anderen kommen in jeder möglichen Reihenfolge dahinter. Bei fünf Orten sind das 4 · 3 · 2 · 1 = 24, bei neun schon 40 320, bei zwanzig mehr, als ein Computer in deinem Leben ausprobieren kann.
(1...costs.size).to_a.permutation gibt alle Reihenfolgen der Orte außer dem Startort, min_by die mit der kleinsten Länge.
itertools.permutations(range(1, len(costs))) gibt alle Reihenfolgen der Orte außer dem Startort, min mit key= die mit der kleinsten Länge.
Schreib best_tour in routes.rb.
Schreib best_tour in routes.py.
Schneller, aber ohne Garantie: der nächste Nachbar. Vom Startort aus geht es immer zu dem Ort, der am nächsten liegt und an dem die Rundfahrt noch nicht war.
Schreib nearest_tour in routes.rb.
Schreib nearest_tour in routes.py.
Der nächste Nachbar macht oft einen Fehler: Am Anfang nimmt er die kurzen Wege, am Ende bleiben die langen übrig, und die Rundfahrt kreuzt sich selbst. 2-opt repariert das: Es nimmt ein Stück der Reihenfolge und dreht es um. Wird die Rundfahrt dadurch kürzer, bleibt es dabei. Das probiert es für jedes Stück, und so lange, bis kein Umdrehen mehr hilft.
[0, 3, 2, 1, 4]   36
[0, 3, 4, 1, 2]   32   das Stück 2, 1, 4 umgedreht
[0, 3, 1, 4, 2]   30   und dann das Stück 4, 1
Schreib improve_tour in routes.rb.
Schreib improve_tour in routes.py.
Wechsle auf der Seite zu »Rundfahrt«, füge Orte hinzu und probiere die drei Arten aus. Der erste Ort ist der Anfang. Ist die Rundfahrt berechnet, stehen die Orte in der Liste und auf der Karte in der Reihenfolge, in der sie besucht werden:
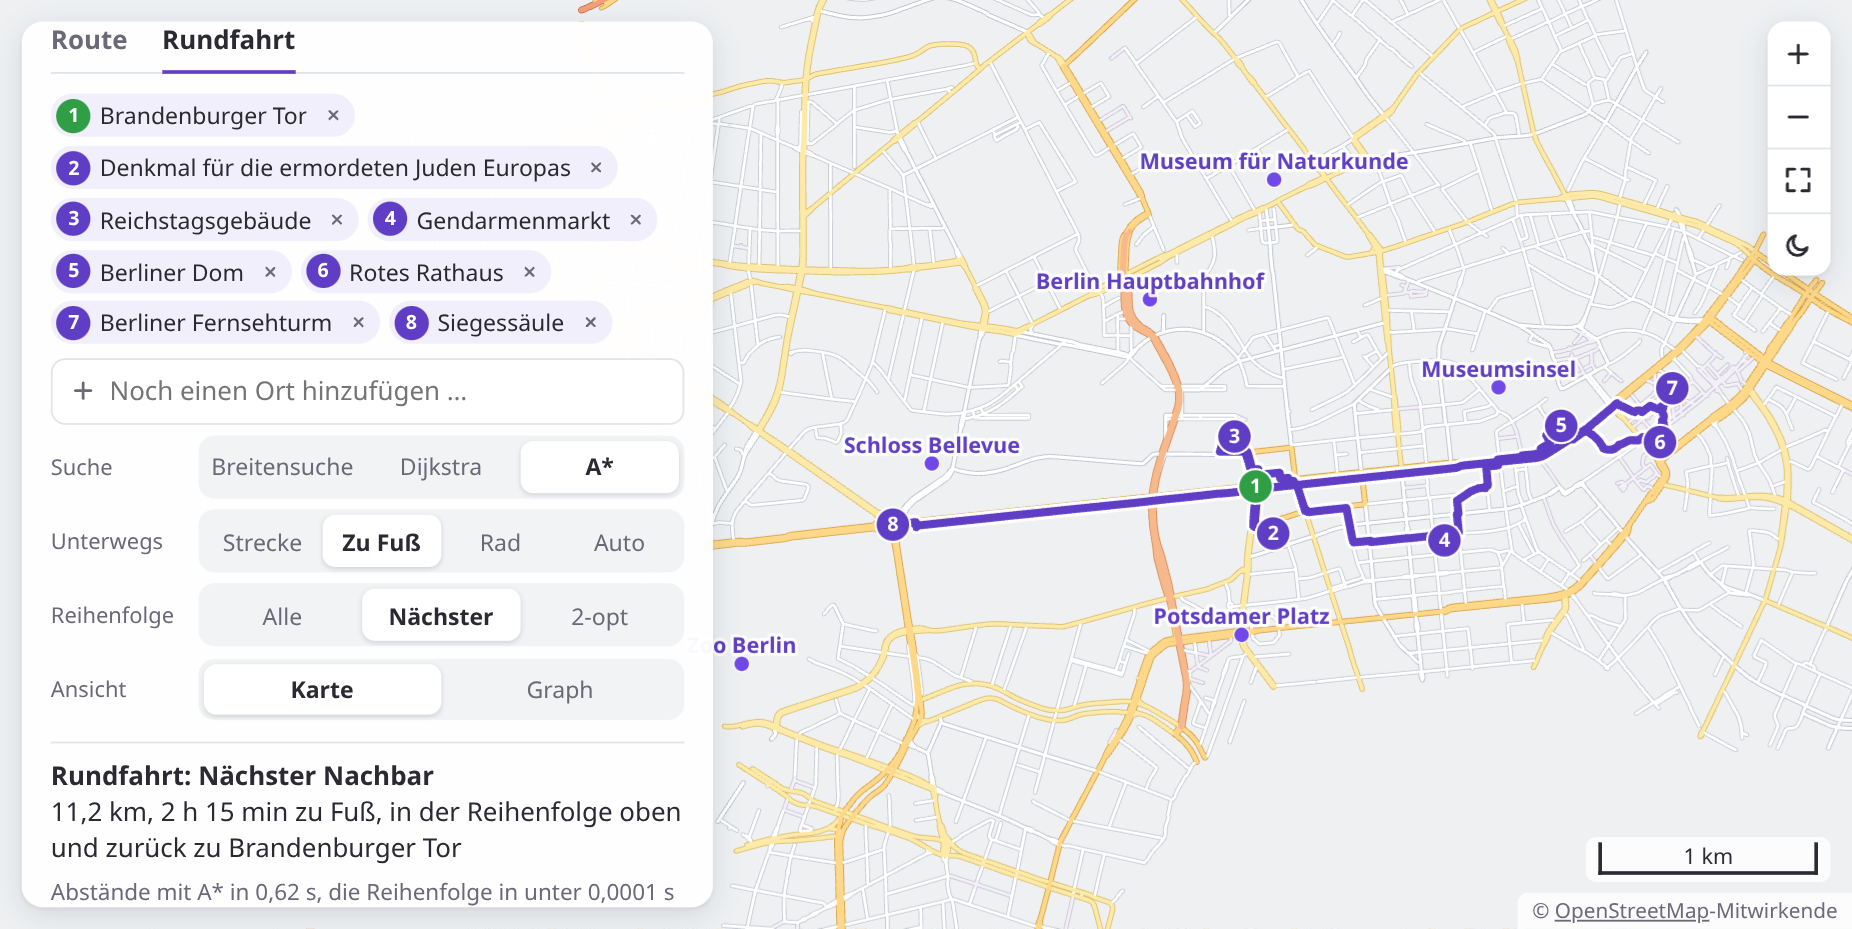
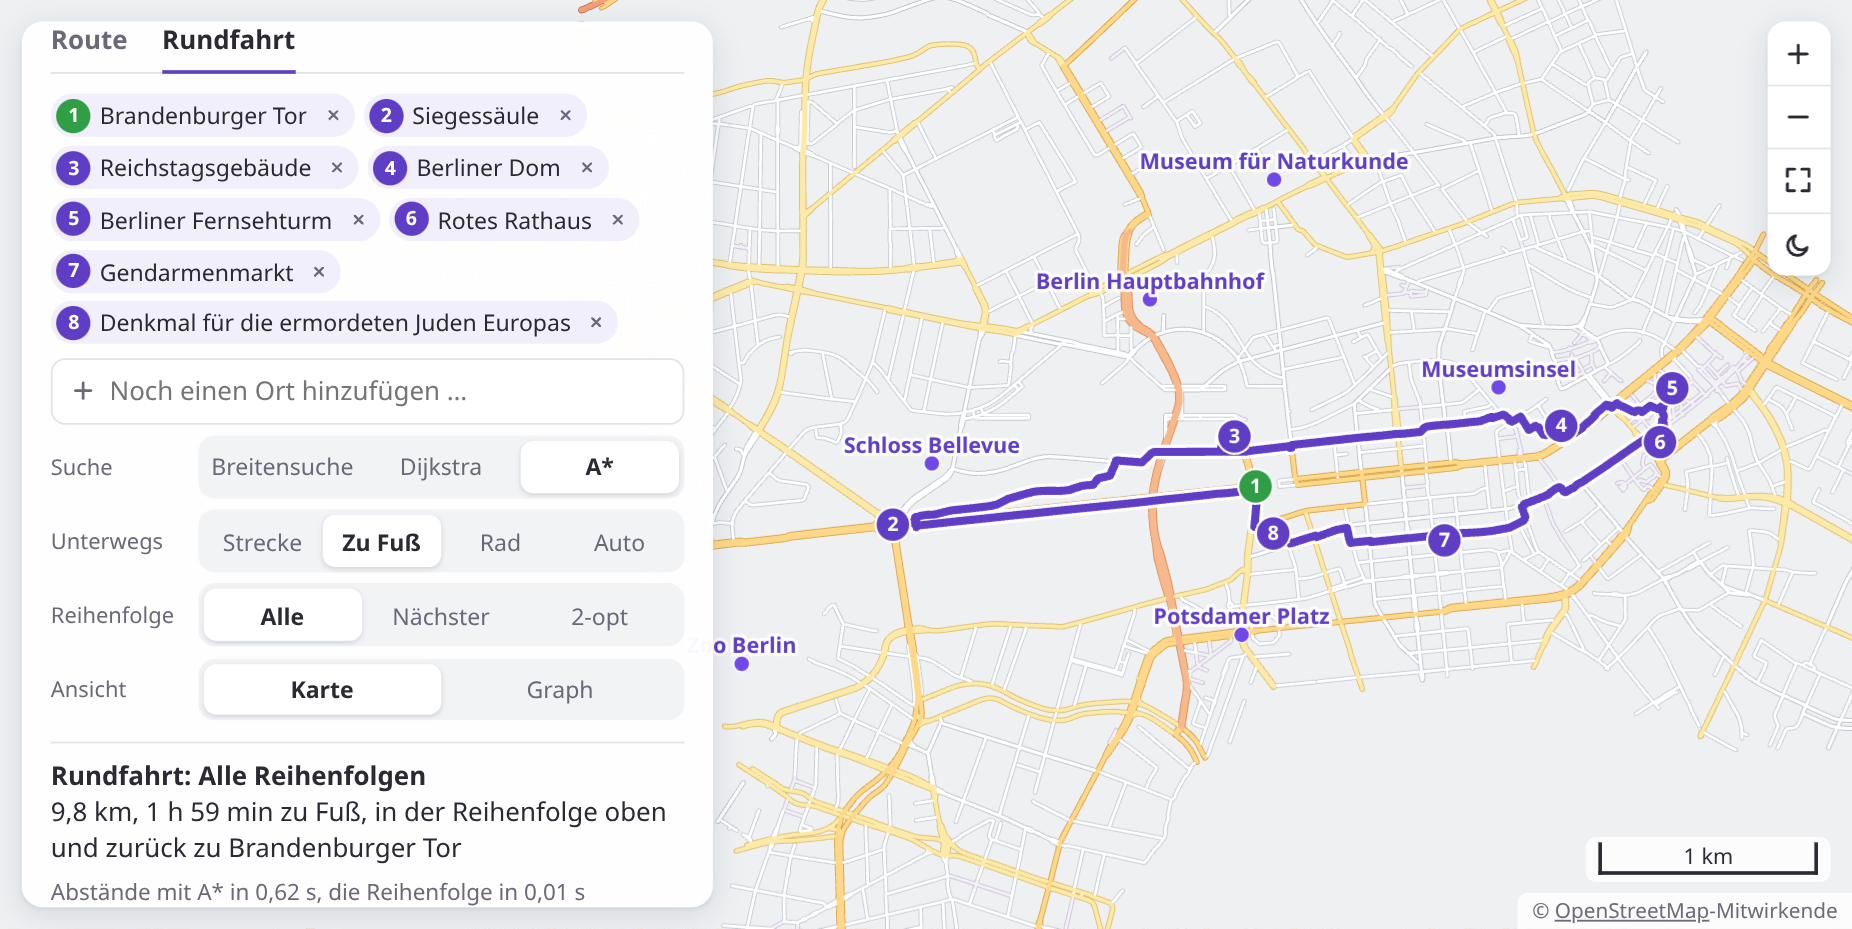
Der nächste Nachbar kommt auf 11,2 km, das Ausprobieren aller 5 040 Reihenfolgen auf 9,8 km. 2-opt, aus der Reihenfolge des nächsten Nachbarn, kommt bis auf 44 Meter an die beste heran, in einem Bruchteil der Zeit. Ganz die beste ist es nicht: 2-opt hört auf, wenn kein einzelnes Umdrehen mehr hilft, und das ist nicht immer die beste Rundfahrt. Für sehr viele Orte kennt niemand einen schnellen Weg zur besten. Routenplaner, Paketdienste und Busunternehmen arbeiten darum mit Verfahren wie 2-opt: gut genug, und rechtzeitig fertig.