powered by 
Im Logfile eines Webservers suchst du mit grep nach Fehlern und nach jemandem, der nach Lücken sucht. Dann prüfst du in Ruby oder Python Postleitzahlen, Daten und Benutzernamen mit regulären Ausdrücken und findest heraus, wo sie aufhören, eine gute Idee zu sein. Am Ende siehst du, dass hinter jedem regulären Ausdruck ein endlicher Automat steckt, und warum darum keiner prüfen kann, ob Klammern richtig stehen.
Ein Webserver schreibt jede Anfrage, die bei ihm ankommt, als eine Zeile in eine Datei, das Logfile: wer gefragt hat, wann, nach welcher Seite, und was er geantwortet hat. An einem ganz normalen Tag kommen so Hunderte Zeilen zusammen, auf einer großen Website Millionen. Niemand liest sie von oben nach unten. Man sucht darin, und zwar selten nach einem bestimmten Wort, sondern nach einem Muster: alle Zeilen mit einem Fehler des Servers, jede Adresse, die mehr als zehnmal etwas nicht gefunden hat, jede Anfrage nach einer PHP-Datei. Für solche Muster gibt es eine eigene kleine Sprache, die regulären Ausdrücke, auf Englisch regular expressions, kurz Regex. Du findest sie im Terminal, in jedem Editor und in fast jeder Programmiersprache.
Lege im Terminal (StrgJ) einen Ordner an, lade das Logfile hinein und öffne den Ordner mit StrgK StrgO:
mkdir /workspace/regex
cd /workspace/regex
wget https://workspace.hackschule.de/regex/starter/access.log
access.log ist das Logfile der Website einer ausgedachten Schule, von einem Dienstag im Oktober. Die Adressen darin sind erfunden: 10.12.… ist das Netz der Schule, die anderen stammen aus Bereichen, die für Beispiele reserviert sind (RFC 5737).
Alle Dateien dieser Aktivität kommen in diesen Ordner. Ein Programm startest du im Terminal mit ruby und dem Namen der Datei.
Alle Dateien dieser Aktivität kommen in diesen Ordner. Ein Programm startest du im Terminal mit python3 und dem Namen der Datei.
Jede Zeile hat denselben Aufbau, das Format heißt combined und ist das, was der Webserver nginx von selbst schreibt:
198.51.100.17 - - [27/Oct/2026:08:03:27 +0100] "GET /favicon.ico HTTP/1.1" 200 4048 "https://www.example.org/" "Mozilla/5.0 (iPhone; …)"
Vorn steht die Adresse, die gefragt hat, in eckigen Klammern die Zeit. In Anführungszeichen folgt die Anfrage selbst: die Methode GET (eine Seite holen) oder POST (ein Formular abschicken), der Pfad und die Version von HTTP. Dahinter stehen der Status, mit dem der Server geantwortet hat, und wie viele Bytes er geschickt hat. 200 heißt »hier ist die Seite«, 304 »du hast sie schon«, 404 »gibt es nicht«, und eine Zahl ab 500 heißt, dass beim Server selbst etwas schiefging. Die letzten zwei Teile sind die Seite, von der jemand kam, und das Programm, mit dem er gefragt hat.
Das einfachste Muster ist ein Wort. grep gibt jede Zeile aus, in der es vorkommt:
grep POST access.log
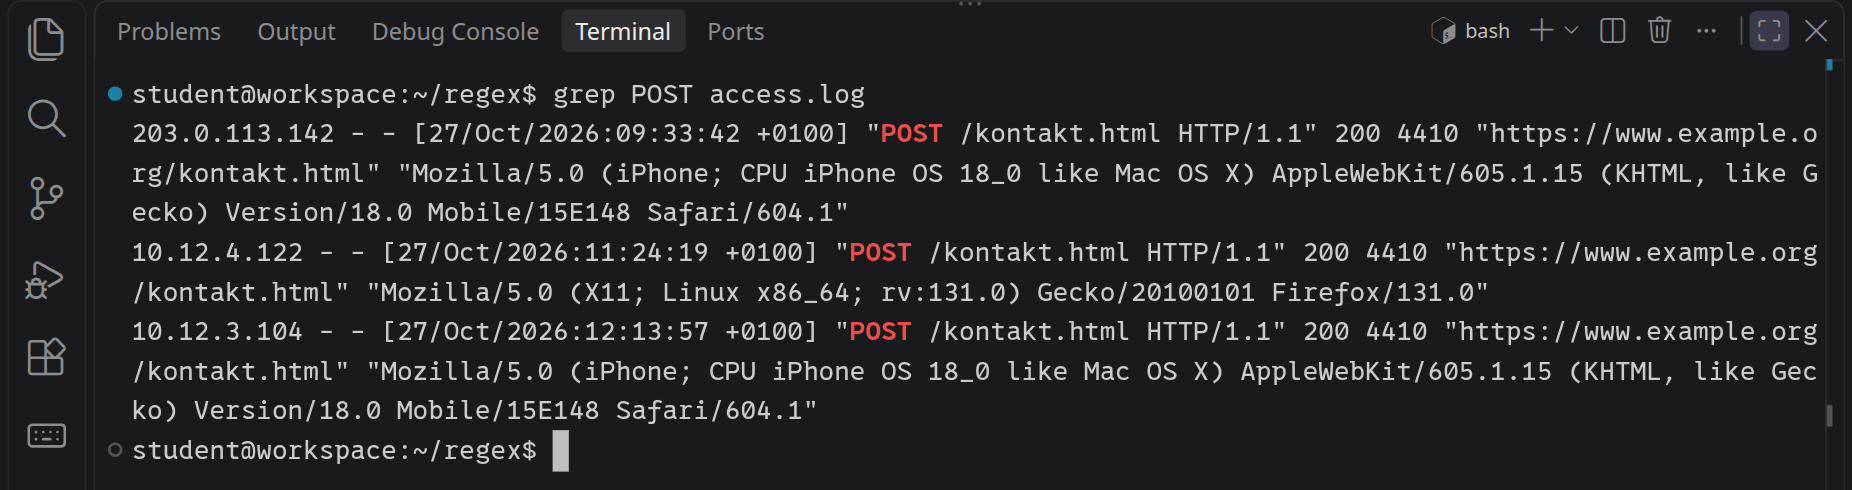
Drei Leute haben das Kontaktformular abgeschickt. Mit -c zählt grep die Zeilen, statt sie auszugeben. Wie viele Seiten wurden nicht gefunden? Bevor du es ausprobierst:
Was zählt grep -c 404 access.log?
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
grep -c 404 access.log
grep 404 access.log | grep -v '" 404 '
grep -c 404 zählt 33 Zeilen, aber nur 18 davon hat der Server mit 404 beantwortet. Der zweite Befehl zeigt die anderen: -v dreht grep um und gibt die Zeilen aus, auf die das Muster nicht passt. Dort steht 404 in der Zahl der Bytes, in 4048 und in 14042. grep sucht ein Muster überall in der Zeile; es weiß nicht, was ein Status ist. Darum schreibt man dazu, was um den Status herum steht: Das Anführungszeichen am Ende der Anfrage, ein Leerzeichen, 404, ein Leerzeichen. Das passt nur dort, wo der Status steht.
Für den Status 404 reicht ein festes Muster. Für »alle Fehler, die mit 4 anfangen« nicht mehr: Das sind 400, 403, 404 und so weiter. Hier beginnen die regulären Ausdrücke. Mit -E versteht grep sie (E steht für extended). [0-9] ist eine Zeichenklasse: ein einziges Zeichen, eines von 0 bis 9. {2} dahinter heißt »das Zeichen davor zweimal«:
grep -E '" 4[0-9]{2} ' access.log
Neben den Zeilen mit 404 steht darin eine mit 403: Jemand wollte /lehrerzimmer.html sehen und durfte nicht. Die einfachen Anführungszeichen um das Muster sorgen dafür, dass das Terminal das Muster so an grep weitergibt, wie es dasteht, mit den Leerzeichen und dem ".
Die Bausteine, aus denen reguläre Ausdrücke bestehen, stehen im Handbuch; hier sind sie, damit du nachschlagen kannst:
Reguläre Ausdrücke heißen auf Englisch regular expressions, kurz Regex oder Regexp. Ein Buchstabe oder eine Ziffer steht in ihnen für sich selbst: ing passt auf die drei Zeichen i, n, g hintereinander. Für »eines von mehreren Zeichen« gibt es Zeichenklassen:
| Muster | passt auf | Beispiel |
|---|---|---|
. |
ein beliebiges Zeichen außer dem Zeilenende |
h.t passt auf hat, hut, h7t |
[aeiou] |
eines der Zeichen in den Klammern |
h[aeiou]t passt auf hat, hut, nicht auf h7t |
[a-z], [0-9]
|
eines aus dem Bereich |
[A-Z][a-z] passt auf Ab, Xy |
[^0-9] |
ein Zeichen, das nicht in den Klammern steht |
[^ ] passt auf alles außer einem Leerzeichen |
\d, \w, \s
|
eine Ziffer, ein Wortzeichen (Buchstabe, Ziffer, _), ein Leerraum (Leerzeichen, Tab, Zeilenende) |
\d\d passt auf 42 |
\D, \W, \S
|
das Gegenteil davon |
\S+ passt auf ein ganzes Wort ohne Leerzeichen |
\., \*, \(
|
das Zeichen selbst: Ein \ nimmt einem Sonderzeichen seine Bedeutung |
3\.14 passt nur auf 3.14 |
| Muster | bedeutet | Beispiel |
|---|---|---|
A|B |
A oder B | Katze|Hund |
(…) |
fasst zusammen, wie in der Mathematik |
(ab)+ passt auf ab, abab, ababab |
A* |
A beliebig oft, auch keinmal: die Kleenesche Hülle (der Kleene-Stern) |
ab* passt auf a, ab, abbb |
A+ |
A mindestens einmal: die positive Hülle |
\d+ passt auf jede Zahl |
A? |
A höchstens einmal |
Farbe? passt auf Farb und Farbe |
A{3}, A{2,4}, A{2,}
|
genau dreimal, zwei- bis viermal, mindestens zweimal |
\d{5} passt auf eine Postleitzahl |
^, $
|
Anfang und Ende einer Zeile |
^# passt auf Zeilen, die mit # beginnen |
*, + und ? gelten für das, was direkt davor steht: In ab* wiederholt sich nur das b, in (ab)* beides. Und sie nehmen so viel, wie sie können: <.*> passt in <b>fett</b> auf alles von der ersten < bis zur letzten >. Mit einem ? dahinter (<.*?>) nehmen sie so wenig wie möglich und passen nur auf <b>.
Schreib einen Befehl, der alle Zeilen aus access.log ausgibt, in denen
der Server mit einem Fehler geantwortet hat, also mit einem Status von 500
bis 599. Die Prüfung führt ihn in /workspace/regex aus.
Der Status steht hinter dem Anführungszeichen, das die Anfrage schließt, und einem Leerzeichen; danach kommt wieder ein Leerzeichen.
Mit grep -E heißt [0-9] eine Ziffer und {2} »das Zeichen davor zweimal«.
Programme, die Websites nach Lücken absuchen, fragen nach Dateien, die es auf vielen Websites gibt, etwa nach der Anmeldung von WordPress oder nach phpMyAdmin. Viele davon enden auf .php. Wer im Logfile nach solchen Anfragen sucht, muss an den Punkt denken: Was er in einem regulären Ausdruck bedeutet, steht in der Tabelle oben.
Wer nach Lücken sucht, fragt nach PHP-Dateien, die es auf vielen Websites
gibt. Schreib einen Befehl, der alle Zeilen aus access.log ausgibt, in
deren Pfad .php vorkommt, ein Punkt und dann php. Die Prüfung führt ihn
in /workspace/regex aus.
^ ist der Anfang einer Zeile, $ ihr Ende. Beide passen auf kein Zeichen, sondern auf eine Stelle im Text; sie heißen Anker. ^# passt nur auf Zeilen, die mit # beginnen, ^$ auf leere Zeilen. Ohne Anker passt ein Muster überall in der Zeile, auch weit hinten.
Wie viele Anfragen kamen aus dem Netz der Schule, also von einer Adresse,
die mit 10. anfängt? Zähl sie mit grep und trag die Zahl ein.
Mit -o gibt grep nicht die ganze Zeile aus, sondern nur das Stück, auf das das Muster passt. Dahinter kann ein | die Ausgabe an das nächste Programm weitergeben, eine Pipe: sort sortiert die Zeilen, uniq -c fasst gleiche Zeilen, die untereinanderstehen, zu einer zusammen und schreibt davor, wie oft sie vorkamen. So zählst du, welche Pfade am häufigsten verlangt wurden:
grep -E -o '"GET [^ ]+' access.log | sort | uniq -c | sort -n
[^ ] ist eine Zeichenklasse mit ^ am Anfang, also jedes Zeichen außer dem Leerzeichen, und + heißt »einmal oder öfter«. [^ ]+ passt so auf den ganzen Pfad, bis zum Leerzeichen dahinter. Das letzte sort -n sortiert nach der Zahl vorn, das Häufigste steht unten.
Jemand hat an diesem Tag nach Lücken gesucht: nach Dateien von
WordPress, nach .env und anderem, was es auf der Website nicht gibt.
Von welcher Adresse kamen die meisten Anfragen, die der Server mit 404
beantwortet hat?
Erst die Zeilen mit dem Status 404, dann davon nur die Adressen. Zwei grep hintereinander, mit einer Pipe dazwischen.
Die Adresse steht am Anfang der Zeile, bis zum ersten Leerzeichen. grep -E -o '^[^ ]+' schneidet sie heraus; zählen kannst du dann wie bei den Pfaden.
Weitere Schalter von grep, -i für Groß und Klein, -n für die Nummer jeder Zeile und -r für ganze Ordner, stehen im Handbuch unter Reguläre Ausdrücke mit grep.
grep beantwortet Fragen, die man einmal stellt. Soll ein Programm das Logfile jede Nacht lesen und am Morgen eine Übersicht schreiben, kommen die Ausdrücke in den Code. In Ruby steht ein regulärer Ausdruck zwischen zwei Schrägstrichen, /" 404 /, und ist ein Objekt wie ein String oder eine Zahl. Lege log.rb an:
# Das Logfile des Webservers, gelesen mit regulären Ausdrücken
lines = File.readlines('access.log', chomp: true)
line = lines[3]

puts line
p line =~ /HTTP/
p line =~ /" 404 /
p lines.count { |l| l =~ /" 404 / }
File.readlines liest die Datei als Liste von Zeilen, chomp: true nimmt jeder ihr Zeilenende ab. =~ sucht den Ausdruck im String und gibt den Index zurück, an dem der erste Treffer beginnt, oder nil, wenn es keinen gibt. Weil nil in einem if als falsch zählt und jede Zahl als wahr, zählt count damit die Zeilen mit einem Treffer, wie grep -c. Starte das Programm:
ruby log.rb
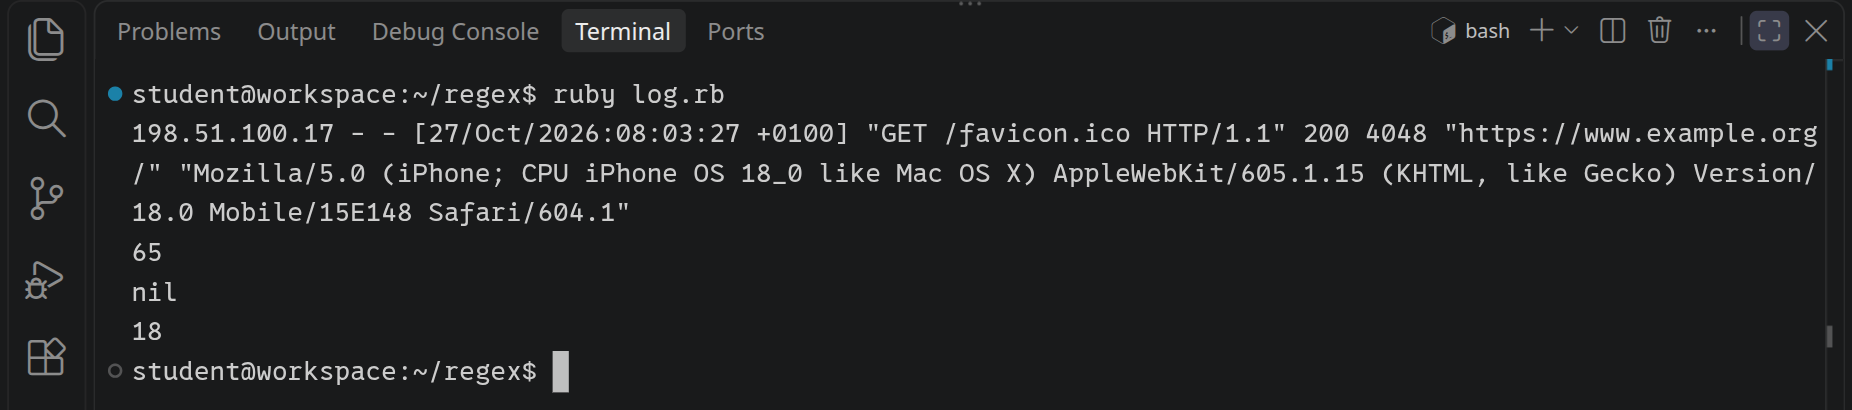
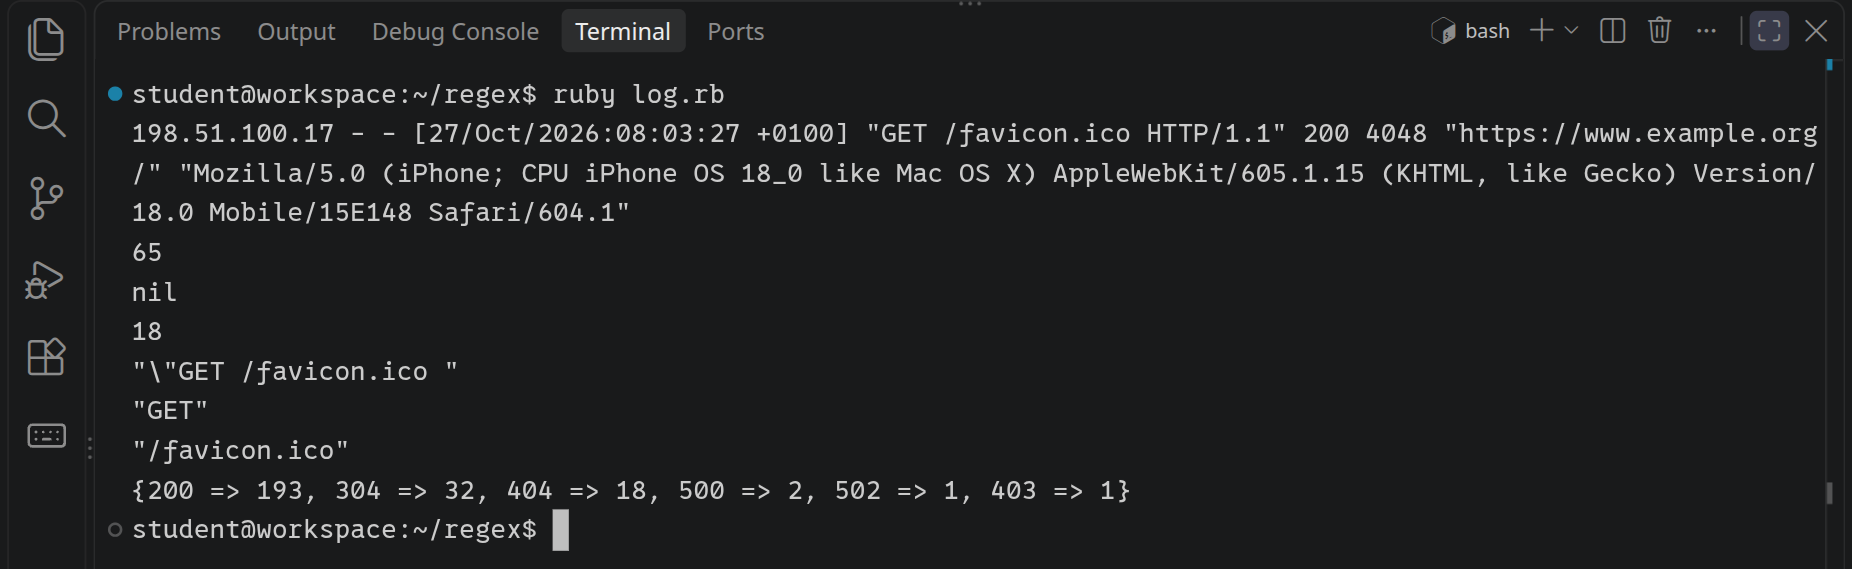
HTTP beginnt am Index 65. " 404 kommt in dieser Zeile nicht vor, obwohl 4048 darin steht, und 18 Zeilen haben den Status 404, wie bei grep.
grep beantwortet Fragen, die man einmal stellt. Soll ein Programm das Logfile jede Nacht lesen und am Morgen eine Übersicht schreiben, kommen die Ausdrücke in den Code. In Python stehen die Funktionen dafür im Modul re, und der Ausdruck ist ein String. Man schreibt ihn als Raw-String mit einem r davor, r'" 404 ', damit Python die Backslashes darin nicht selbst auswertet. Lege log.py an:
# Das Logfile des Webservers, gelesen mit regulären Ausdrücken
import re

with open('access.log') as f:
    lines = f.read().splitlines()
line = lines[3]

print(line)
print(re.search(r'HTTP', line))
print(re.search(r'" 404 ', line))
print(sum(1 for l in lines if re.search(r'" 404 ', l)))
splitlines zerlegt die Datei in eine Liste von Zeilen, ohne die Zeilenenden. re.search sucht den Ausdruck im String und gibt ein Match-Objekt zurück, das sagt, wo der erste Treffer steht, oder None, wenn es keinen gibt. Weil None in einem if als falsch zählt und jedes Match-Objekt als wahr, zählt die letzte Zeile damit die Zeilen mit einem Treffer, wie grep -c. Starte das Programm:
python3 log.py
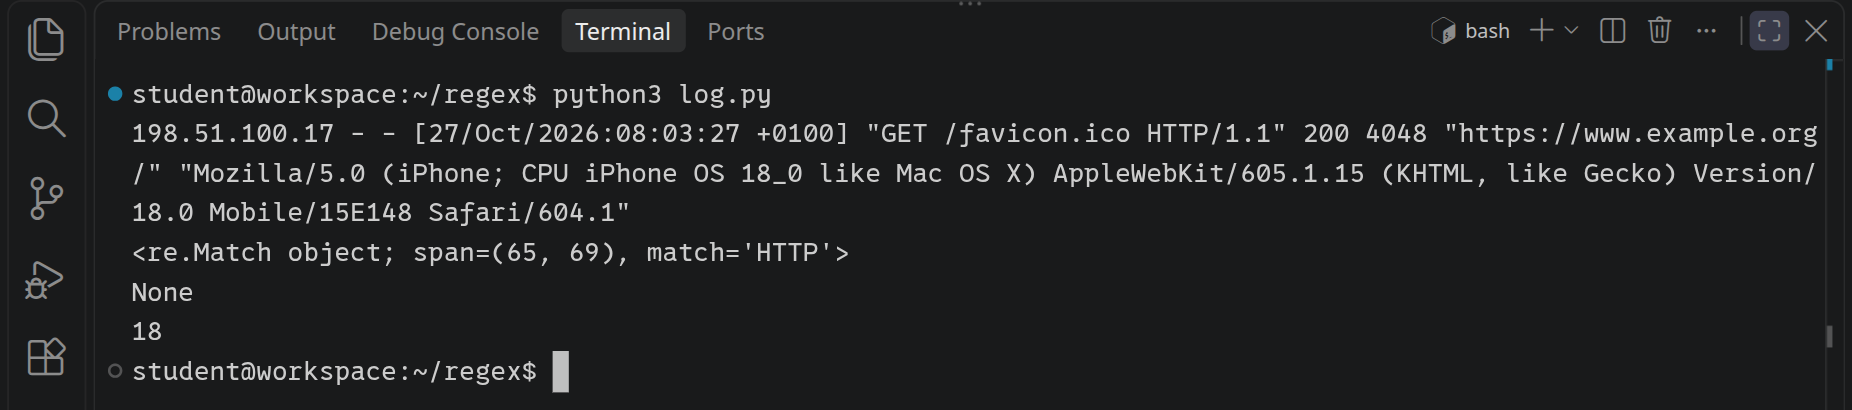
span=(65, 69) sind die Indizes, an denen der Treffer HTTP beginnt und hinter dem er endet. " 404 kommt in dieser Zeile nicht vor, obwohl 4048 darin steht, und 18 Zeilen haben den Status 404, wie bei grep.
Ob ein Muster passt, ist oft nur die halbe Frage. Ein Programm will wissen, was an dieser Stelle steht: welcher Pfad, welcher Status. Dafür gibt es Gruppen: Was im Ausdruck in runden Klammern steht, merkt sich das Match-Objekt einzeln.
Hänge an log.rb an:
m = line.match(/"(GET|POST) (\S+) /)
p m[0]
p m[1]
p m[2]
match gibt ein Objekt der Klasse MatchData zurück, oder nil, wenn der Ausdruck nicht passt. m[0] ist der ganze Treffer, mit dem Anführungszeichen vorn, das p als \" ausgibt; m[1] das, worauf die erste Klammer passt, GET oder POST, und m[2] die zweite, \S+: ein oder mehr Zeichen, die kein Leerzeichen sind, also der Pfad.
Hänge an log.py an:
m = re.search(r'"(GET|POST) (\S+) ', line)
print(m.group(0))
print(m.group(1))
print(m.group(2))
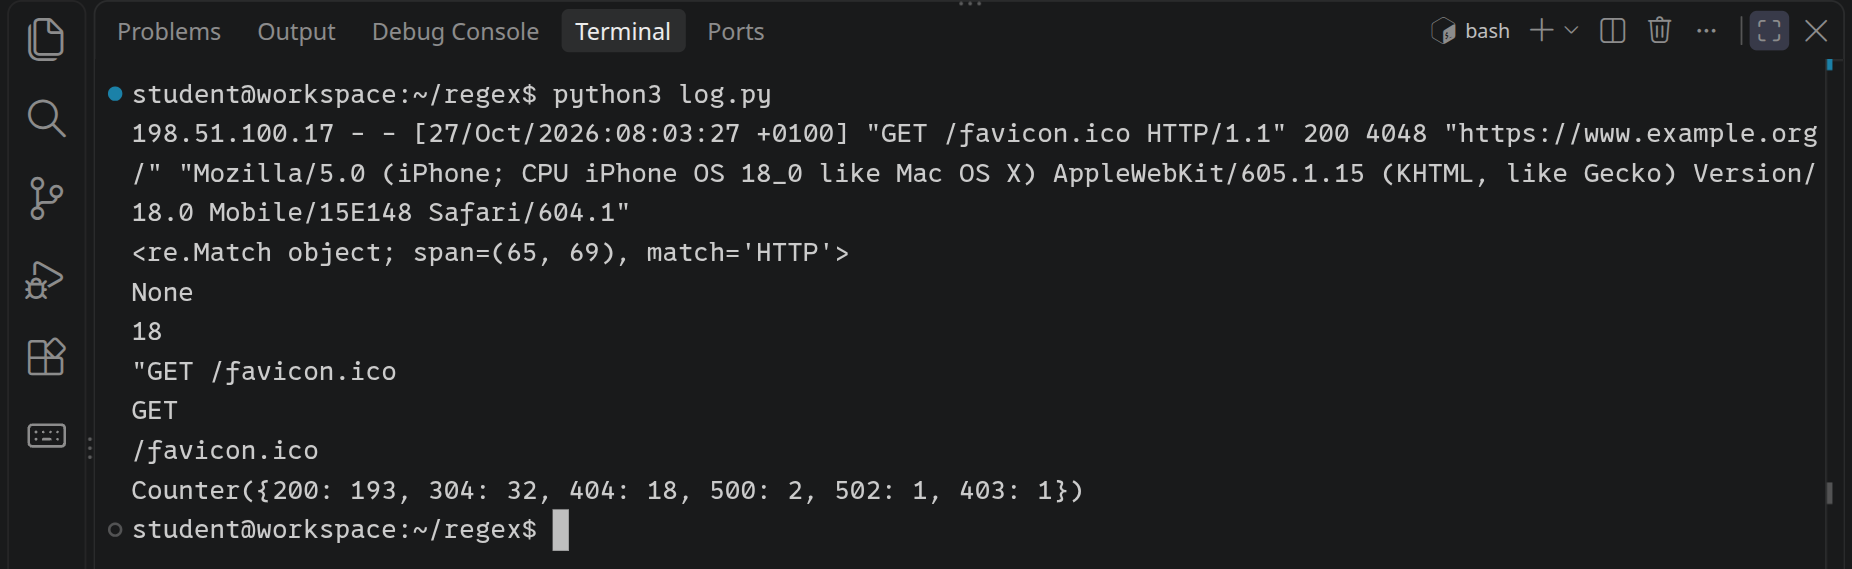
m.group(0) ist der ganze Treffer, m.group(1) das, worauf die erste Klammer passt, GET oder POST, und m.group(2) die zweite, \S+: ein oder mehr Zeichen, die kein Leerzeichen sind, also der Pfad.
log.rb eine Methode status(line), die den Status einer Zeile als Zahl zurückgibt, bei der Zeile oben also 200. Steht in der Zeile kein Status, gibt sie nil zurück. Achte auf die Zeilen, in denen auch in der Zahl der Bytes drei Ziffern hintereinander stehen.
Wo steht der Status? Sieh dir die Zeile oben an: hinter dem Anführungszeichen, das die Anfrage schließt, und einem Leerzeichen, und danach kommt wieder ein Leerzeichen. Genau wie bei grep schreibst du das, was um den Status herum steht, mit in den Ausdruck.
Die drei Ziffern kommen in eine Gruppe. line.match(…) gibt nil, wenn der Ausdruck nicht passt; sonst ist m[1] der Status als String, und to_i macht eine Zahl daraus.
Ein Gerüst:
def status(line)
    m = line.match(/" (…) /)
    return nil if m.nil?
    …
end
# Der Status einer Zeile als Zahl, oder nil, wenn die Zeile keinen hat
def status(line)
    m = line.match(/" (\d{3}) /)
    return nil if m.nil?
    m[1].to_i
end
\d ist dasselbe wie [0-9], eine Ziffer.
log.py eine Funktion status(line), die den Status einer Zeile als Zahl zurückgibt, bei der Zeile oben also 200. Steht in der Zeile kein Status, gibt sie None zurück. Achte auf die Zeilen, in denen auch in der Zahl der Bytes drei Ziffern hintereinander stehen.
Wo steht der Status? Sieh dir die Zeile oben an: hinter dem Anführungszeichen, das die Anfrage schließt, und einem Leerzeichen, und danach kommt wieder ein Leerzeichen. Genau wie bei grep schreibst du das, was um den Status herum steht, mit in den Ausdruck.
Die drei Ziffern kommen in eine Gruppe. re.search(…) gibt None, wenn der Ausdruck nicht passt; sonst ist m.group(1) der Status als String, und int(…) macht eine Zahl daraus.
Ein Gerüst:
def status(line):
    m = re.search(r'" (…) ', line)
    if m is None:
        return None
    return …
# Der Status einer Zeile als Zahl, oder None, wenn die Zeile keinen hat
def status(line):
    m = re.search(r'" (\d{3}) ', line)
    if m is None:
        return None
    return int(m.group(1))
\d ist dasselbe wie [0-9], eine Ziffer.
Schreib in log.rb die Methode status(line): Sie gibt den Status einer
Zeile als Zahl zurück, und nil, wenn die Zeile keinen hat. Die Prüfung
ruft sie mit sechs Zeilen auf und nennt die erste, bei der das Ergebnis
nicht stimmt.
Schreib in log.py die Funktion status(line): Sie gibt den Status
einer Zeile als Zahl zurück, und None, wenn die Zeile keinen hat. Die
Prüfung ruft sie mit sechs Zeilen auf und nennt die erste, bei der das
Ergebnis nicht stimmt.
Mit status wird die Übersicht eine Zeile. tally zählt, wie oft jeder Wert in einer Liste vorkommt; hänge sie ans Ende von log.rb an:
p lines.map { |l| status(l) }.tally
Mit status wird die Übersicht eine Zeile. Ein Counter aus dem Modul collections zählt, wie oft jeder Wert vorkommt; schreib unter import re die Zeile from collections import Counter und hänge ans Ende von log.py an:
print(Counter(status(l) for l in lines))
scan findet nicht nur den ersten Treffer, sondern alle, als Liste. Hänge p File.read('access.log').scan(/\S+\.jpg/) an und dann p File.read('access.log').scan(/\S+\.(jpg|png)/). Achte darauf, was in der zweiten Liste steht: Hat der Ausdruck Gruppen, liefert scan nur, worauf die Gruppen passen. Mit (?:jpg|png) fasst eine Klammer zusammen, ohne eine Gruppe zu sein. Nimm die Zeilen danach wieder heraus.
re.findall findet nicht nur den ersten Treffer, sondern alle, als Liste. Hänge print(re.findall(r'\S+\.jpg', open('access.log').read())) an und dann print(re.findall(r'\S+\.(jpg|png)', open('access.log').read())). Achte darauf, was in der zweiten Liste steht: Hat der Ausdruck Gruppen, liefert findall nur, worauf die Gruppen passen. Mit (?:jpg|png) fasst eine Klammer zusammen, ohne eine Gruppe zu sein. Nimm die Zeilen danach wieder heraus.
Ein Formular fragt nach einer Postleitzahl, einem Geburtsdatum, einem Benutzernamen. Bevor ein Programm damit arbeitet, prüft es, ob die Eingabe so aussieht, wie sie aussehen soll. Das ist die zweite große Arbeit regulärer Ausdrücke, und ein Fehler darin hat einen anderen Fehler als beim Suchen: Eine Suche, die eine Zeile zu viel findet, sieht man; eine Prüfung, die eine falsche Eingabe durchlässt, merkt niemand, bis etwas kaputtgeht.
Eine deutsche Postleitzahl hat fünf Ziffern, als Ausdruck \d{5}. Bevor du ihn in ein Programm schreibst:
Auf welche dieser Eingaben passt /\d{5}/, wenn ein Programm mit
text.match?(/\d{5}/) prüft?
Auf welche dieser Eingaben passt r'\d{5}', wenn ein Programm mit
re.search(r'\d{5}', text) prüft?
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
match? sagt nur, ob der Ausdruck irgendwo im String passt, wie grep in einer Zeile. Fünf Ziffern stehen in D-10115 Berlin und in 101150. Für eine Prüfung muss der Ausdruck auf den ganzen String passen, von seinem Anfang bis zu seinem Ende. In Ruby sind das die Anker \A und \z. Lege validate.rb an:
# Eingaben prüfen, bevor ein Programm mit ihnen arbeitet
def postcode?(text)
    text.match?(/\A\d{5}\z/)
end

['10115', '1011', 'D-10115 Berlin', '101150'].each do |text|
    puts "#{text.inspect} #{postcode?(text)}"
end
Eine Methode, die Ja oder Nein sagt, bekommt in Ruby ein ? an ihren Namen. Warum nicht ^ und $ wie bei grep? In Ruby sind sie Anfang und Ende jeder Zeile im String. "10115\n<script>".match?(/^\d{5}$/) ist true, weil die erste Zeile nur aus fünf Ziffern besteht; was in der zweiten steht, prüft der Ausdruck nicht mehr. Für eine Prüfung schreibst du darum immer \A und \z.
re.search sagt nur, ob der Ausdruck irgendwo im String passt, wie grep in einer Zeile. Fünf Ziffern stehen in D-10115 Berlin und in 101150. Für eine Prüfung muss der Ausdruck auf den ganzen String passen, von seinem Anfang bis zu seinem Ende. Genau das prüft re.fullmatch. Lege validate.py an:
# Eingaben prüfen, bevor ein Programm mit ihnen arbeitet
import re


def is_postcode(text):
    return re.fullmatch(r'\d{5}', text) is not None


for text in ['10115', '1011', 'D-10115 Berlin', '101150']:
    print(repr(text), is_postcode(text))
Warum nicht ^ und $ wie bei grep? re.search(r'^\d{5}$', '10115\n') findet einen Treffer: In Python passt $ auch vor einem Zeilenende ganz am Schluss. Ein Zeichen zu viel kommt so durch die Prüfung. re.fullmatch lässt nichts übrig, darum nimmst du es für jede Prüfung.
In Ruby steht ein regulärer Ausdruck zwischen Schrägstrichen:
plz = /\A\d{5}\z/
puts '10115'.match?(plz)            # true
puts '1011'.match?(plz)             # false

text = 'Am 3.10. und am 24.12. ist frei.'
p text =~ /\d+\./                  # 3
p text.scan(/\d+\.\d+\./)           # ["3.10.", "24.12."]
puts text.gsub(/\d+/, '#')          # Am #.#. und am #.#. ist frei.

if (m = text.match(/(\d+)\.(\d+)\./))
  puts "Tag #{m[1]}, Monat #{m[2]}" # Tag 3, Monat 10
end
=~ gibt den Index zurück, an dem der erste Treffer beginnt, oder nil; in einem if heißt das »passt« oder »passt nicht«. match gibt ein MatchData mit den Gruppen, m[1] ist die erste Klammer. \A und \z sind Anfang und Ende des ganzen Strings. ^ und $ sind in Ruby Anfang und Ende jeder Zeile: /^\d{5}$/ passt auch auf einen String, in dem irgendwo eine Zeile nur aus fünf Ziffern besteht.
In Python stehen die Funktionen im Modul re. Das Muster schreibt man als Raw-String r"…", damit Python die Backslashes nicht selbst auswertet:
import re

print(bool(re.fullmatch(r"\d{5}", "10115")))   # True: der ganze String passt
print(bool(re.fullmatch(r"\d{5}", "1011")))    # False

text = "Am 3.10. und am 24.12. ist frei."
print(re.findall(r"\d+\.\d+\.", text))       # ['3.10.', '24.12.']
print(re.sub(r"\d+", "#", text))              # Am #.#. und am #.#. ist frei.

m = re.search(r"(\d+)\.(\d+)\.", text)
if m:
    print(f"Tag {m.group(1)}, Monat {m.group(2)}")   # Tag 3, Monat 10
re.fullmatch prüft den ganzen String, re.search sucht eine Stelle irgendwo darin, re.match eine am Anfang.
Ein Datum, wie man es in Deutschland schreibt: zwei Ziffern für den Tag, ein Punkt, zwei für den Monat, ein Punkt, vier für das Jahr, 24.12.2026. \d{2}\.\d{2}\.\d{4} beschreibt die Form, nimmt aber auch 45.17.2026 an. Ein besserer Ausdruck lässt nur Tage von 01 bis 31 und Monate von 01 bis 12 durch. Dafür braucht es kein Rechnen, sondern Alternativen: Ein Tag ist eine 0 mit einer Ziffer von 1 bis 9 dahinter, oder eine 1 oder 2 mit irgendeiner Ziffer, oder eine 3 mit einer 0 oder 1.
validate.rb eine Methode date?(text), die true zurückgibt, wenn text ein Datum in dieser Form ist: Tag 01 bis 31, Monat 01 bis 12, ein Jahr mit vier Ziffern, dazwischen Punkte, davor und dahinter nichts. Ein Tag mit einer Ziffer wie in 1.1.2026 zählt nicht.
Nimm dir den Tag allein vor und schreib die Tage von 01 bis 31 in drei Gruppen auf: 01 bis 09, 10 bis 29, 30 und 31. Welche Ziffer steht in jeder Gruppe vorn, und welche dürfen dahinter kommen?
Die drei Gruppen werden drei Alternativen in einer Klammer, getrennt durch |: (0[1-9]|…|…). Den Monat baust du genauso, aus 01 bis 09 und 10 bis 12. Der Punkt dazwischen muss \. sein, sonst passt auch 24-12-2026.
Ein Gerüst; die Lücken füllst du:
def date?(text)
    text.match?(/\A(0[1-9]|…|…)\.(…|…)\.\d{4}\z/)
end
# Ein Datum wie 24.12.2026: Tag 01 bis 31, Monat 01 bis 12, ein Jahr mit vier Ziffern
def date?(text)
    text.match?(/\A(0[1-9]|[12][0-9]|3[01])\.(0[1-9]|1[0-2])\.\d{4}\z/)
end
validate.py eine Funktion is_date(text), die True zurückgibt, wenn text ein Datum in dieser Form ist: Tag 01 bis 31, Monat 01 bis 12, ein Jahr mit vier Ziffern, dazwischen Punkte, davor und dahinter nichts. Ein Tag mit einer Ziffer wie in 1.1.2026 zählt nicht.
Nimm dir den Tag allein vor und schreib die Tage von 01 bis 31 in drei Gruppen auf: 01 bis 09, 10 bis 29, 30 und 31. Welche Ziffer steht in jeder Gruppe vorn, und welche dürfen dahinter kommen?
Die drei Gruppen werden drei Alternativen in einer Klammer, getrennt durch |: (0[1-9]|…|…). Den Monat baust du genauso, aus 01 bis 09 und 10 bis 12. Der Punkt dazwischen muss \. sein, sonst passt auch 24-12-2026.
Ein Gerüst; die Lücken füllst du:
def is_date(text):
    return re.fullmatch(r'(0[1-9]|…|…)\.(…|…)\.\d{4}', text) is not None
# Ein Datum wie 24.12.2026: Tag 01 bis 31, Monat 01 bis 12, ein Jahr mit vier Ziffern
def is_date(text):
    return re.fullmatch(r'(0[1-9]|[12][0-9]|3[01])\.(0[1-9]|1[0-2])\.\d{4}', text) is not None
Schreib in validate.rb die Methode date?(text) aus dem Kasten oben.
Die Prüfung ruft sie mit Daten auf, die es gibt, und mit Texten, die
keines sind, und nennt den ersten, bei dem deine Methode sich irrt.
Schreib in validate.py die Funktion is_date(text) aus dem Kasten
oben. Die Prüfung ruft sie mit Daten auf, die es gibt, und mit Texten,
die keines sind, und nennt den ersten, bei dem deine Funktion sich irrt.
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
Probier date?('31.02.2026') aus. Der Ausdruck nimmt es an, obwohl es den 31. Februar nie gibt, und auch den 29. Februar nur in manchen Jahren. Ein regulärer Ausdruck prüft die Form eines Texts, nicht, ob er etwas bedeutet. Das ist derselbe Unterschied wie zwischen Syntax und Semantik bei Programmiersprachen. Ob es einen Tag gibt, weiß der Kalender: Date.valid_date?(2026, 2, 31) ist false, nach require 'date'. Gut ist darum beides zusammen: Der Ausdruck prüft die Form und holt mit Gruppen Tag, Monat und Jahr heraus, Date.valid_date? prüft den Tag.
Probier is_date('31.02.2026') aus. Der Ausdruck nimmt es an, obwohl es den 31. Februar nie gibt, und auch den 29. Februar nur in manchen Jahren. Ein regulärer Ausdruck prüft die Form eines Texts, nicht, ob er etwas bedeutet. Das ist derselbe Unterschied wie zwischen Syntax und Semantik bei Programmiersprachen. Ob es einen Tag gibt, weiß der Kalender: datetime.date(2026, 2, 31) bricht mit einem ValueError ab, nach import datetime. Gut ist darum beides zusammen: Der Ausdruck prüft die Form und holt mit Gruppen Tag, Monat und Jahr heraus, datetime.date prüft den Tag.
Die nächste Regel schreibst du ohne Kasten; die Prüfung sagt dir, bei welchem Namen dein Ausdruck sich irrt:
Für die Website der Schule gilt: Ein Benutzername hat 3 bis 16 Zeichen,
kleine Buchstaben von a bis z, Ziffern und den Unterstrich _, und er
fängt mit einem Buchstaben an. Schreib in validate.rb eine Methode
username?(text), die genau dann true zurückgibt. Die Prüfung ruft sie
mit Namen auf, die passen, und mit solchen, die nicht passen, und nennt
den ersten, bei dem deine Methode sich irrt.
Teil den Namen in zwei Stücke, das erste Zeichen und den Rest. Welche Zeichen dürfen vorn stehen, welche danach? Wie viele Zeichen hat der Rest, wenn der ganze Name 3 bis 16 Zeichen hat?
{2,15} heißt »das Zeichen davor zwei- bis fünfzehnmal«. Eine Zeichenklasse darf mehrere Bereiche haben: [a-z0-9].
Ein Gerüst:
def username?(text)
    text.match?(/\A[a-z]…\z/)
end
Für die Website der Schule gilt: Ein Benutzername hat 3 bis 16 Zeichen,
kleine Buchstaben von a bis z, Ziffern und den Unterstrich _, und er
fängt mit einem Buchstaben an. Schreib in validate.py eine Funktion
is_username(text), die genau dann True zurückgibt. Die Prüfung ruft
sie mit Namen auf, die passen, und mit solchen, die nicht passen, und
nennt den ersten, bei dem deine Funktion sich irrt.
Teil den Namen in zwei Stücke, das erste Zeichen und den Rest. Welche Zeichen dürfen vorn stehen, welche danach? Wie viele Zeichen hat der Rest, wenn der ganze Name 3 bis 16 Zeichen hat?
{2,15} heißt »das Zeichen davor zwei- bis fünfzehnmal«. Eine Zeichenklasse darf mehrere Bereiche haben: [a-z0-9].
Ein Gerüst:
def is_username(text):
    return re.fullmatch(r'[a-z]…', text) is not None
Bei E-Mail-Adressen sieht es aus, als ginge es genauso: ein Name, ein @ und dahinter ein Name mit Punkten. Bevor du weiterliest:
Ein Formular, mit dem man sich anmeldet, fragt nach einer E-Mail-Adresse. Wie prüft man sie am besten?
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
Was eine E-Mail-Adresse sein darf, legt RFC 5322 fest, und es ist erstaunlich viel: "pip und bello"@example.org mit Anführungszeichen und Leerzeichen, Kommentare in runden Klammern, ein Pluszeichen wie in pip+schule@example.org, das viele Menschen benutzen, um ihre Post zu sortieren. Ein Ausdruck, der alle Regeln einer älteren Fassung genau nachbaut, steht auf der Seite des Perl-Moduls Mail::RFC822::Address: Er ist über 6000 Zeichen lang, und ein Programm hat ihn aus den Regeln erzeugt, nicht ein Mensch von Hand. Dabei sagt auch der beste Ausdruck nicht, ob es das Postfach gibt und ob es der Person gehört, die das Formular ausfüllt.
Darum prüft man nur grob, ob ein @ mit etwas davor und dahinter darin steht, und schickt dann eine E-Mail mit einem Link zum Bestätigen. Wer ihn anklickt, hat eine Adresse, die funktioniert. Selbst das Feld <input type='email'> in HTML prüft mit Absicht weniger, als der RFC erlaubt, und nennt das in seiner Beschreibung eine willful violation, einen gewollten Verstoß (HTML Living Standard). Ein regulärer Ausdruck ist das richtige Werkzeug für Formen, die einfach sind; wo die Regeln lang werden, hilft ein Programm, eine Bibliothek oder eine Grammatik.
Am 2. Juli 2019 waren viele Websites weltweit für 27 Minuten nicht erreichbar. Die Firma Cloudflare, über deren Rechner sie laufen, hatte eine neue Regel gegen Angriffe eingespielt, und darin stand ein regulärer Ausdruck, der bei manchen Anfragen so lange probierte, dass die Prozessoren nichts anderes mehr taten (der Bericht von Cloudflare). Die meisten Programmiersprachen prüfen einen Ausdruck nämlich, indem sie einen Weg durch ihn versuchen und, wenn er nicht passt, zurückgehen und den nächsten Weg nehmen, Backtracking genannt. (a+)+b lässt sich auf aaaa auf sehr viele Weisen aufteilen: alle vier a in einem a+, oder 3 und 1, oder 2 und 2, oder 1, 1, 1 und 1 … Fehlt am Ende das b, probiert ein solches Programm sie alle, und mit jedem a mehr werden es doppelt so viele.
time ruby -e "p ('a' * 30 + 'cb').match?(/\A(a+)+b\z/)". Das geht schnell: Ruby merkt sich seit Version 3.2, an welchen Stellen es mit welchem Teil des Ausdrucks schon gescheitert ist, und probiert nichts zweimal (Ruby 3.2, »Regexp improvements against ReDoS«). Mit einem Rückverweis wie \1, der auf das zeigt, was die erste Gruppe gefunden hat, kann es sich das nicht merken: Versuch time ruby -e "p ('a' * 22 + 'cb').match?(/\A(a+)+\1b\z/)" und dann mit 24 und 26 statt 22. Wie ändert sich die Zeit, wenn zwei a dazukommen?
time python3 -c "import re; print(re.fullmatch(r'(a+)+b', 'a' * 22 + 'cb'))" und dann mit 24 und 26 statt 22. Wie ändert sich die Zeit, wenn zwei a dazukommen? Rechne damit aus, wie lange es mit 40 dauern würde, statt es auszuprobieren.
Wie man Ausdrücke prüft, ohne je zurückzugehen, hat Ken Thompson schon 1968 aufgeschrieben, und das steckt im letzten Teil dieser Seite. Russ Cox erklärt in Regular Expression Matching Can Be Simple And Fast, warum viele Sprachen es trotzdem anders machen: Rückverweise und andere Erweiterungen gehen nur mit Backtracking.
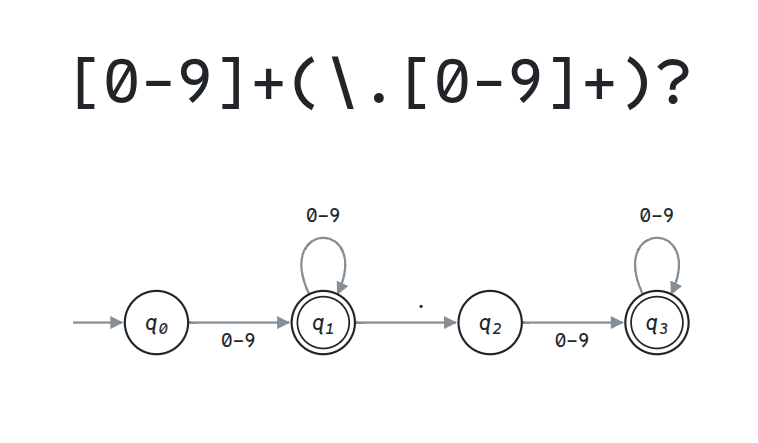
In Endliche Automaten hast du Automaten gebaut, die ein Wort Zeichen für Zeichen lesen und am Ende Ja oder Nein sagen. Ein regulärer Ausdruck sagt auch Ja oder Nein zu einem Wort. Das ist kein Zufall: Aus jedem regulären Ausdruck lässt sich ein endlicher Automat bauen, der genau die Wörter annimmt, auf die der Ausdruck passt. Mit Klassen wie [0-9] und {5} wird es nur länger; die Bausteine, die man wirklich braucht, sind vier: ein Zeichen, zwei Stücke hintereinander, | und *.
Für jeden Baustein gibt es ein kleines Stück Automat, und die Stücke werden ineinandergesteckt, wie die Klammern im Ausdruck. Damit das einfach bleibt, dürfen die Stücke ε-Übergänge haben: Pfeile mit einem ε, die der Automat nehmen darf, ohne ein Zeichen zu lesen. Ein Automat mit ε-Übergängen ist ein NEA, der zusätzlich raten darf, ob er so einen Pfeil nimmt.
Ein regulärer Ausdruck beschreibt eine Sprache, und die Thompson-Konstruktion baut daraus einen NEA, Stück für Stück aus wenigen Bausteinen. Jeder Baustein hat einen Start und einen akzeptierenden Zustand, und die Bausteine werden mit ε-Übergängen verbunden. Die Bilder in diesem Abschnitt zeichnet Automatron, und genau so sehen die Automaten dort aus. Es baut nach dieser Konstruktion, lässt aber ε-Übergänge weg, die nur ein Stück an das nächste hängen.
Ken Thompson (geboren 1943). Du suchst im Terminal mit grep? Das hat er 1973 geschrieben; der Name kommt aus seinem Texteditor, wo der Befehl g/re/p hieß: global, regular expression, print. Wie man aus einem regulären Ausdruck einen Automaten baut, hatte er schon 1968 beschrieben: die Thompson-Konstruktion.
Das Terminal selbst läuft unter Linux, und Linux funktioniert wie Unix, das er ab 1969 mit Dennis Ritchie schrieb. Unten rechts in VS Code steht UTF-8: Die Kodierung hat er 1992 mit Rob Pike auf ein Tischset in einem Diner gezeichnet. Und die Sprache Go hat er mit erfunden.
Foto: A. C. Diller, 2019, CC BY-SA 4.0, zugeschnitten (Wikimedia Commons)
Regular Expression Search Algorithm, Ken Thompson, Communications of the ACM, 1968. Auf vier Seiten baut Thompson aus einem regulären Ausdruck einen NEA und verfolgt beim Suchen alle Zustände zugleich, in denen er sein könnte; sein Programm übersetzt den Ausdruck dafür gleich in Maschinencode für den Rechner IBM 7094: frei bei der ACM.
a: ein Zeichen ist ein Pfeil.ab: Der akzeptierende Zustand des ersten Stücks ist der Start des zweiten.a|b: ein neuer Start mit ε zu beiden Stücken, von beiden mit ε zu einem neuen Ende. Die Sprache ist die Vereinigung der beiden Sprachen.a*: ein ε am Stück vorbei (keinmal) und eins vom Ende zurück an seinen Anfang (noch einmal).a+: derselbe Baustein ohne den Pfeil vorbei, das Stück kommt mindestens einmal.a?: derselbe Baustein ohne den Pfeil zurück, das Stück kommt höchstens einmal.Symbol, Verkettung, Alternative und Kleenesche Hülle reichen für jeden regulären Ausdruck; positive Hülle und Option sind Abkürzungen: a+ ist aa*, a? ist »a oder nichts«.
Stephen Cole Kleene (1909–1994), Mathematiker in Madison, Wisconsin. Jedes * in einem regulären Ausdruck, bei grep oder in der Suche von VS Code, ist sein Stern.
1951 wollte er wissen, welche Muster ein Netz aus Nervenzellen erkennen kann, und erfand dafür die Bausteine, die heute reguläre Ausdrücke heißen, zwanzig Jahre bevor es grep gab. Er bewies auch, dass sie und endliche Automaten genau dasselbe können.
Foto: Harold N. Hone, um 1963, gemeinfrei (Wikimedia Commons)
Representation of Events in Nerve Nets and Finite Automata, Stephen C. Kleene, Forschungsbericht RM-704 der RAND Corporation, 1951; 1956 gedruckt im Buch Automata Studies, herausgegeben von Claude Shannon und John McCarthy. Hier stehen die regulären Ausdrücke zum ersten Mal, noch als regular events, mit dem Stern und dem Beweis, dass sie und endliche Automaten dieselben Sprachen beschreiben: frei bei RAND.
Die Kleenesche Hülle einer Sprache L, geschrieben L*, sind alle Wörter, die sich aus beliebig vielen Wörtern von L zusammensetzen lassen, auch aus keinem: Das leere Wort ε gehört immer dazu. Die positive Hülle L+ lässt das leere Zusammensetzen weg: mindestens ein Wort von L; L+ ist dasselbe wie L L*. Größere Ausdrücke werden aus diesen Bausteinen zusammengesetzt, von innen nach außen; für (a|b)*aa steckt der Baustein für a|b im Baustein für *, und danach kommen zwei a:
Fertig zusammengesetzt hat so ein Automat viele Zustände und ε-Übergänge. Kleiner geht es oft von Hand. Der Ausdruck a(a|b)*a passt auf die Wörter aus a und b, die mit einem a anfangen und mit einem a aufhören und mindestens zwei Zeichen haben. Als NEA: Das erste a führt nach q1, (a|b)* ist die Schleife in q1, und bei jedem a rät der Automat, ob es das letzte ist. Schalte durch und ändere das Wort:
Wie viele Zustände hat der kleinste DEA, der genau die Wörter aus fünf
Ziffern annimmt, also \d{5} auf das ganze Wort? Den Fehlerzustand
qF zählst du nicht mit.
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
Sechs: Der Automat muss nur wissen, wie viele Ziffern er schon gelesen hat, null bis fünf. Nach der fünften akzeptiert er, eine sechste führt in den Fehlerzustand qF, der wie immer nicht gezeichnet ist.
Darum ist es egal, wie lang das Logfile ist: Der Automat liest jedes Zeichen genau einmal und merkt sich nie mehr als seinen Zustand. So arbeitet grep im Prinzip; die Rechnung mit Mengen von Zuständen aus der Potenzmengenkonstruktion macht es, ohne zurückzugehen.
Es geht auch umgekehrt: Zu jedem endlichen Automaten gibt es einen regulären Ausdruck, der genau die Wörter beschreibt, die er annimmt. Beides zusammen hat Stephen Kleene 1951 bewiesen, dessen Kasten oben steht; es heißt heute Satz von Kleene. Reguläre Ausdrücke und endliche Automaten sind zwei Schreibweisen für dieselben Sprachen, die regulären Sprachen: Der Ausdruck ist leichter zu schreiben, der Automat leichter auszuführen.
Dieser Automat liest Binärzahlen:
Welcher Ausdruck passt auf genau die Wörter, die der Automat oben annimmt?
Ein Editor zeigt dir, ob eine Klammer in deinem Programm fehlt. Könnte er das mit einem regulären Ausdruck prüfen?
Welcher Ausdruck passt, auf das ganze Wort, genau auf die Wörter aus
richtig gesetzten runden Klammern: das leere Wort, (), (()), ()(),
(()()) und so weiter?
Hier geht es weiter, sobald du deine Antwort oben abgegeben hast.
Keiner kann es. Jeder reguläre Ausdruck wird zu einem endlichen Automaten, und der hat eine feste Zahl von Zuständen, sagen wir zehn. Liest er elf ( hintereinander, war er nach zwei verschiedenen Zahlen von Klammern im selben Zustand, sagen wir nach drei und nach sieben. Von da an weiß er nicht mehr, wie viele offen sind: Kommen jetzt drei ), macht er in beiden Fällen dasselbe. Er nimmt drei ( mit drei ) und sieben ( mit drei ) beide an oder beide nicht, aber nur das erste Wort stimmt. Ein * im Ausdruck ist eine Schleife im Automaten, und eine Schleife zählt nicht mit, wie oft sie durchlaufen wurde. Genau ausgeführt, mit dem Schubfachprinzip, steht diese Überlegung in Kellerautomaten: Dort bekommt der Automat einen Stack, und mit ihm kann er Klammern prüfen.
Ruby kann es trotzdem, mit einer Erweiterung: /\A(?<p>\(\g<p>*\))*\z/ nimmt (())() an und (() nicht. (?<p>…) gibt einer Gruppe einen Namen, und \g<p> setzt diese Gruppe an ihrer eigenen Stelle noch einmal ein: Der Ausdruck ruft sich selbst auf. Das ist kein regulärer Ausdruck mehr im Sinne Kleenes, sondern eine Regel, die sich selbst benutzt. Solche Regeln haben einen eigenen Namen, Grammatiken, und in einer davon ist es dieselbe Zeile: brackets = { "(" brackets ")" }.
Manche Programme können es trotzdem, mit einer Erweiterung: Das Modul regex, eine Erweiterung von re, kennt (?R), das den ganzen Ausdruck an seiner eigenen Stelle noch einmal einsetzt. Der Ausdruck ruft sich selbst auf. Das ist kein regulärer Ausdruck mehr im Sinne Kleenes, sondern eine Regel, die sich selbst benutzt. Solche Regeln haben einen eigenen Namen, Grammatiken, und in einer davon ist es eine einzige Zeile: brackets = { "(" brackets ")" }.
[0-9] ist eine Zeichenklasse, *, +, ? und {n} wiederholen, | heißt »oder«, Klammern fassen zusammen und bilden Gruppen, \ nimmt einem Sonderzeichen seine Bedeutung.grep oder =~. Prüfen heißt: Er passt auf den ganzen Text, mit \A und \z in Ruby oder re.fullmatch in Python.31.02.2026 sieht aus wie ein Datum. Wo die Regeln lang werden, wie bei E-Mail-Adressen, prüft man grob und lässt den Rest ein Programm tun.|, *, +, ? und Klammern zeichnet Automatron den NEA, den DEA und den kleinsten DEA, mit allen Schritten dazwischen.$1 für die erste Gruppe. Mehr dazu und die Links zum Nachschlagen stehen im Handbuch unter Reguläre Ausdrücke.Mastering Regular Expressions, Jeffrey E. F. Friedl, O'Reilly, 3. Auflage 2006, auch auf Deutsch erschienen. Das Buch erklärt, wie die Programme, die Ausdrücke ausführen, von innen arbeiten, warum manche Ausdrücke so viel langsamer sind als andere und wie man sie schneller schreibt, für Perl, Java, .NET, PHP und andere Sprachen. Es steht in vielen Bibliotheken; der Verlag hat es auf seiner Seite des Buchs.